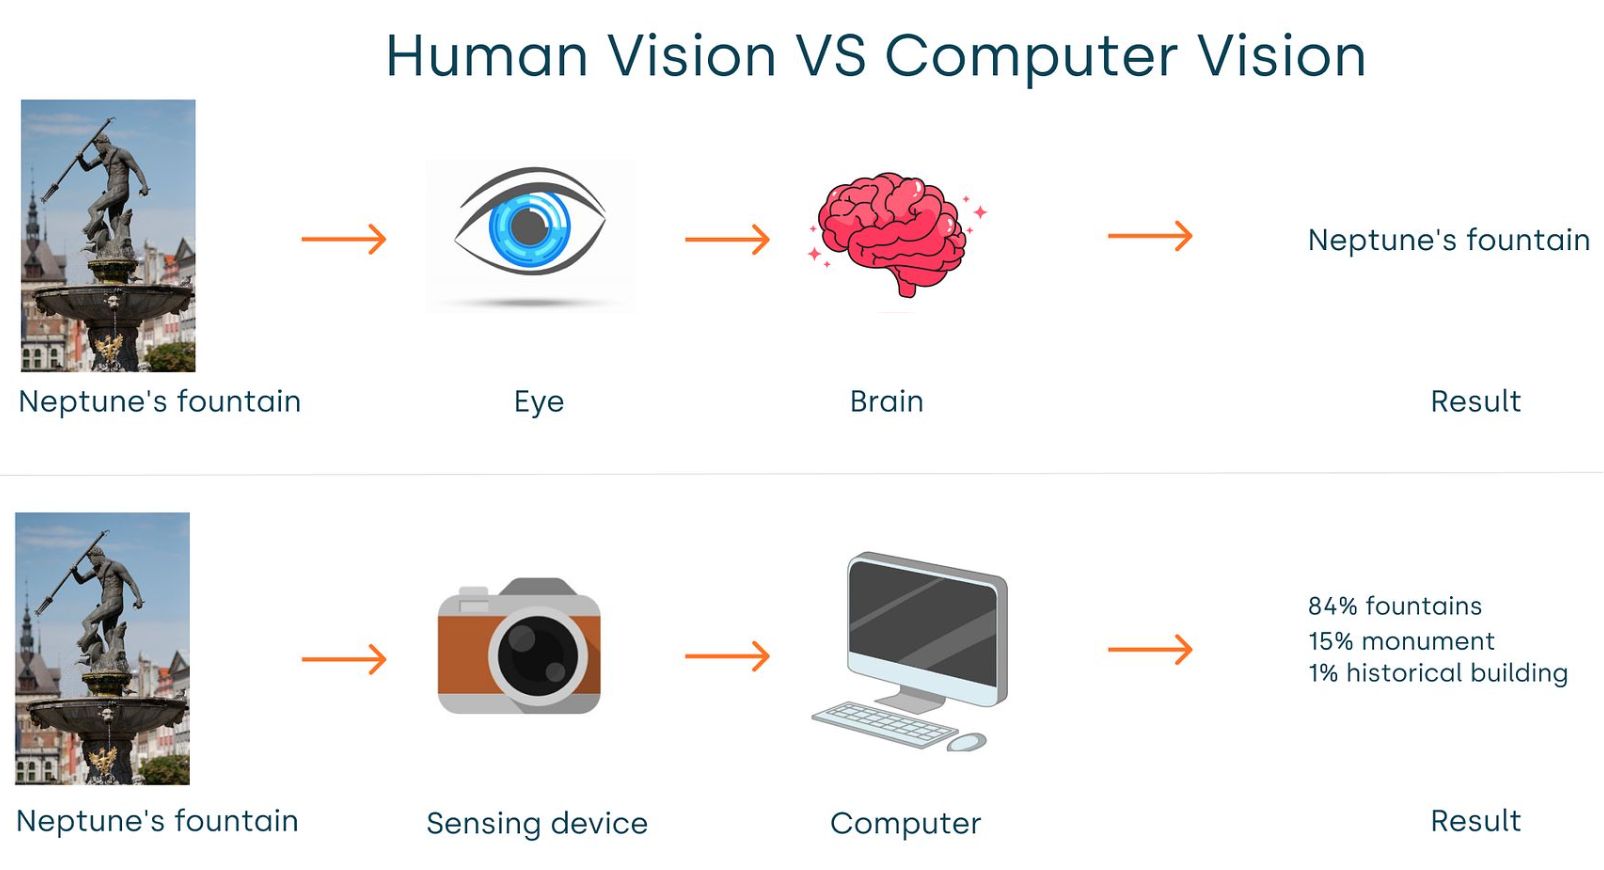
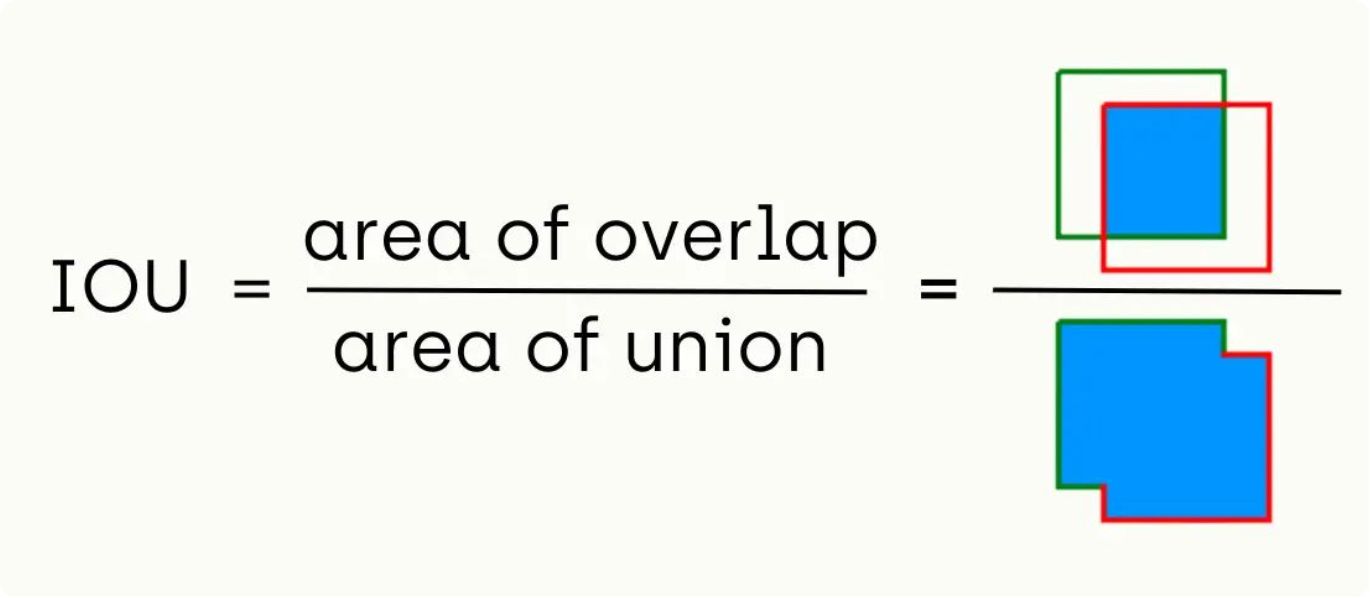La visión artificial es la disciplina de la inteligencia artificial que busca capacitar a las máquinas para extraer información significativa y comprender el mundo a partir de imágenes y vídeos digitales, imitando la percepción humana.
Inmediatamente identificamos "un gato naranja durmiendo en un sofá" y comprendemos su contexto.
Una máquina percibe una compleja matriz de millones de píxeles, cada uno con valores numéricos RGB como [255, 128, 64…].
Las imágenes digitales son matrices de píxeles. La visión artificial aprende representaciones que permiten asociar esos valores con objetos, relaciones o regiones.
Asigna una etiqueta a la imagen entera: dice qué hay, no dónde.
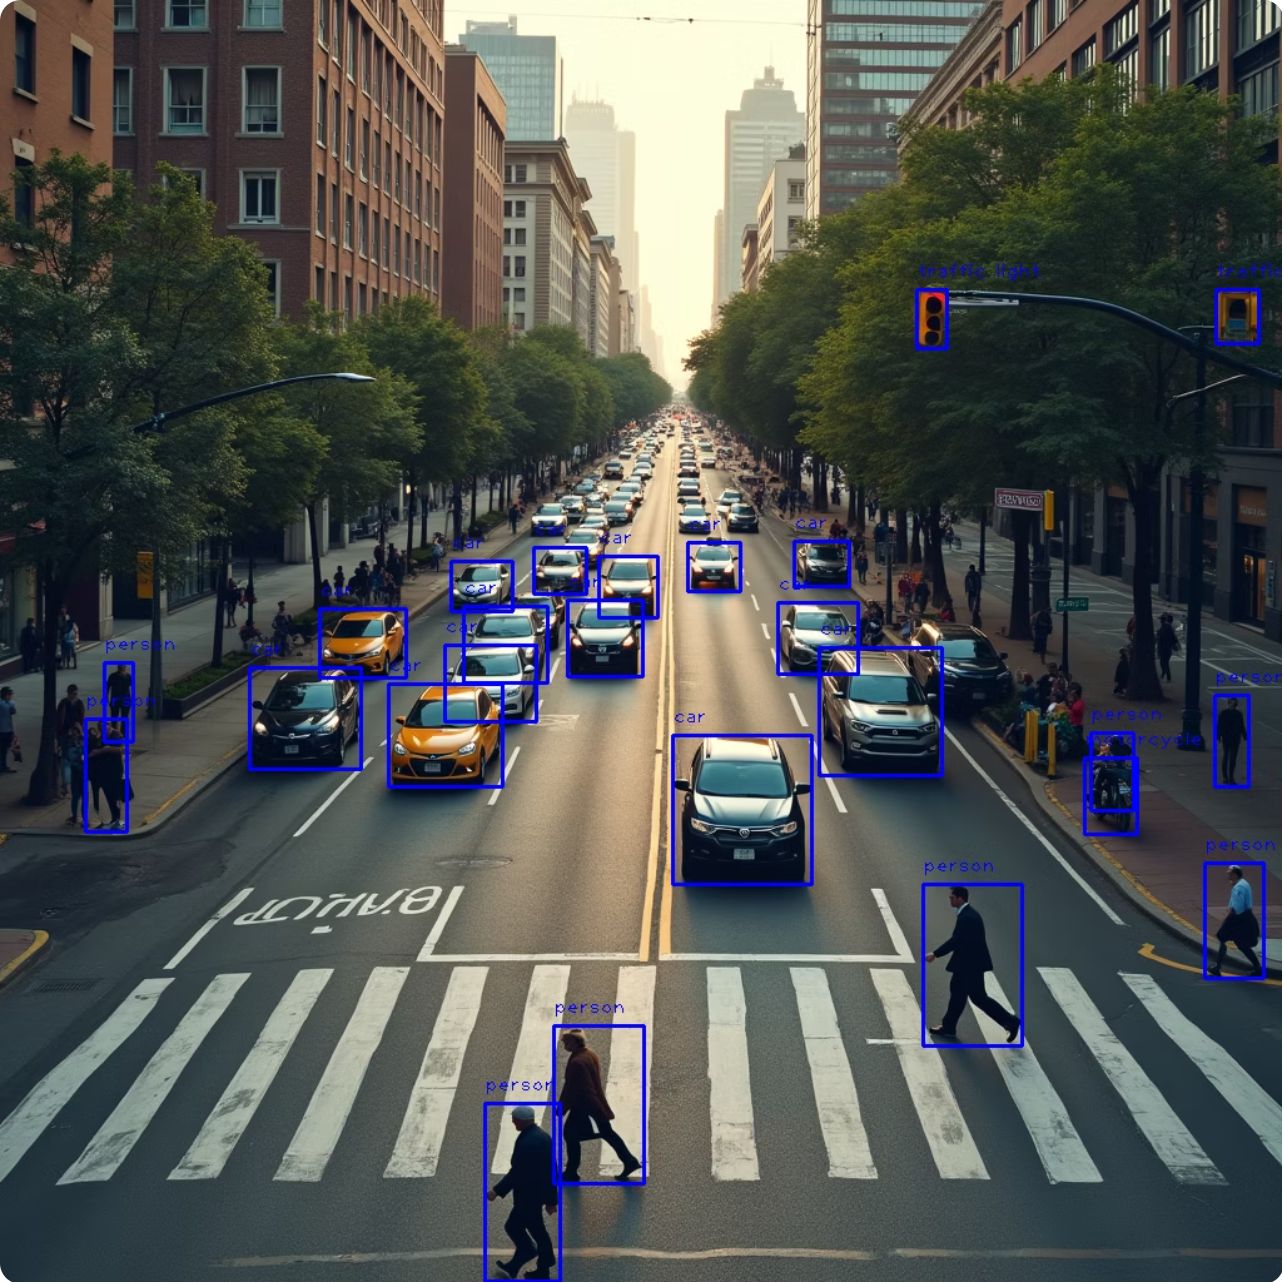
Encierra cada objeto en un recuadro delimitador y le asigna una clase.
Define el contorno exacto de cada objeto a nivel de píxel.
Identifica eventos o datos inusuales que no coinciden con un patrón esperado.
Localiza puntos clave (articulaciones) en personas o animales para comprender su postura.
OCR, estimación de profundidad, superresolución, keypoint matching…
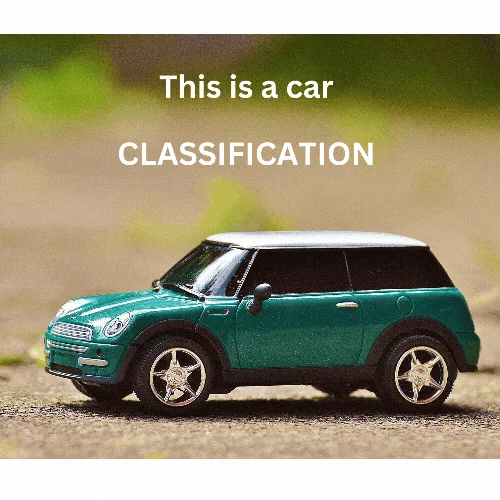
La misma imagen admite tareas distintas.
Respuesta B. Exacto: la detección localiza cada instancia y permite contarla.
La clasificación da una etiqueta global. La detección devuelve cajas y categorías por instancia. La segmentación delimita píxeles. Otros problemas incluyen anomalías, pose, OCR, profundidad y superresolución.
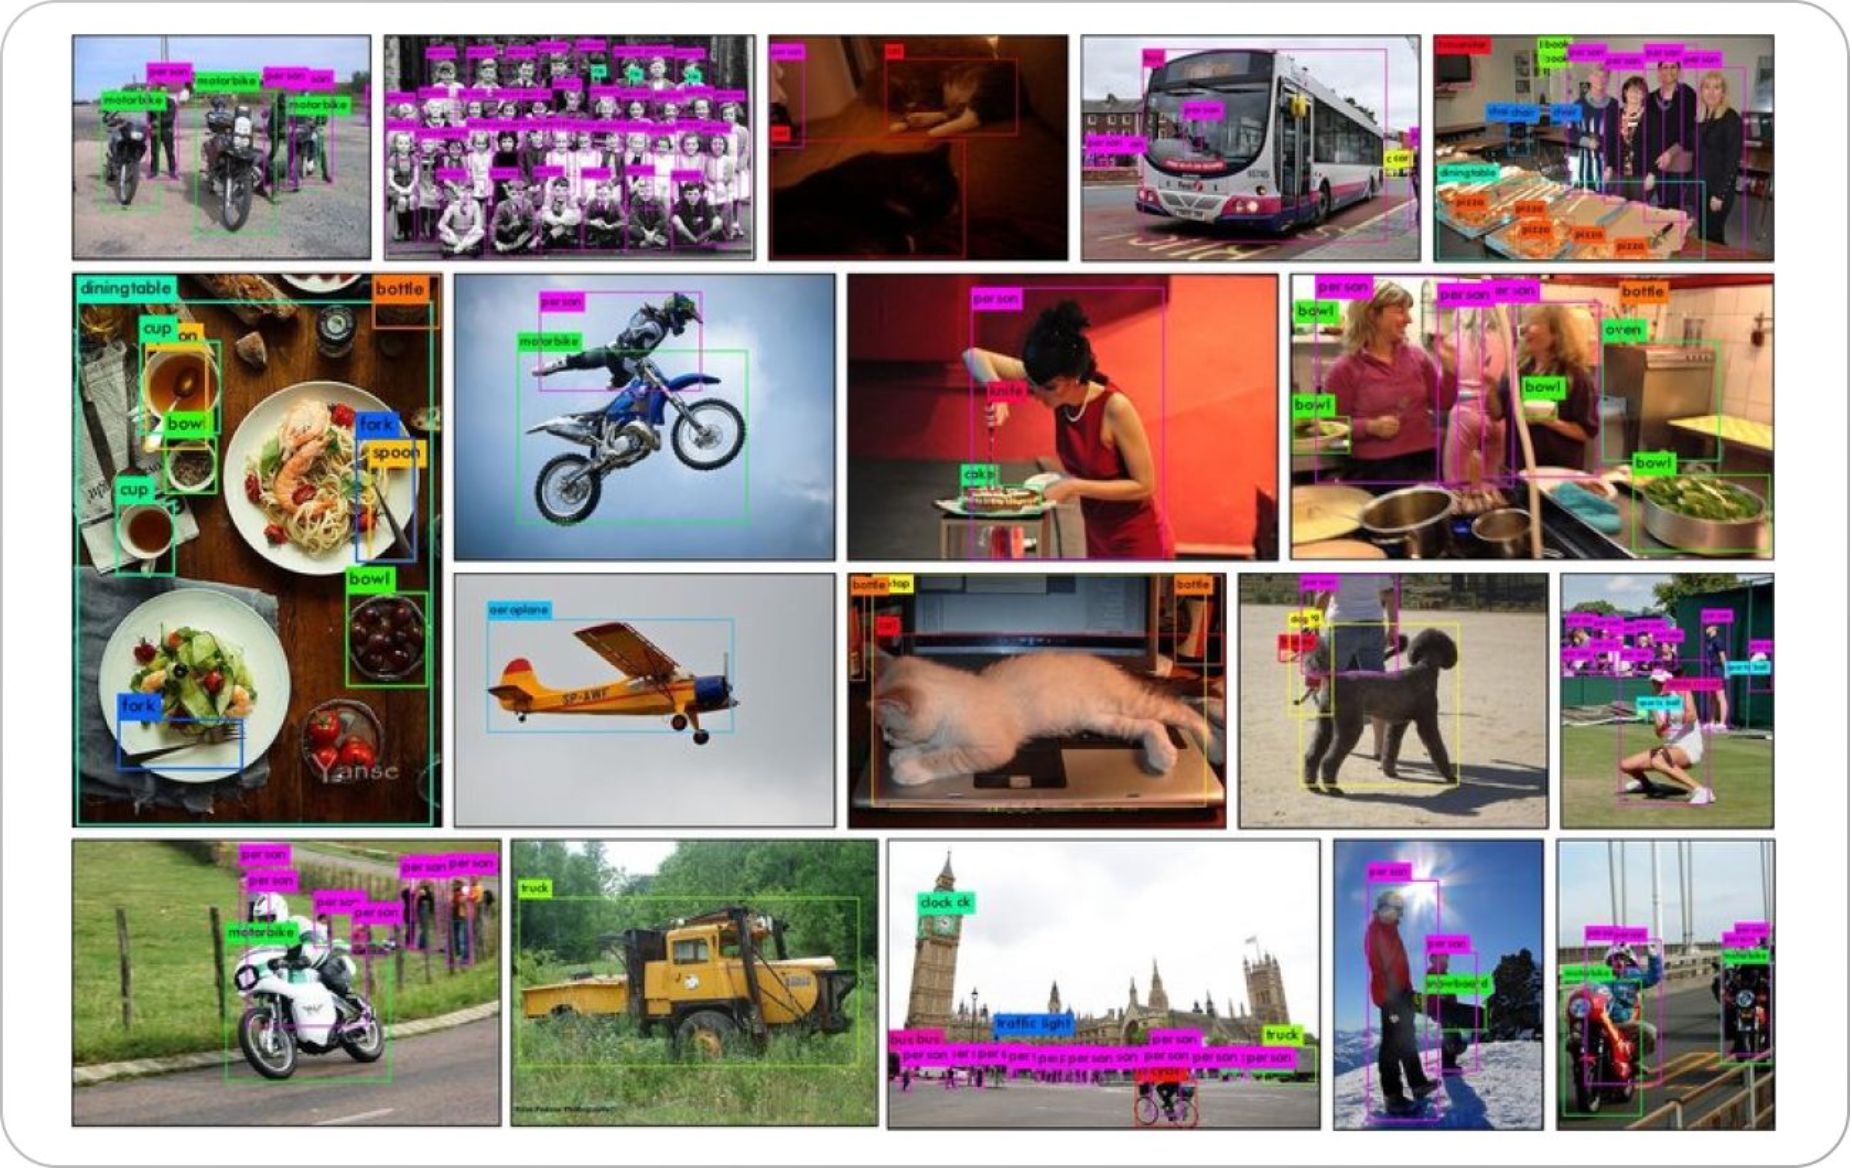
La detección de objetos va más allá de la simple clasificación. Su objetivo principal es localizar y clasificar múltiples objetos simultáneamente dentro de una imagen, proporcionando para cada uno una caja delimitadora, su categoría y una puntuación de confianza.
En qué se diferencia de las otras tareas:
Hay muchos detectores. Se agrupan por la red que usan y por cómo sacan las cajas.
Tres etapas en diez años.
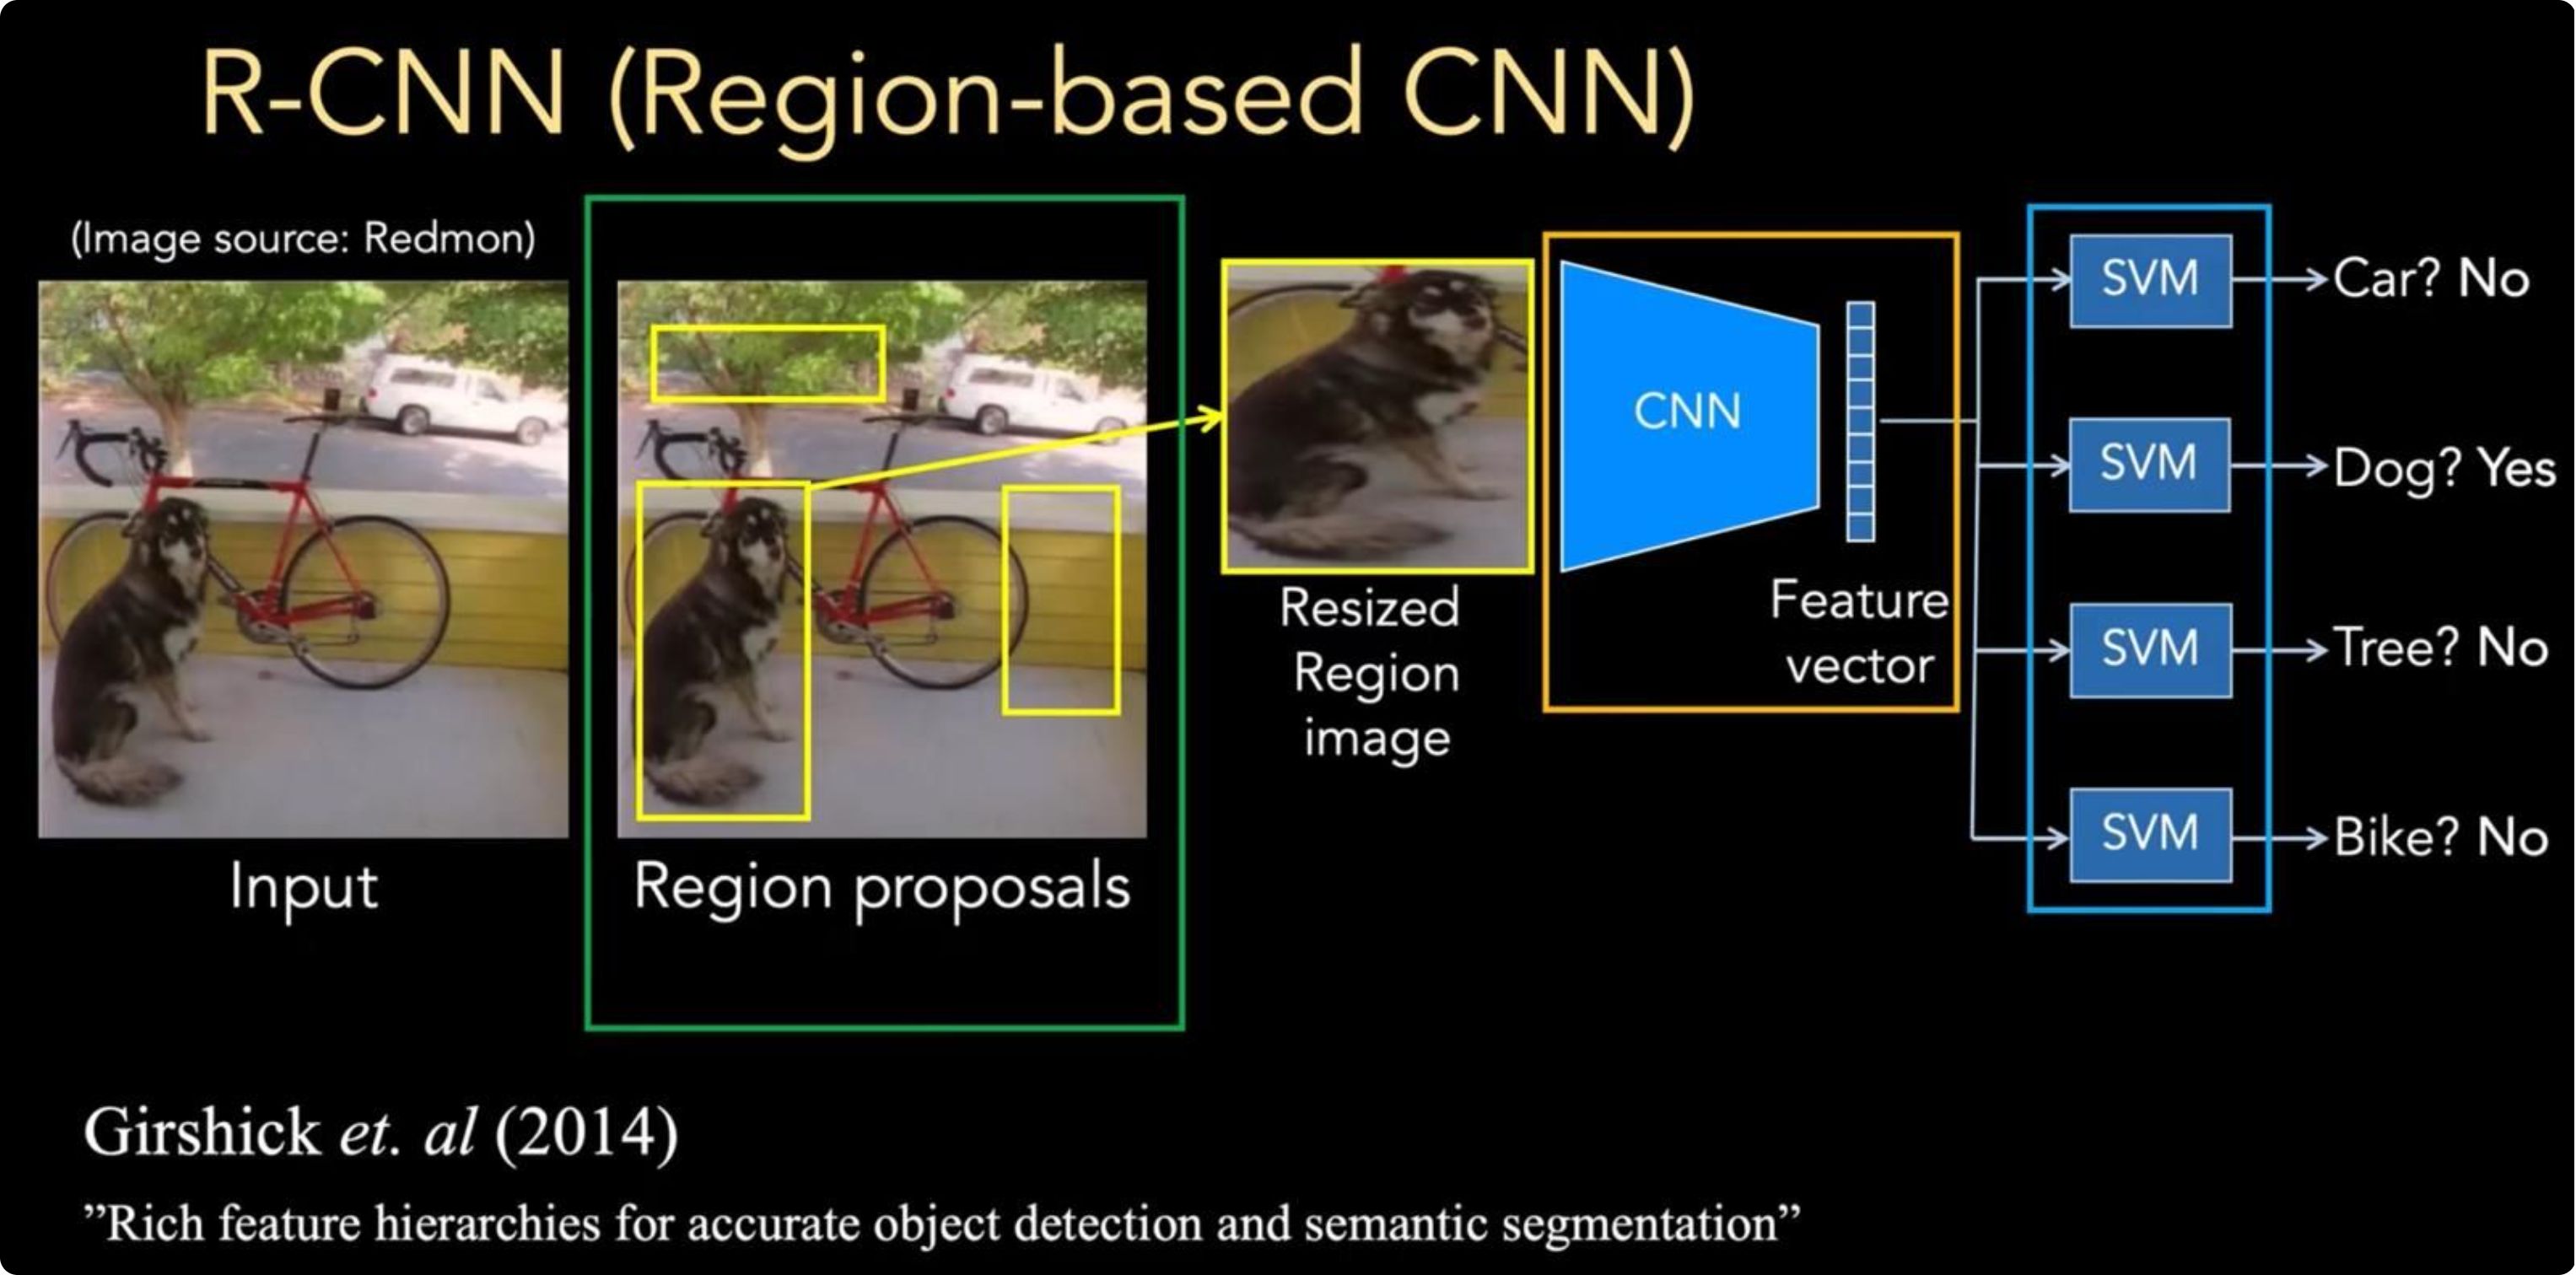
R-CNN, Fast R-CNN, Faster R-CNN: arquitecturas de dos etapas que primero proponen regiones candidatas y luego las clasifican. Precisos pero complejos y lentos.
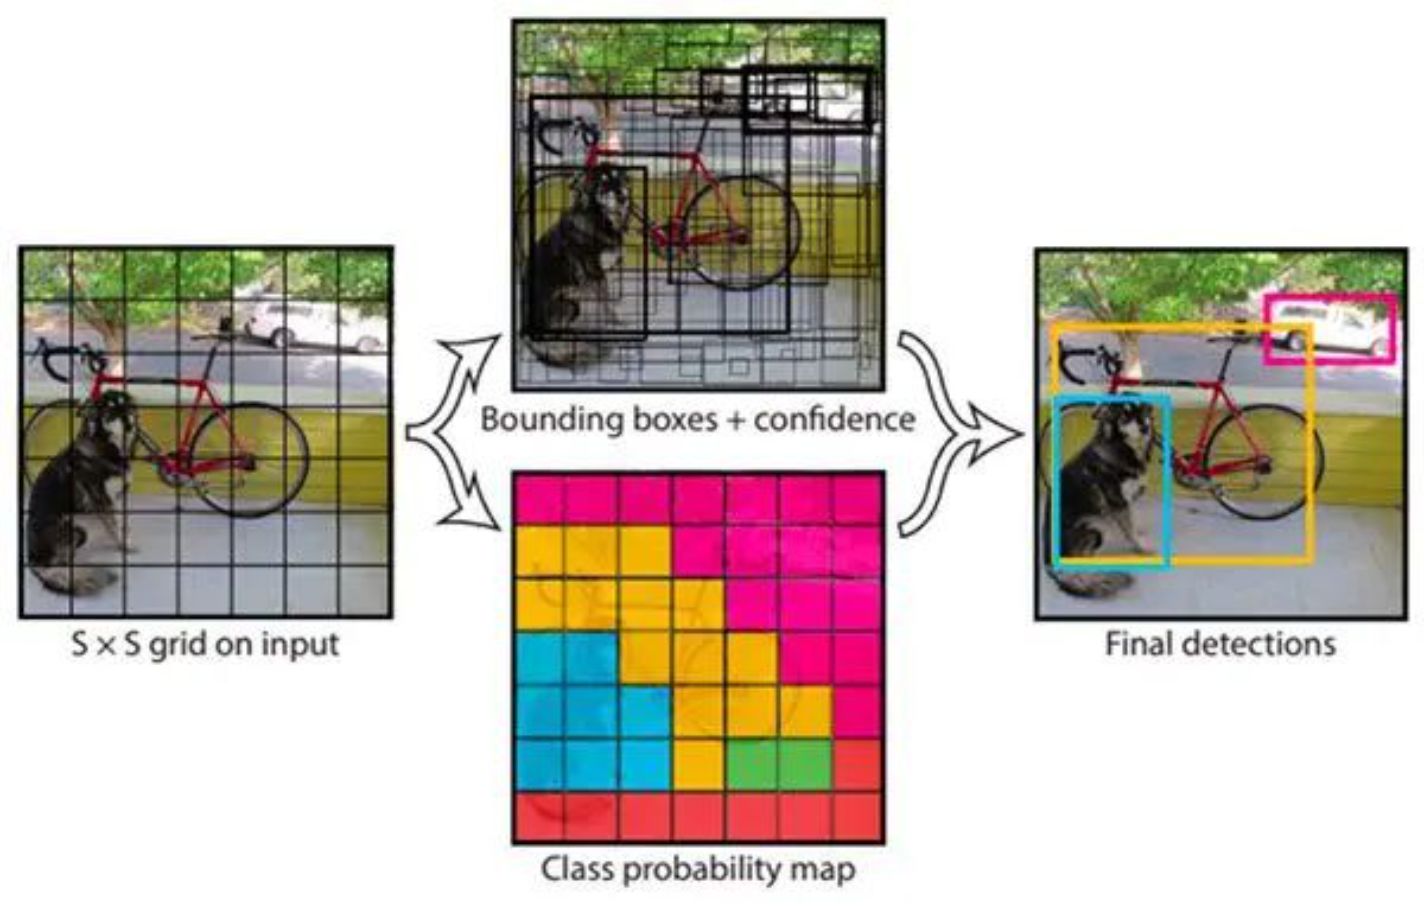
YOLO cambia el planteamiento: una sola red neuronal procesa la imagen completa en tiempo real, prediciendo cajas y clases simultáneamente mediante una cuadrícula.
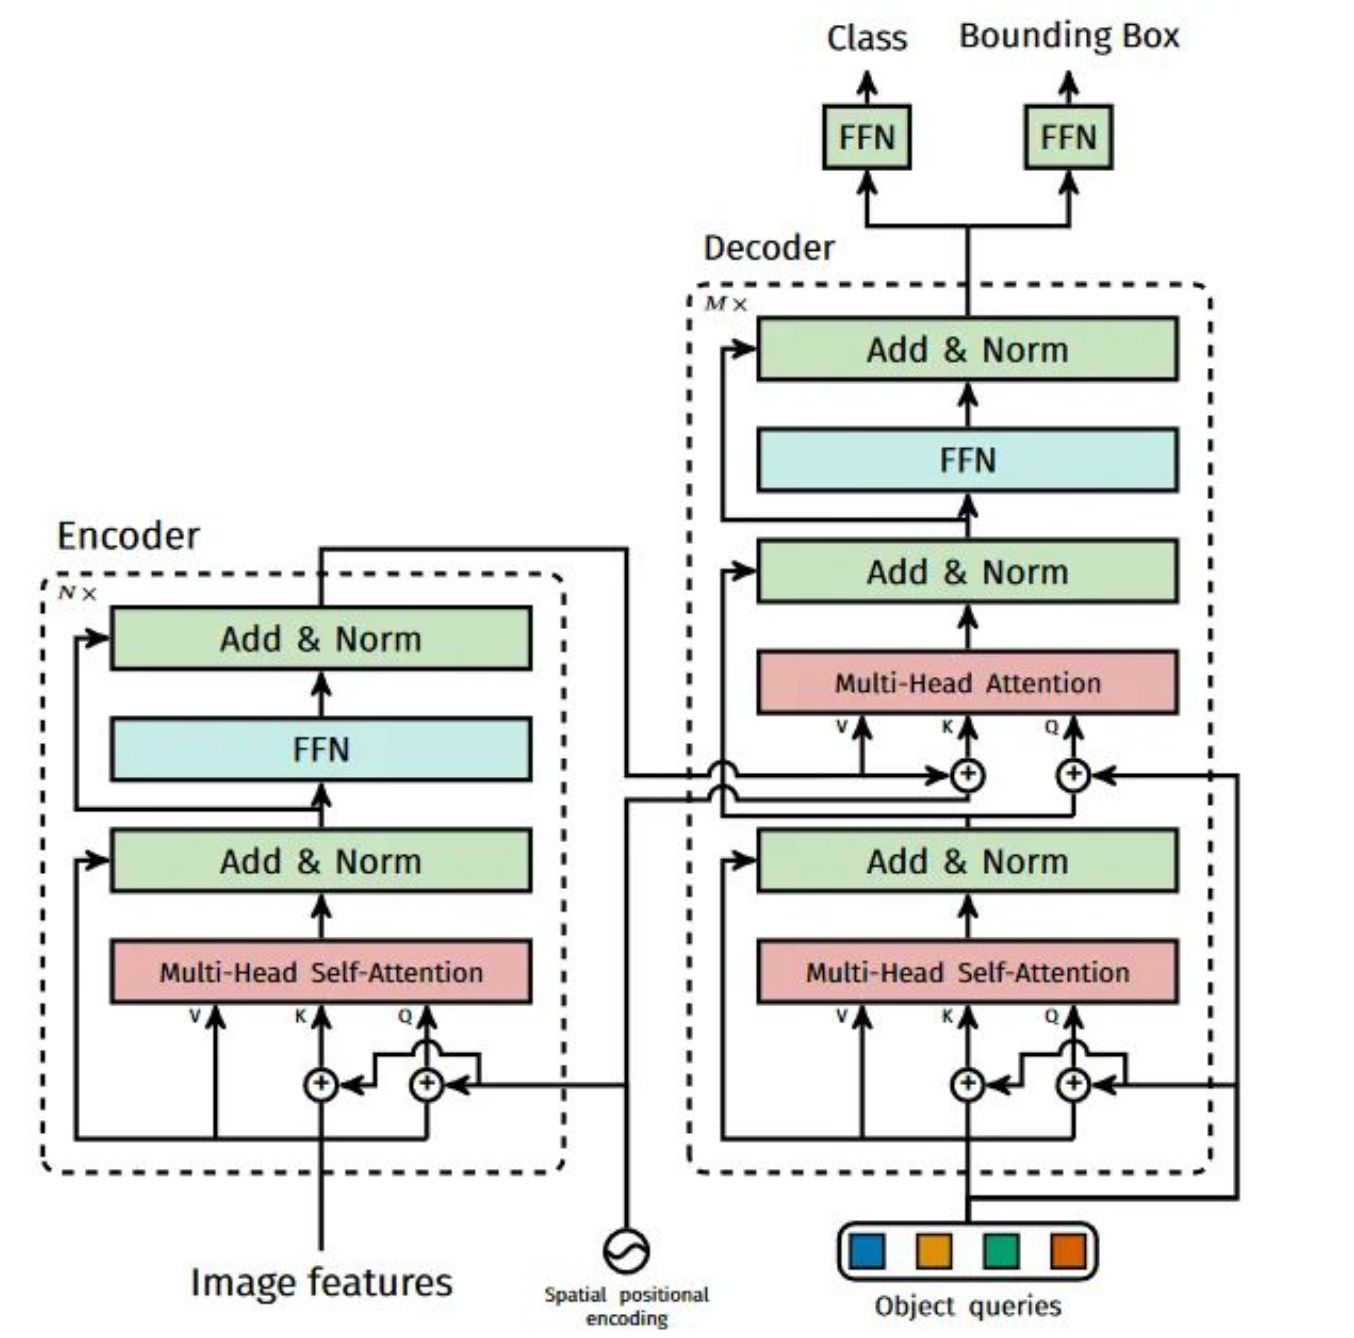
DETR y RF-DETR: pipelines limpios basados en atención, sin anchors predefinidos ni supresión de no máximos (NMS). Arquitectura más simple y generalizable.
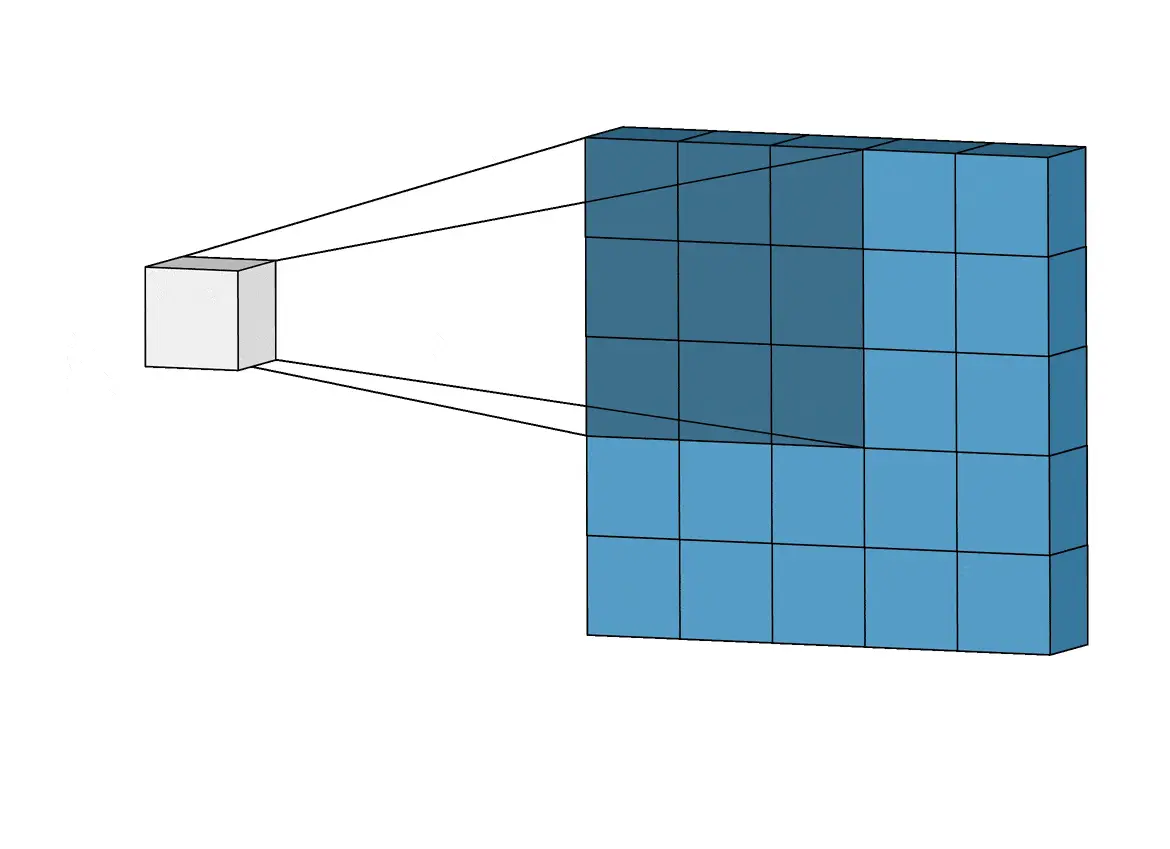
Las redes neuronales convolucionales (CNN) son la base de casi todos los detectores anteriores a 2020 y siguen dentro de muchos actuales. Procesan la imagen directamente con capas que detectan, de forma jerárquica, bordes, texturas y patrones cada vez más complejos.
Al apilar capas, la red pasa de detectar bordes a reconocer partes de objetos y objetos enteros, sin que nadie programe esas características a mano.
Las CNN incorporan localidad e invariancia aproximada a traslaciones. Siguen dentro de muchos detectores actuales, y una CNN también capta contexto global si se le añaden capas de atención o un campo receptivo grande.
Un filtro de 3 × 3 recorre la imagen: cada píxel de salida es la suma del píxel y sus ocho vecinos, cada uno multiplicado por su peso. Cambia el filtro y mira qué se enciende; toca o pasa el ratón por las imágenes para ver la cuenta.
Se encienden los cambios de luz de izquierda a derecha: las aristas verticales de los edificios. El cielo, liso, queda negro. Un número negativo también se pinta claro: es el mismo borde, de claro a oscuro.
Filtros escritos a mano y calculados en tu navegador. Una CNN aprende sus pesos durante el entrenamiento, y los de su primera capa acaban pareciéndose a estos.
Esta página recoge el filtro de bordes verticales: pesos negativos a la izquierda y positivos a la derecha, de modo que la suma es grande donde la luz cambia en horizontal y cero en las zonas lisas. En el punto marcado, sobre una arista del edificio de la izquierda, la salida vale 419. El filtro de bordes horizontales es el mismo girado 90 grados y enciende cornisas y filas de ventanas. El desenfoque promedia los vecinos y el realce resta los vecinos al centro. Una capa convolucional aplica decenas de filtros como estos a la vez, y las capas siguientes combinan sus mapas para detectar texturas, partes y objetos.
Primero buscan dónde puede haber un objeto; después miran cada zona y deciden qué es.
Unas 2.000 zonas por imagen, y la CNN pasa por cada una. Muy lento.
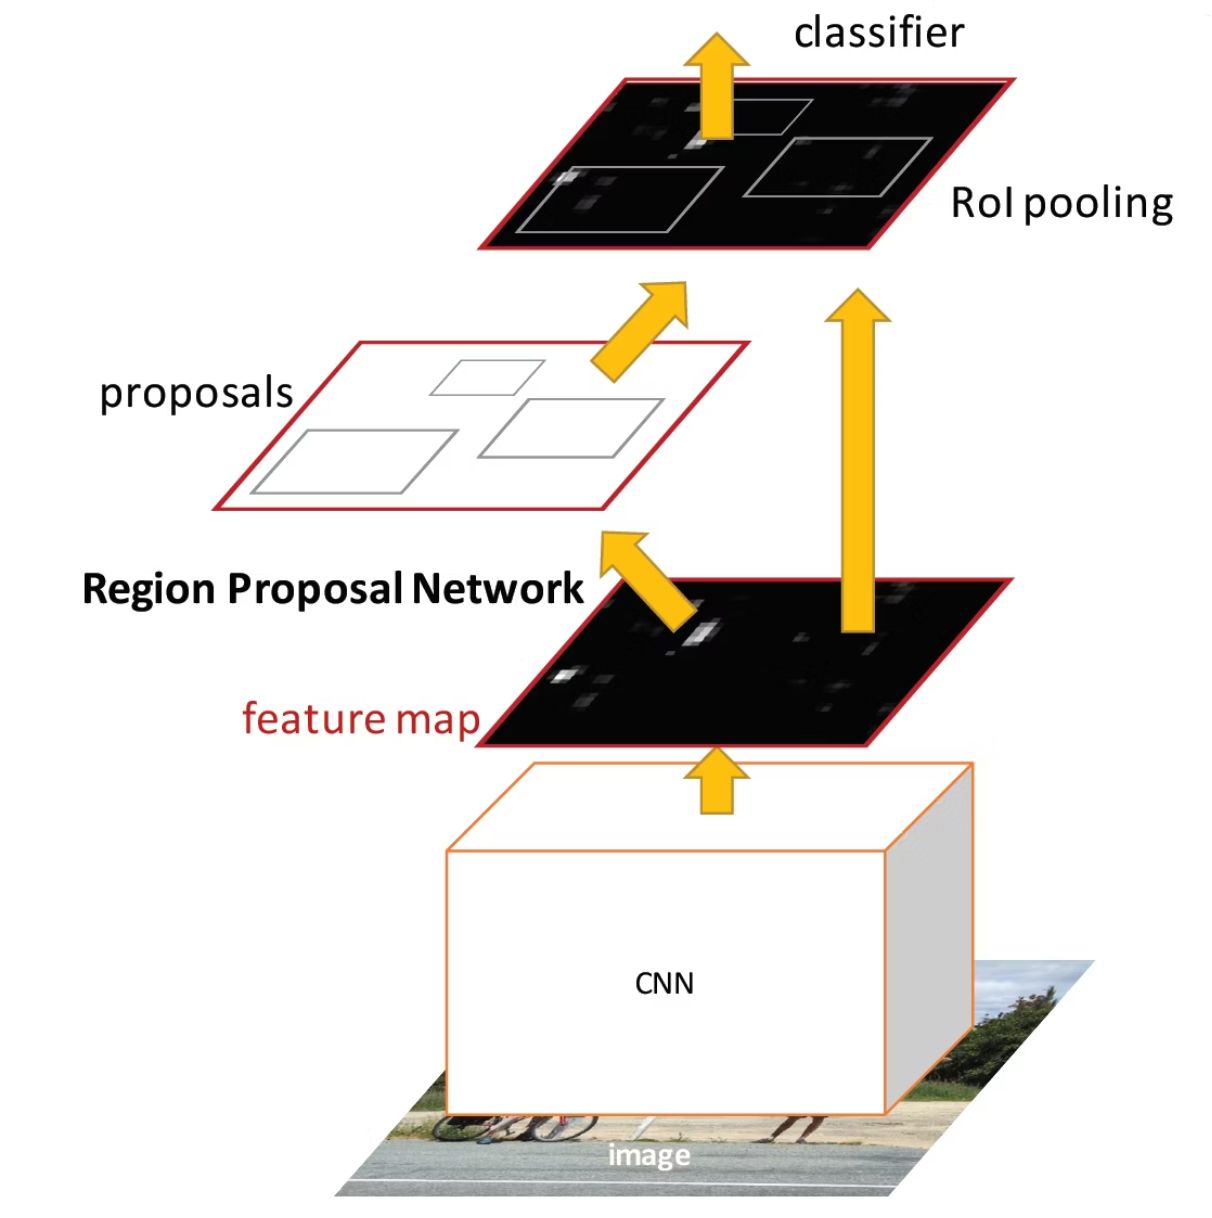
La CNN pasa una sola vez por la imagen entera, y cada zona se recorta sobre lo que sale.
Las zonas ya no las propone un algoritmo clásico, sino una red:
Muy preciso, pero lento para vídeo.
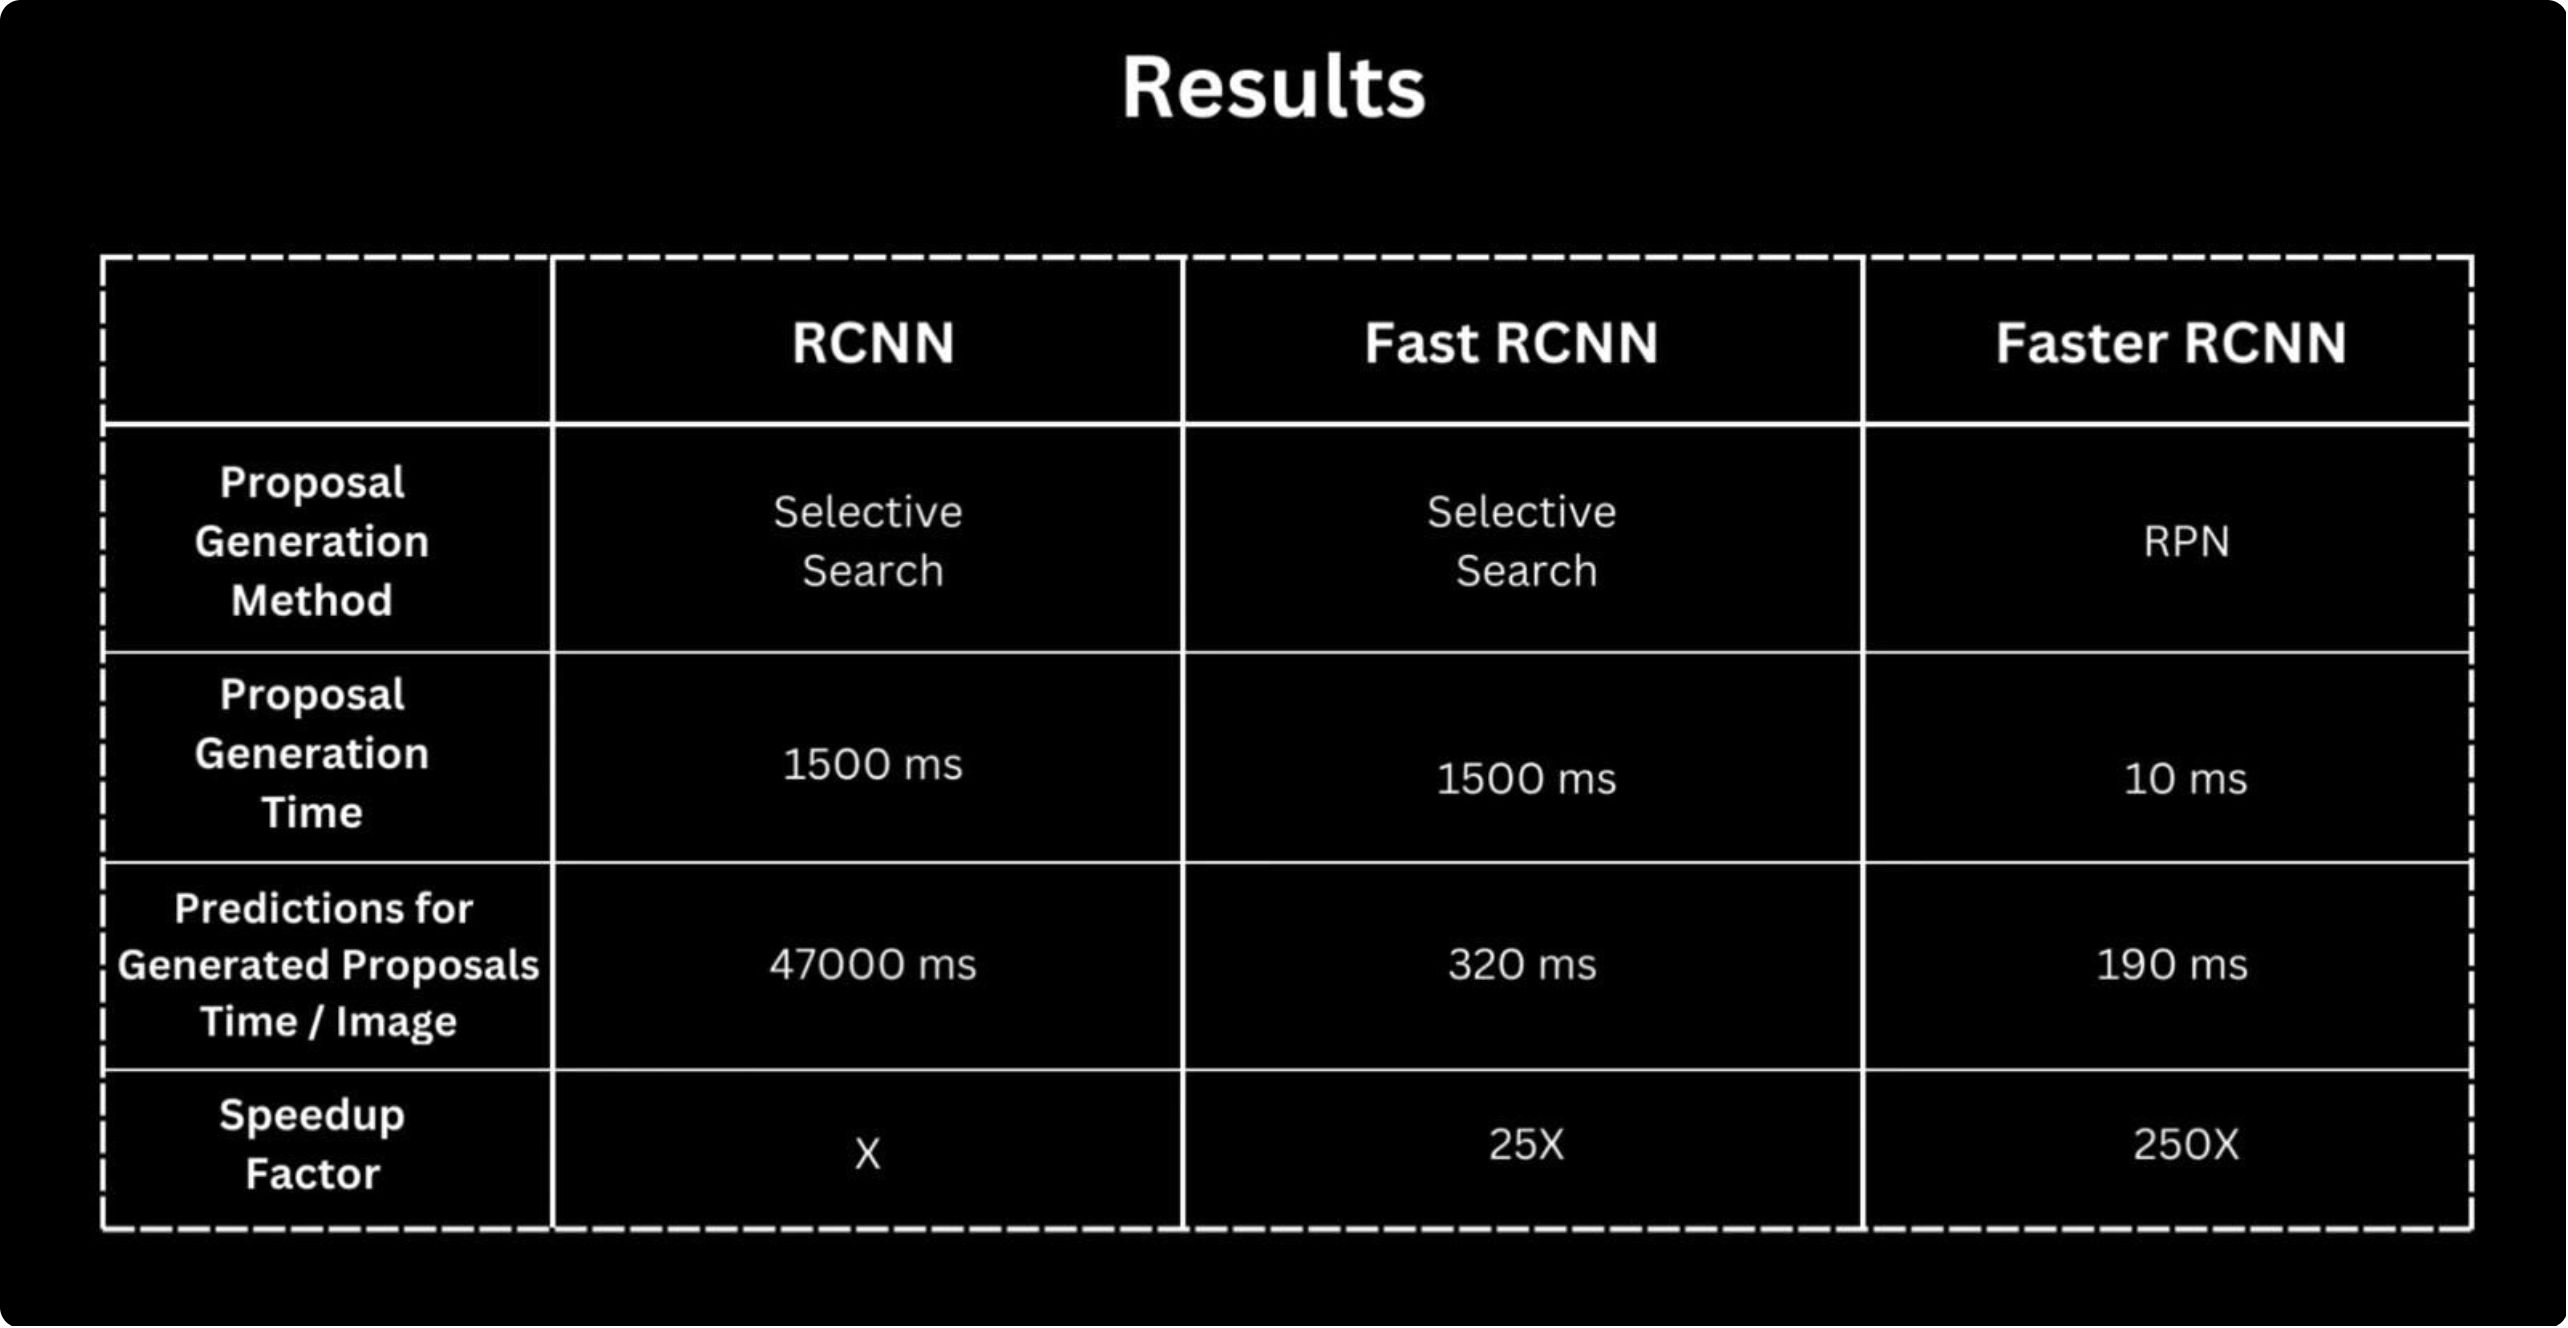
La tabla compara tres generaciones. Método de propuestas: Selective Search en RCNN y Fast RCNN, RPN en Faster RCNN. Tiempo de generación: 1500 ms, 1500 ms y 10 ms. Predicción sobre las propuestas por imagen: 47000 ms, 320 ms y 190 ms. Factor de aceleración: 1×, 25× y 250×.
La red mira la imagen una vez y devuelve todas las cajas a la vez, sin buscar zonas antes.
YOLO (You Only Look Once) reformula la detección como un problema de regresión único. La imagen se divide en una cuadrícula S×S, donde cada celda predice directamente las cajas delimitadoras y las probabilidades de clase de los objetos cuyo centro cae en ella.
La ventaja: una única pasada hacia adelante por la red permite velocidades de procesamiento en tiempo real (30+ FPS), manteniendo precisión competitiva. Esta arquitectura one-stage elimina la necesidad de generar propuestas de región por separado.
Comprueba en qué se diferencia un detector de una etapa.
Respuesta C. Exacto: esa es la idea central, aunque los detalles cambian entre versiones.
Un detector de una etapa predice cajas y clases en una única pasada sobre toda la imagen, sin una fase previa que proponga regiones candidatas.
Diez años de versiones publicadas por grupos distintos. El número no indica quién hizo cada modelo ni que herede el código del anterior.
Por qué se pasó de las CNN a los transformers en detección.
Cada filtro ve un trozo pequeño de la imagen. Para relacionar cosas alejadas hacen falta muchas capas.
Los detectores con CNN suelen necesitar NMS y otros ajustes que se eligen a mano.
La atención relaciona toda la imagen desde el principio, y DETR prescinde del NMS.
El detector propone varias cajas por coche. El NMS se queda con la de mayor puntuación y borra las que se solapan con ella por encima del umbral. Baja el umbral y desaparece un coche entero; súbelo y vuelven los duplicados.
Cinco cajas candidatas sobre dos coches. El detector las propone todas antes de filtrar.
Cajas que quedan2
Suprimidas3
Una caja por coche: el umbral limpia los duplicados sin borrar objetos.
Esta página recoge el estado con umbral 0,50. El algoritmo recorre las cajas de mayor a menor puntuación: cada superviviente suprime a las que solapan con ella por encima del umbral. Con 0,20 la caja del primer coche llega a suprimir la del segundo, porque su IoU es 0,25, y se pierde un objeto real. Con 0,80 no se suprime nada y quedan las cinco cajas. No hay un valor universalmente correcto: depende de cuánto se solapen los objetos del dominio, y por eso DETR y RF-DETR se entrenan para no necesitarlo.
Devuelve directamente una lista fija de objetos. Lo que sobra dice "aquí no hay nada".
DETR (Facebook, 2020) usa un transformer y devuelve directamente la lista de objetos.
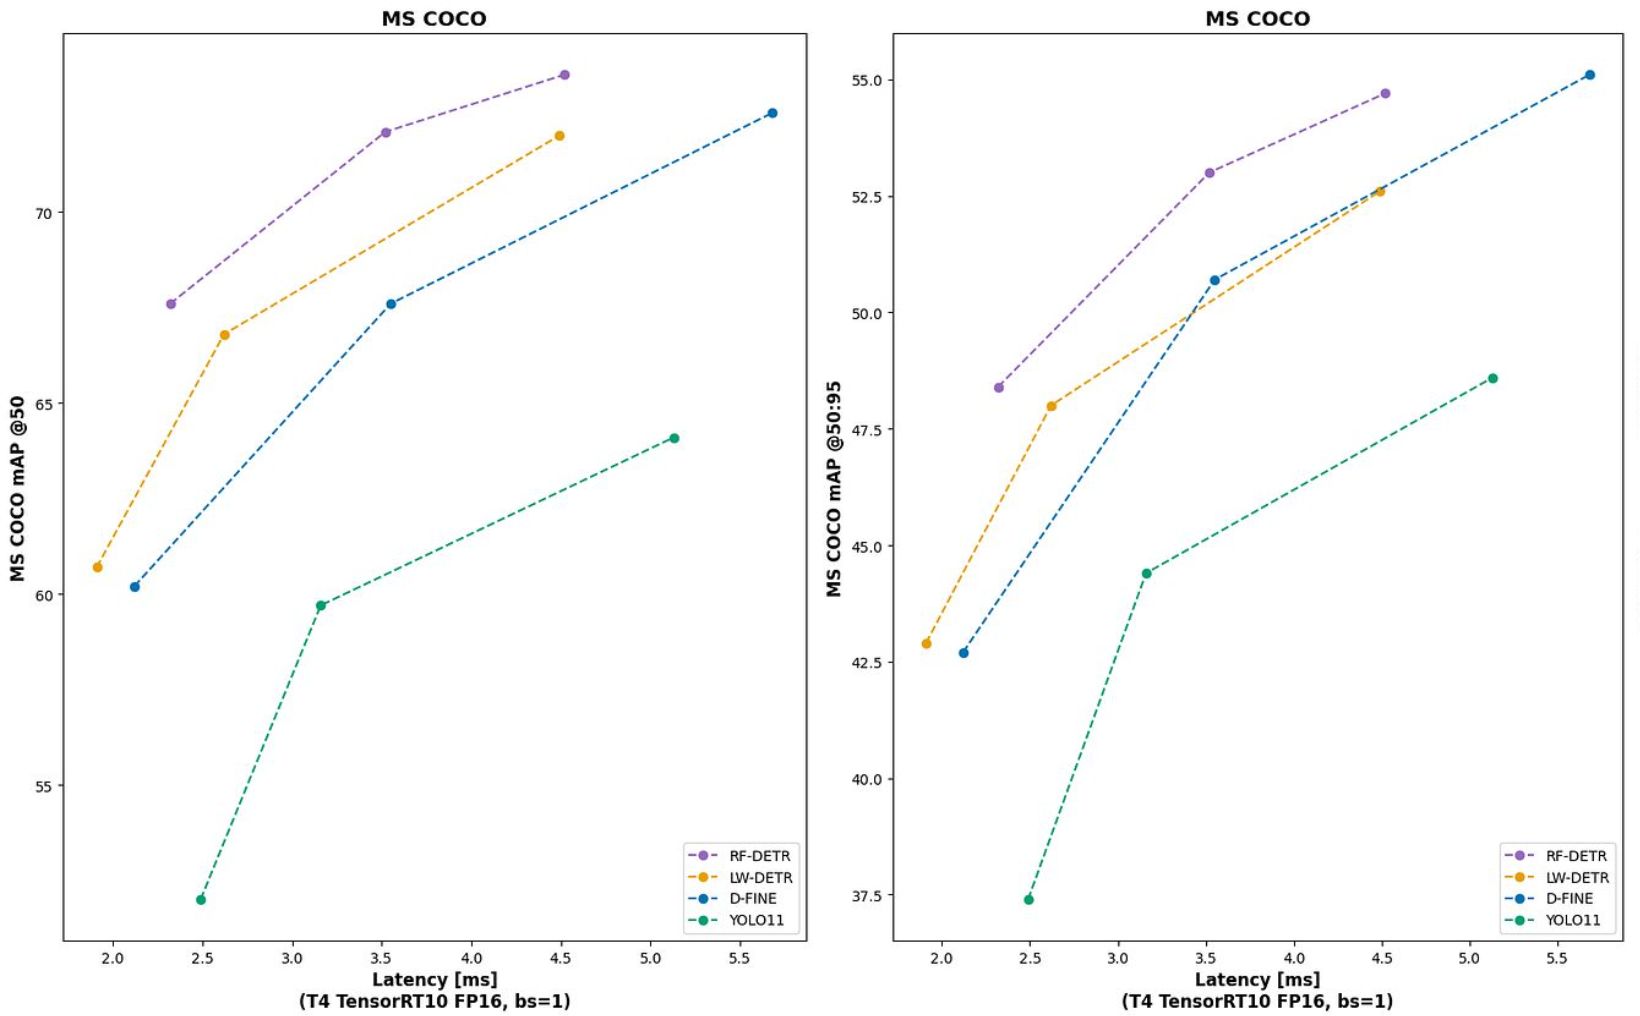
RF-DETR (Roboflow, 2025; publicado en ICLR 2026) es un detector en tiempo real de la familia DETR. Su versión 2XL fue el primer detector en tiempo real en pasar de 60 AP en COCO, y la nano da 48,0 AP, 5,3 más que D-FINE nano con una latencia parecida.
Parte de un vision transformer entrenado sin etiquetas sobre millones de imágenes (tema 4). Por eso se adapta rápido a un dominio nuevo con pocos datos.
En lugar de mirar todos los píxeles, el decoder consulta unos pocos puntos de muestreo en cada escala. Así trabaja con mapas de alta resolución sin disparar el coste, lo que ayuda con los objetos pequeños.
Como todo DETR, no necesita anchors predefinidos ni supresión de no máximos. Una búsqueda de arquitectura (NAS) entrena una sola red y saca de ella versiones de nano a 2XL sin reentrenar.
Ultralytics es muy popular, pero este curso necesita código abierto que se pueda leer por dentro y con licencias que no limiten ni la investigación ni el uso industrial.
Código y pesos van con AGPL-3.0, que obliga a publicar el código de la aplicación que los incorpora cuando la distribuyes, y también cuando solo la ofreces como servicio en red. Para evitarlo hay que pagar su licencia comercial. AGPL es open source, pero choca con la mayoría de usos industriales.
Sus versiones (YOLOv5, YOLOv8, YOLO11 y YOLO26) se presentan como la continuación de YOLO, pero no vienen de Joseph Redmon ni de la línea académica que siguió su trabajo. Como otros grupos numeran también sus YOLO (v6, v7, v9, v10, v12), el número ya no dice de dónde sale cada modelo.
Está pensado para usarse a través de su CLI y de su API de alto nivel. Estudiarlo por dentro o adaptarlo a un proyecto de investigación cuesta bastante más.
Varias versiones salieron sin un paper que describa la arquitectura y los experimentos, lo que dificulta reproducir resultados y explicarlos en clase.
Las condiciones de licencia se revisan por versión y por artefacto: el código y los pesos pueden tener términos distintos y cambiar entre versiones. Conviene comprobar la licencia vigente del repositorio y del checkpoint concreto antes de decidir.
RF-DETR es el detector de referencia del curso: su arquitectura es moderna y legible, y el proyecto es open source con licencia Apache 2.0.
Permite usarlo, modificarlo y venderlo en industria, investigación y enseñanza, sin obligación de publicar tu código.
Es un DETR: backbone, decoder y salida directa, sin anchors ni NMS. Entenderlo es entender cómo se construyen los detectores actuales.
Se lee y se modifica bien, y el mismo paquete sirve para inferir y para reentrenar con tus datos.
A igual latencia en una T4, da más mAP en COCO que YOLO11 según las curvas de su repositorio (siguiente pantalla).
La elección entre RF-DETR y YOLO depende de tus prioridades específicas de producción.
Consideraciones prácticas:
Las curvas proceden del repositorio de RF-DETR y se miden en un hardware concreto. Antes de decidir conviene reproducir la medida en el dispositivo de destino, con el tamaño de entrada, la precisión numérica y el tamaño de lote que se vayan a usar realmente.
Un vídeo normal va a 25 o 30 fotogramas por segundo (FPS). Para seguirlo en directo, todo el trabajo de un fotograma tiene que caber en 40 milisegundos a 25 FPS, o en 33 a 30 FPS.
FPS es 1 entre el tiempo por fotograma. Se mide con un fotograma cada vez, tras unas pasadas de calentamiento y contando todo: leer, preparar la imagen, el modelo, el posproceso y el dibujo.
Exportar el modelo a ONNX y optimizarlo para el hardware: TensorRT en GPU de NVIDIA, OpenVINO en procesadores de Intel. Así están medidas las curvas de la pantalla anterior.
Junto a la cámara, en un NVIDIA Jetson por ejemplo, se usan las versiones pequeñas y la exportación optimizada. La cifra que vale es la medida en ese equipo, no la del portátil.
En el ejercicio de vídeo del cuaderno 1, RF-DETR medium procesa 200 fotogramas de 960 × 540 a unos 25 FPS en una RTX 3080 Ti de portátil, contando el proceso entero; una T4 de Colab va más despacio. Las versiones small y nano son más rápidas y algo menos precisas. Para decidir, se mide en el dispositivo de destino con la resolución, la precisión numérica y el tamaño de lote reales.
La Intersection over Union (IoU) mide cuánto se solapan dos cajas delimitadoras: la que predice el modelo y la caja de verdad (ground truth) anotada a mano. Es lo que decide si una predicción cuenta como acierto (True Positive) o como falsa alarma (False Positive). Va de 0, sin solapamiento, a 1, cajas idénticas.
En la figura, la caja predicha está en rojo y la de verdad en verde. La IoU divide el área donde se superponen entre el área total que cubren las dos juntas.
IoU0,33
Por debajo de 0,5: contaría como falsa alarma (FP).
IoU vale 1 cuando ambas cajas coinciden y 0 cuando no comparten área. Para contar un acierto también tiene que coincidir la clase, y cada objeto real solo puede dar un acierto.
Detecciones correctas: cajas predichas que coinciden con objetos reales (IoU > umbral).
Falsas alarmas: cajas predichas donde no hay objeto real o con IoU por debajo del umbral.
Objetos perdidos: objetos reales que el modelo no detectó.
La métrica de True Negatives, común en problemas de clasificación binaria, no aplica de la misma manera en la detección de objetos:
Por esta razón, las métricas en detección de objetos se enfocan únicamente en TP, FP y FN, que son los únicos resultados que se pueden contar.
Saber si el modelo ha detectado algo no basta. La precisión dice cuánto puedes fiarte de lo que detecta; el recall, cuánto de lo que hay consigue encontrar.
Mide la fiabilidad de las detecciones: con alta precisión hay pocos falsos positivos (detectar algo que no está o confundir su clase). Importa cuando una falsa alarma sale cara, como al contar inventario o cuando cada aviso obliga a parar una línea.
Precisión = TPTP + FP
Responde a: "De todas mis predicciones, ¿cuántas son correctas?".
Mide la capacidad de encontrar todos los objetos: con alto recall hay pocos falsos negativos (objetos presentes que no se detectan). Importa cuando perder uno es grave, como una persona en vigilancia o un tumor en imagen médica.
Recall = TPTP + FN
Responde a: "De todos los objetos reales, ¿cuántos he detectado?".
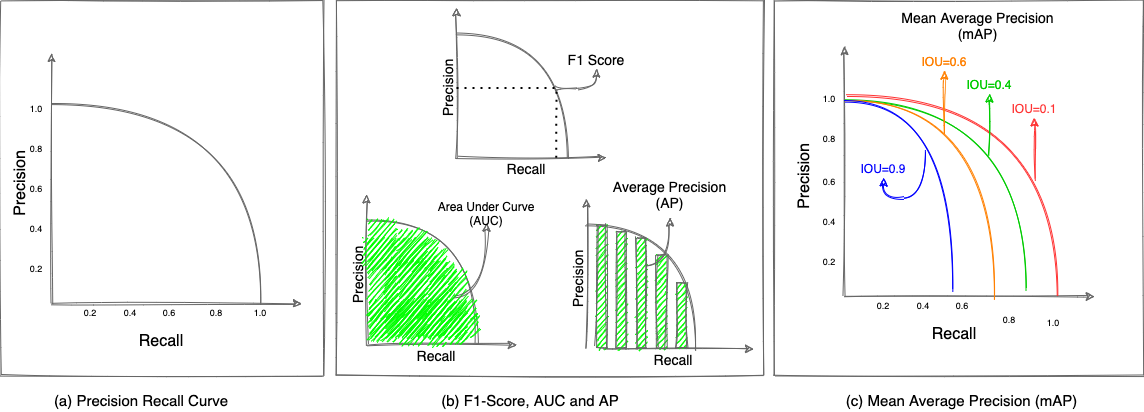
Cómo se leen:
Las dos suelen tirar en direcciones opuestas, un trade-off, aunque la precisión no siempre sube al filtrar. Un modelo que detecta con mucha manga ancha para no perderse nada (recall alto) también da más falsas alarmas (precisión baja). El punto de equilibrio lo decide la aplicación.
Aplica las dos fórmulas a un recuento concreto.
Respuesta A. Exacto: precisión 3/(3+1) y recall 3/(3+2).
Con 3 TP, 1 FP y 2 FN: precisión = 3 / (3 + 1) = 0,75 y recall = 3 / (3 + 2) = 0,60. La precisión mira el denominador de las predicciones; el recall, el de los objetos reales.
Para comparar dos umbrales o dos modelos a veces hace falta una sola cifra. La F1 junta precisión y recall, y baja en cuanto una de las dos es mala.
F1 = 2 · Precisión · RecallPrecisión + Recall
Es la media armónica de las dos. Con el recuento de la pantalla anterior, precisión 0,75 y recall 0,60, da F1 = 0,67.
Un detector que marca un solo objeto, y acierta, tiene precisión 1,0 y recall 0,1. La media normal le daría 0,55. La F1 le da 0,18: si una de las dos falla, la F1 también.
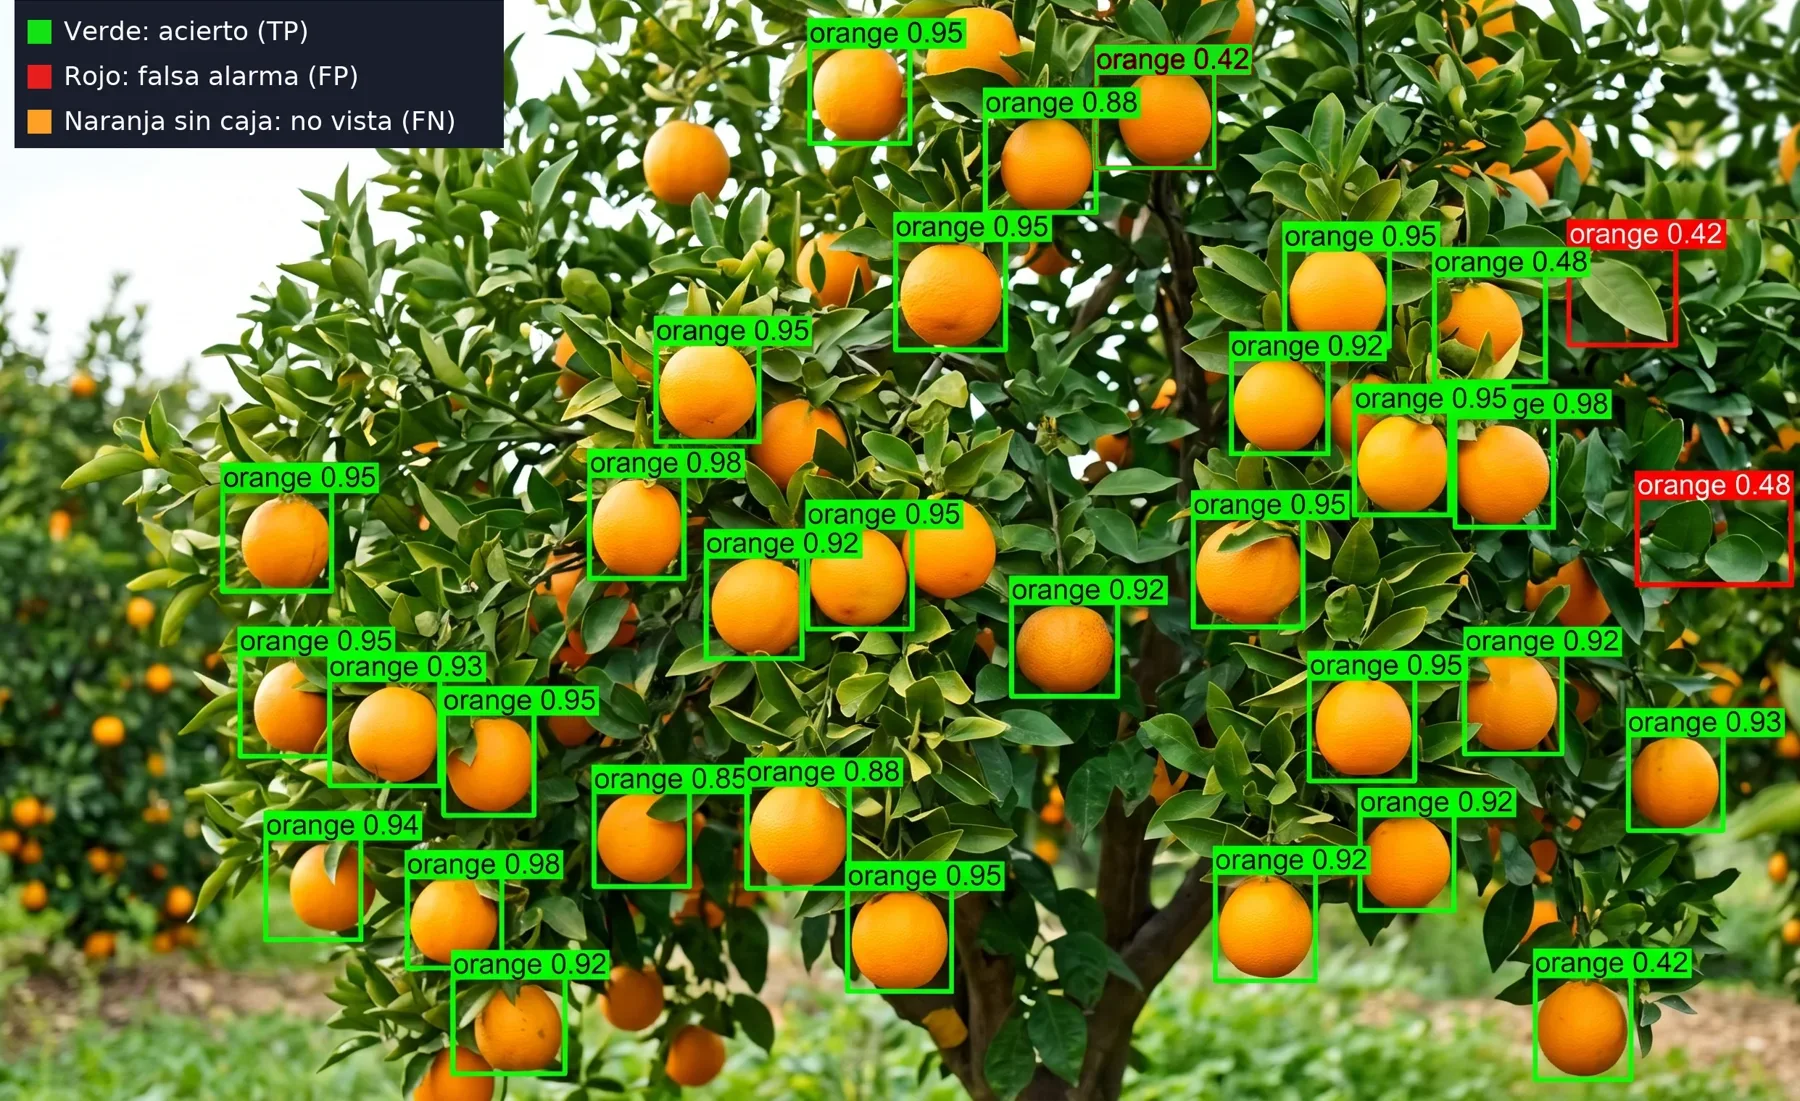
Precisión: 31 de 33 cajas, 0,94. Para el recall hay que contar a mano todas las naranjas, y eso es anotar.
Imagen generada con IA para el curso, con las cajas dibujadas como las daría un detector. Las dos falsas alarmas tienen confianzas bajas: un umbral de 0,50 las quitaría, pero también quitaría la naranja de abajo a la derecha, que tiene 0,42.
Sube el umbral y mira las dos cifras. No hay ningún punto en el que las dos valgan 1: toca elegir.
Precisión0,60
Recall1,00
TP 3 FP 2 FN 0
Se ven todos los objetos, pero también sobran predicciones.
Esta página recoge el estado con umbral 0,30: tres aciertos y dos falsas alarmas (0,66 y 0,41), precisión 0,60 y recall 1. Con 0,50 se va la de 0,41: precisión 0,75, recall 1. Con 0,60 se pierde el objeto de 0,55: 0,67 y 0,67. Con 0,70 ya no queda ninguna falsa alarma, pero el recall es 0,67. La falsa alarma de 0,66 puntúa más que un acierto, así que ningún umbral deja las dos cifras en 1.
El umbral de confianza decide qué predicciones se muestran; IoU evalúa su solapamiento.
Respuesta A. Exacto: el filtro elimina las puntuaciones que quedan por debajo del nuevo umbral.
Al subir el umbral suelen desaparecer predicciones de baja puntuación: pueden bajar los falsos positivos y también aumentar los falsos negativos. La curva precisión-recall estudia ese intercambio recorriendo muchos umbrales.
El umbral depende de qué error sale más caro en cada aplicación.
No detectar a alguien que sí está es el fallo grave. Una falsa alarma cuesta una comprobación; un objeto perdido cuesta el incidente.
Qué hacer: baja el umbral de confianza y asume más falsos positivos. Añade una segunda comprobación, humana o automática, para filtrarlos.
Dejar pasar una pieza defectuosa llega al cliente; marcar una buena solo cuesta una revisión en planta.
Qué hacer: umbral bajo y una estación de revisión. Mide cuántas piezas buenas estás parando, porque ese es el coste que notará producción.
Contar de más esconde las roturas de stock: el sistema cree que hay producto y no lo repone a tiempo.
Qué hacer: sube el umbral hasta que apenas haya falsas alarmas y vigila el recuento frente a un conteo manual de control.
Aquí no importa cada persona concreta sino que el sesgo sea estable. Un error constante se corrige; uno que cambia con la hora o el clima, no.
Qué hacer: deja el umbral intermedio y valida sobre grabaciones de momentos distintos, no sobre una sola.
La regla general: si el coste de perder un objeto supera al de revisar una falsa alarma, baja el umbral; si es al revés, súbelo. Y en todos los casos, mide el efecto sobre tus propios datos, no sobre el benchmark.
AP (Average Precision): es el área bajo la curva precisión-recall. Resume en un número lo bien que el modelo encuentra los objetos (recall alto) sin llenarse de falsos positivos (precisión alta). Cuanto más alta, mejor.
mAP (mean Average Precision): la métrica estándar para comparar detectores. Es la media de la AP de todas las clases del conjunto de evaluación. mAP@0.5 la calcula con IoU 0,5; mAP@[0.5:0.95], la métrica principal de COCO, la promedia además entre diez umbrales de 0,50 a 0,95.
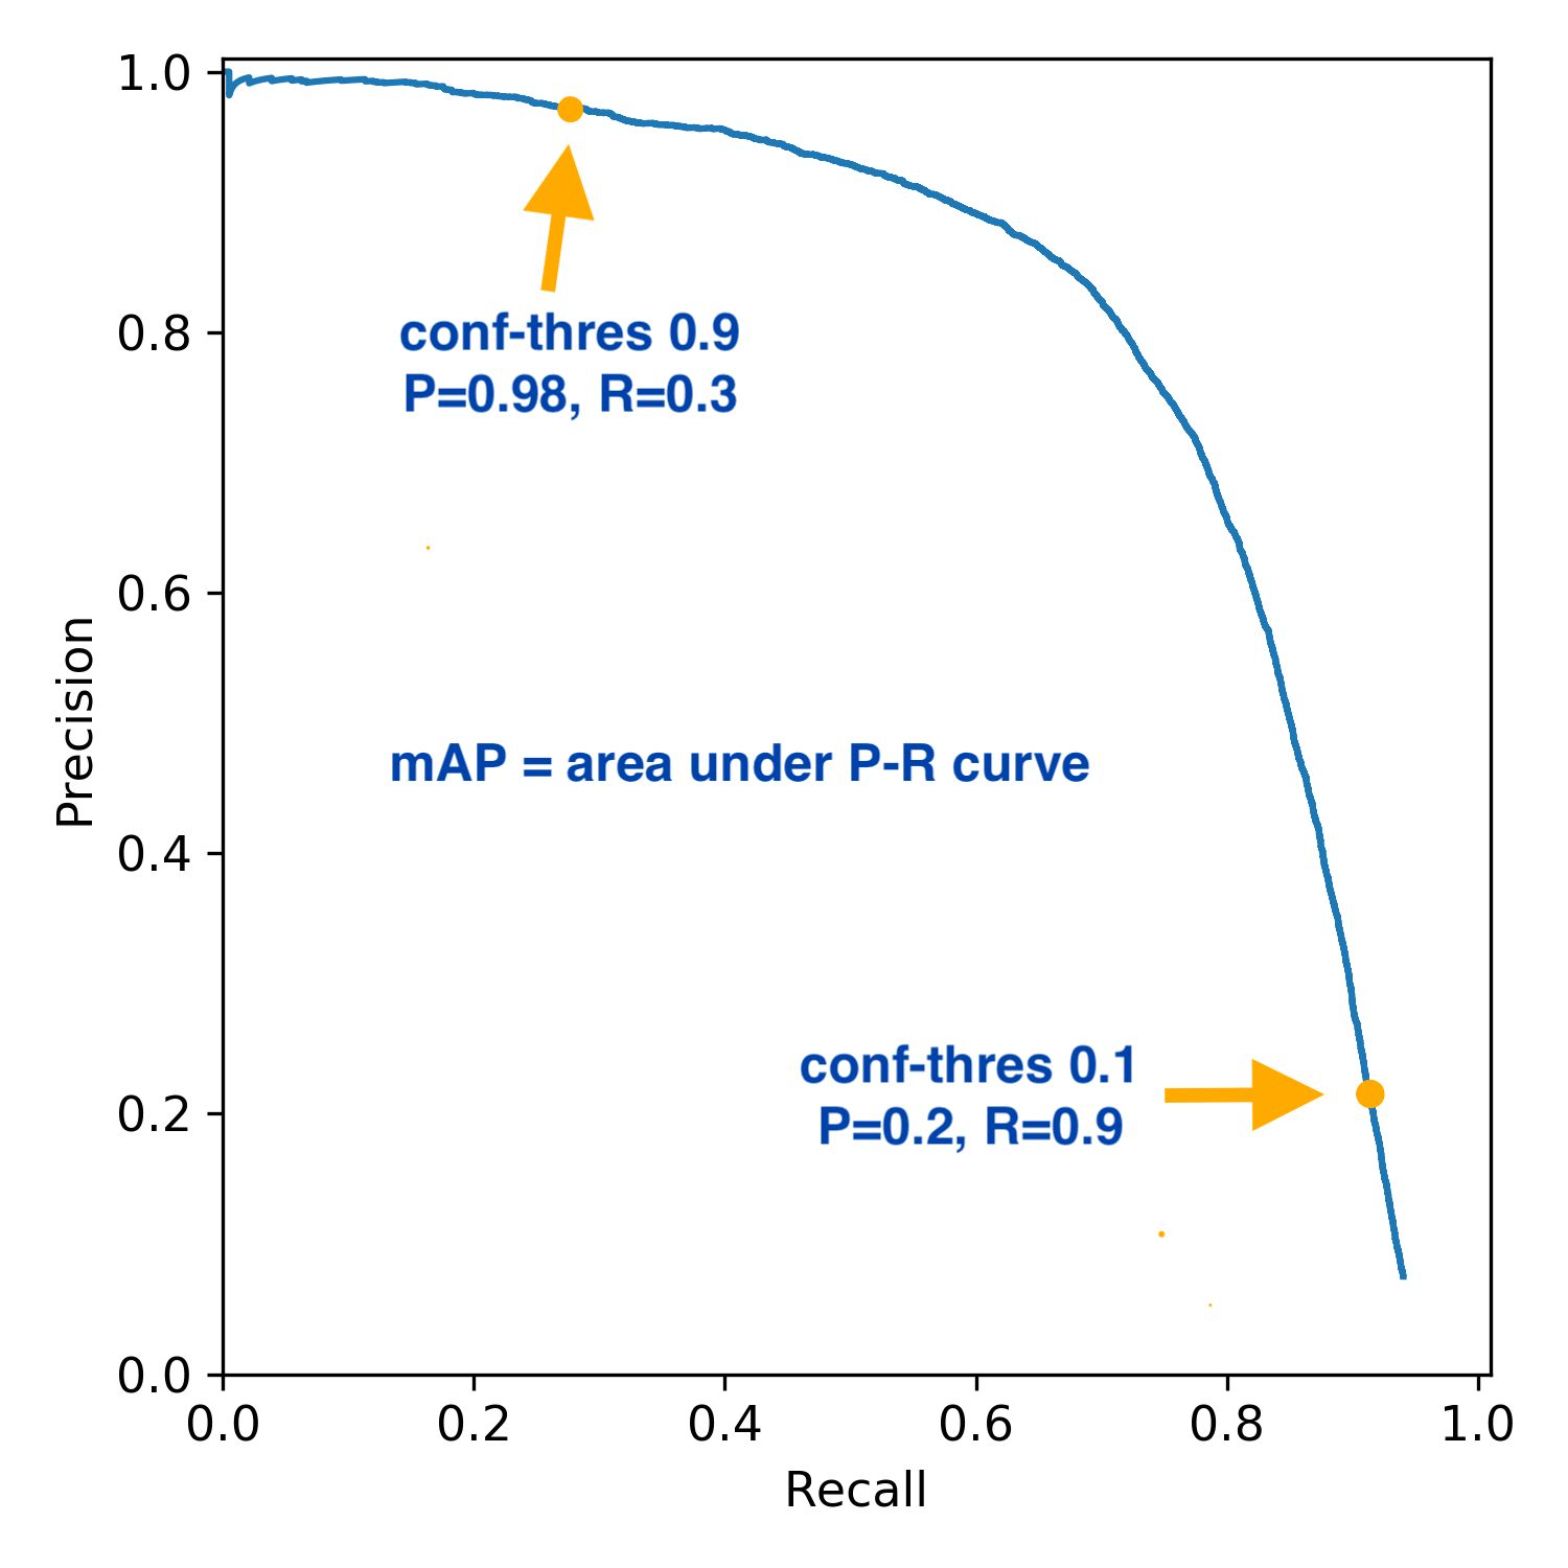
Recorrer el umbral de confianza traza la curva: con umbral 0,9 la precisión es alta y el recall bajo; con 0,1 ocurre lo contrario. AP50 y AP promediada entre varios umbrales de IoU responden a protocolos distintos y no son intercambiables.
Ocho detecciones de una clase, de más a menos confianza, para seis objetos reales. Baja el umbral: cada detección que entra añade un punto a la curva. La AP es el área bajo la curva.
Precisión0,75
Recall0,50
AP, el área bajo la curva: 0,70
Con umbral 0,76 entra un acierto: el recall sube a 0,50 y la precisión queda en 0,75.
Esta página recoge el estado con umbral 0,76: cuatro detecciones aceptadas, tres aciertos y un falso positivo, con precisión 0,75 y recall 0,50. Cada acierto sube el recall un sexto; cada falso positivo baja la precisión sin mover el recall. Para el área, la curva se convierte en escalera: cada punto toma la mejor precisión que se alcanza a ese recall o a uno mayor. Con las ocho detecciones el recall llega a 0,83, porque un objeto no lo encuentra ninguna, y la AP vale 0,70.
La mAP sirve para comparar modelos. Para ponerlos en marcha se fija un umbral, el punto de trabajo, y se mide lo que pasará con él.
"Recall al 95 % de precisión" (R@P95): cuánto encuentra el modelo si solo admites un 5 % de falsas alarmas entre lo que marca.
FPPI, o falsas alarmas por hora de vídeo: la cifra que entiende quien recibe los avisos. Se da junto al recall, por ejemplo "recall a 0,1 FPPI".
En clasificación y anomalías, donde sí hay negativos que contar: aceptando el 95 % de las piezas buenas, qué parte de las defectuosas detectas. Vuelve en el tema 4.
En detección no hay verdaderos negativos (pantalla "Errores"), por eso se habla de falsos positivos por imagen y no de TNR. El punto de trabajo se elige con datos de validación y se vigila después en producción.
Un checkpoint aprende las clases de sus datos. Tu aplicación puede necesitar otras.
Respuesta B. Exacto: una clase nueva pide datos propios o un modelo de vocabulario abierto, como los del tema 3.
Un detector de vocabulario cerrado solo puede nombrar las categorías con las que fue entrenado. Ampliarlo exige anotar y reentrenar, o cambiar a un enfoque guiado por texto.
Además de la mAP en COCO:
1. Medir en tu dominio específico: crea un conjunto de validación representativo de tus datos reales. Un modelo con 60 % mAP en COCO puede tener 40 % o 80 % en tu caso de uso particular.
2. Equilibrar velocidad y precisión: un detector con 2 % más de AP pero un 50 % más lento puede no compensar si necesitas procesar 30 FPS. Mide la latencia de extremo a extremo, no la cifra teórica del paper.
3. Analizar errores cualitativamente: inspecciona visualmente los casos de:
Los patrones de error te dirán si necesitas más datos, data augmentation específico, o cambiar de arquitectura.
Un benchmark no sustituye datos representativos, latencia medida y análisis de errores.
Respuesta C. Exacto: la elección depende del problema, del entorno y de los errores que aceptas.
Un AP mejor en un benchmark público indica rendimiento sobre ese conjunto y ese protocolo. La decisión necesita además datos de tu dominio, latencia medida en el hardware de destino y revisión de los errores que importan.
Mueve los tres controles y mira cuántas horas cuesta anotar tus propias clases antes de entrenar.
Imágenes que anotar1200
Horas, con revisión incluida20
Jornadas de una persona3,3
Coste asumible para un conjunto propio. Aun así, empieza probando un detector guiado por texto (tema 3) para saber si hace falta.
Estimación de orden de magnitud. Suma un 30 % de revisión sobre el tiempo de anotación y cuenta 6 horas productivas por jornada.
La página recoge el caso de 4 clases, 300 imágenes por clase y 45 segundos por imagen. Las cifras que más se disparan son las clases y los segundos por imagen: anotar segmentación o puntos clave multiplica el tiempo respecto a poner cajas. Antes de asumir ese coste conviene comprobar cuánto resuelve un detector guiado por texto sin anotar nada, que se ve en el tema 3.
Ocho comprobaciones antes de ponerlo en marcha.
Los ejercicios están en el cuaderno. El extra, si da tiempo, lo hacemos juntos; si no, queda para casa.
En Colab: Archivo, Guardar una copia en Drive, y Entorno de ejecución, GPU T4.