4. DINO (v1, v2, v3): ver sin etiquetas
¿Por qué auto-supervisado?
Aprendizaje supervisado
- Necesita etiquetas manuales de expertos.
- Costoso y lento de producir.
- Limitado a categorías predefinidas.
- No escala bien a grandes volúmenes de datos.
Ejemplo: ImageNet
- 14 millones de imágenes.
- 1000 categorías.
- Años de trabajo manual.
- Millones de dólares de inversión.
Aprendizaje auto-supervisado
- No requiere etiquetas manuales.
- Aprende de la estructura interna de los datos.
- Escala a billones de imágenes de manera eficiente.
- Genera representaciones más generales y transferibles.
Self-supervised learning explicado
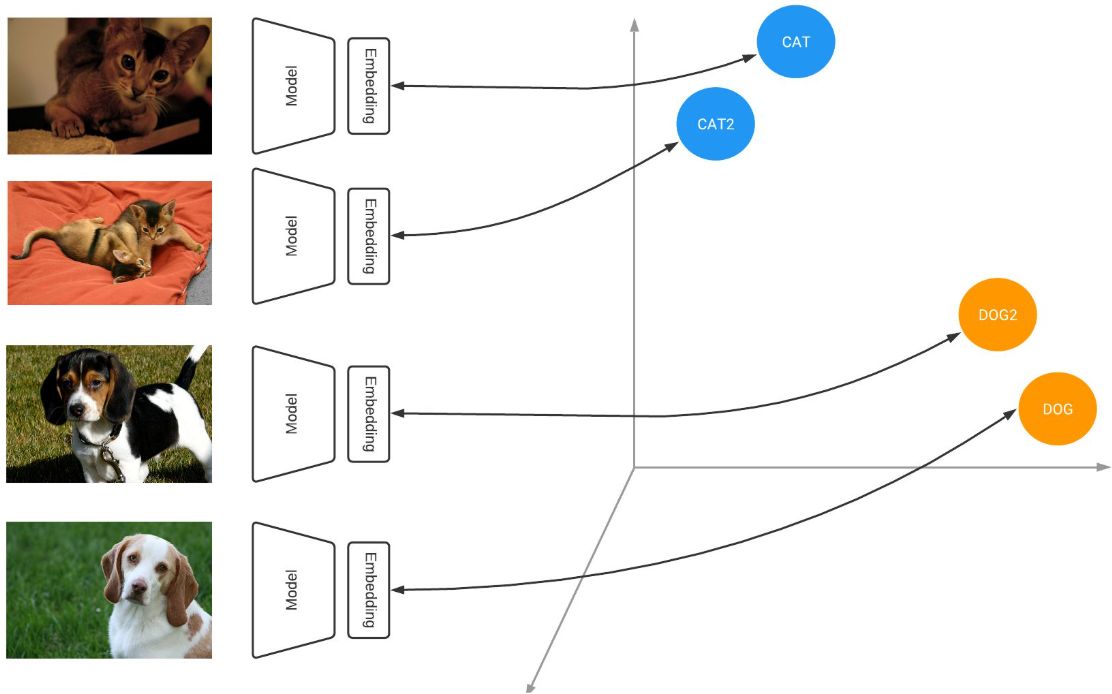
Contrastive learning
- Imágenes similares → embeddings cercanos.
- Imágenes diferentes → embeddings lejanos.
Masked prediction
- Ocultar partes de imagen.
- Predecir partes ocultas.
Rotation prediction
- Rotar imagen.
- Predecir ángulo de rotación.
Clustering
- Agrupar features similares sin saber qué representan.
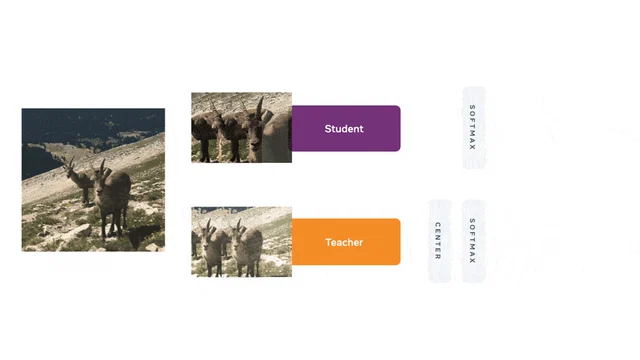
Auto-destilación
Red estudiante (student network)
- Aprende activamente y ajusta sus pesos mediante backpropagation.
- Recibe diferentes aumentaciones (vistas locales o detalladas) de la imagen.
Red maestra (teacher network)
- Posee la misma arquitectura que la estudiante, pero con pesos estables.
- Sus pesos se actualizan lentamente a través de un promedio móvil (momentum update) de los pesos de la red estudiante.
- Recibe una vista global o contextual de la imagen.
Lo que DINO aprende solo
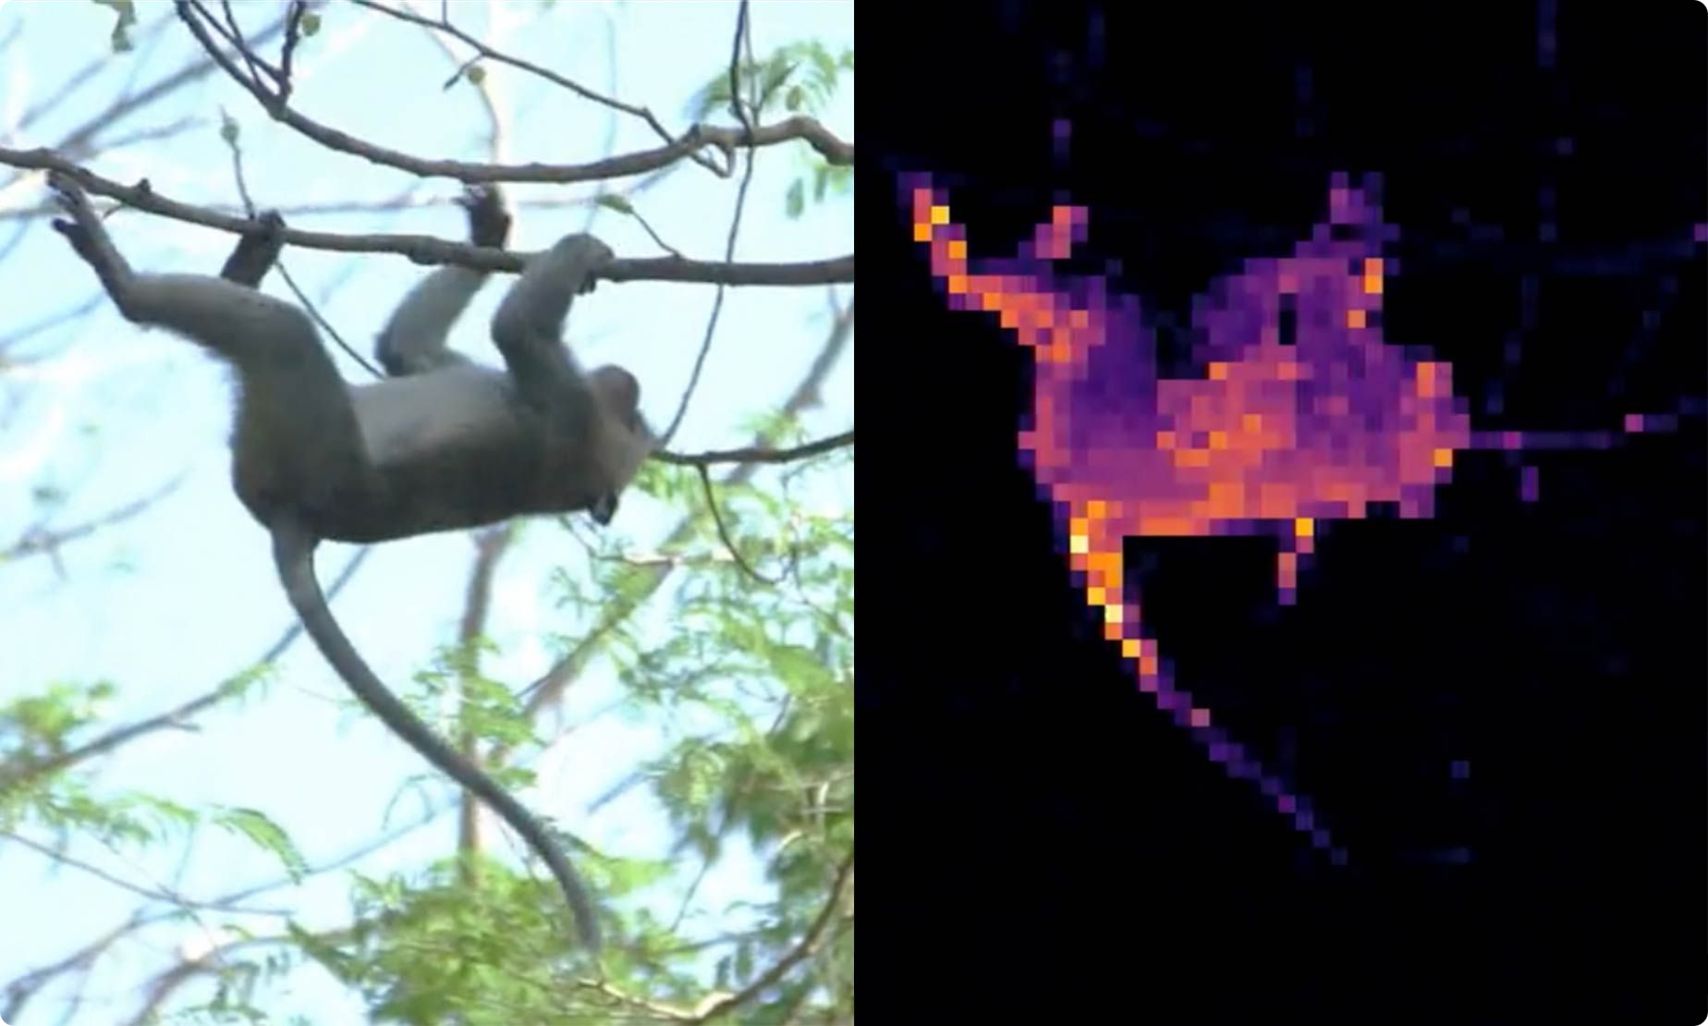
Los mapas de atención son una señal interna del modelo y se alinean a menudo con objetos, pero no son una máscara de segmentación garantizada ni validada píxel a píxel.
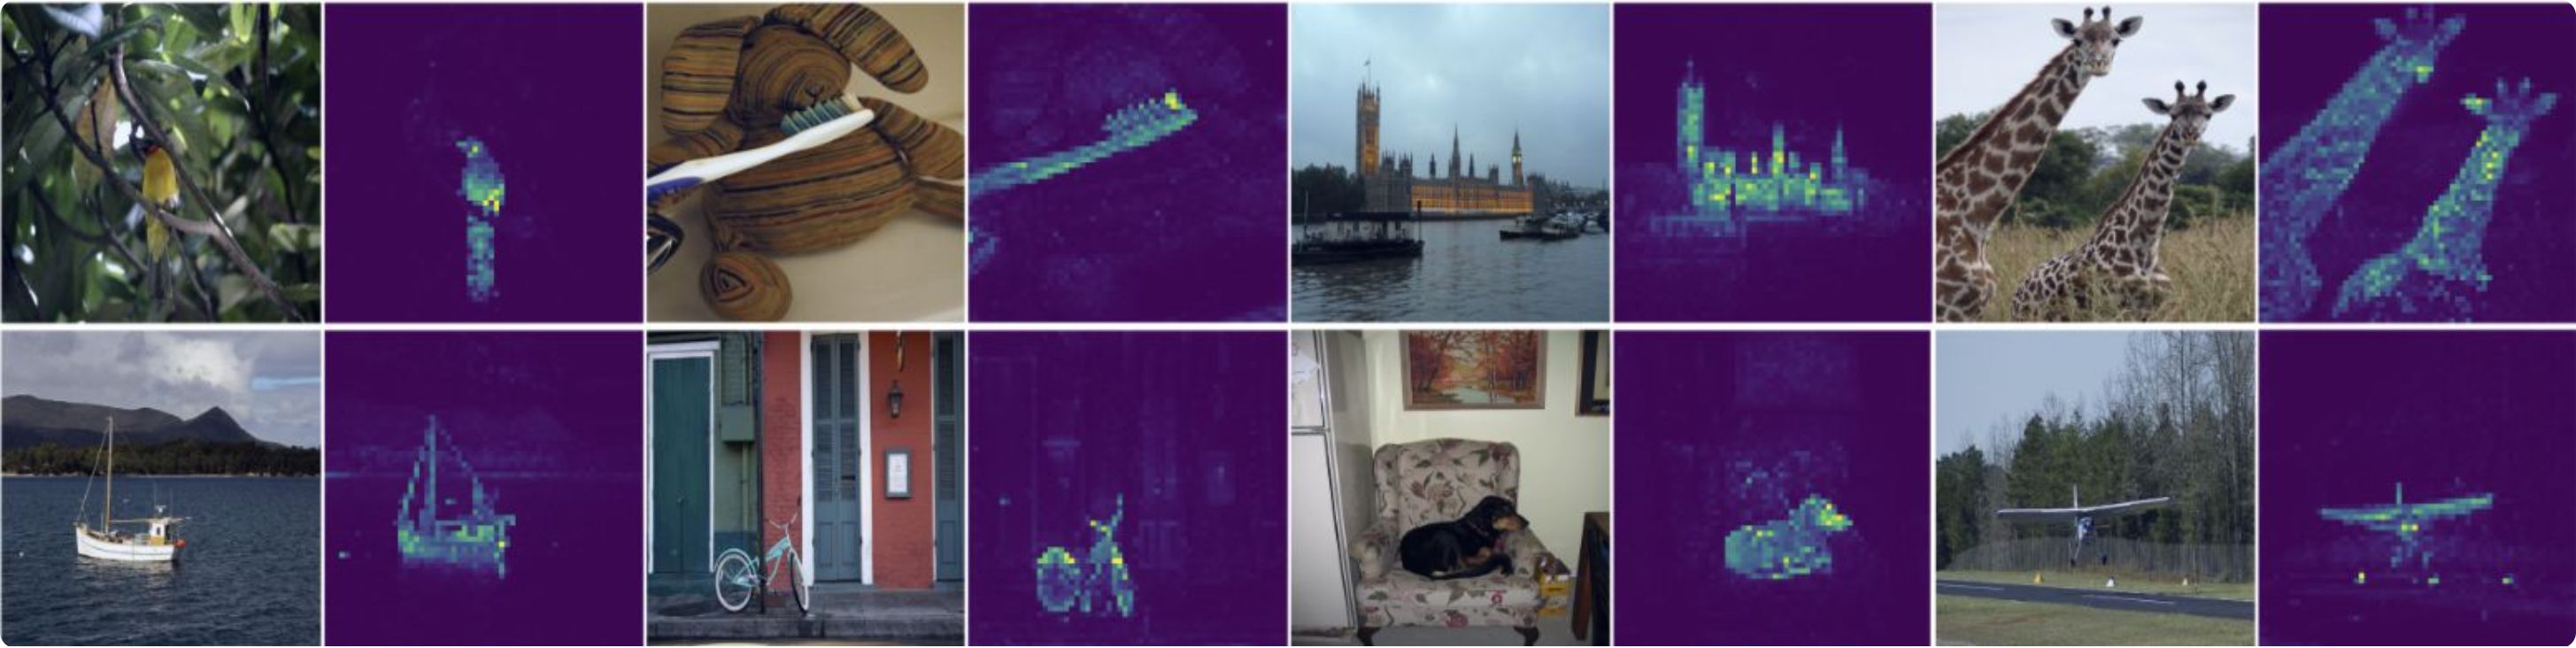
La atención, encima de la foto
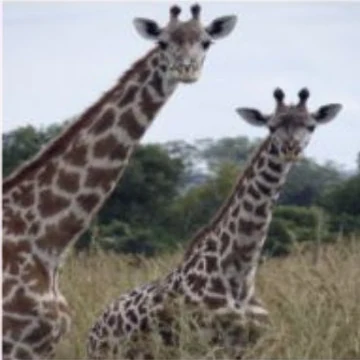
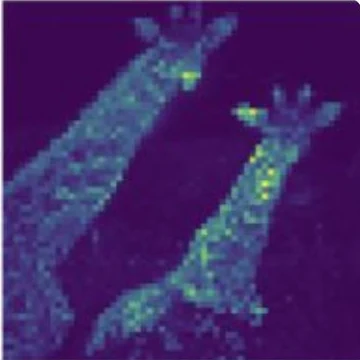
Dos animales del mismo tipo y el mapa los separa a los dos, con más intensidad en cuellos y cabezas.
Los recortes salen de la figura original del artículo de DINO, que muestra la atención del token de clase en la última capa de un ViT entrenado sin etiquetas. El mapa tiene la resolución de los parches, de ahí el aspecto cuadriculado: con parches de 8 píxeles se ve más fino que con parches de 16. Conviene recordar que es una señal interna del modelo y no una máscara validada píxel a píxel, así que sirve para entender qué mira y no como salida de segmentación.
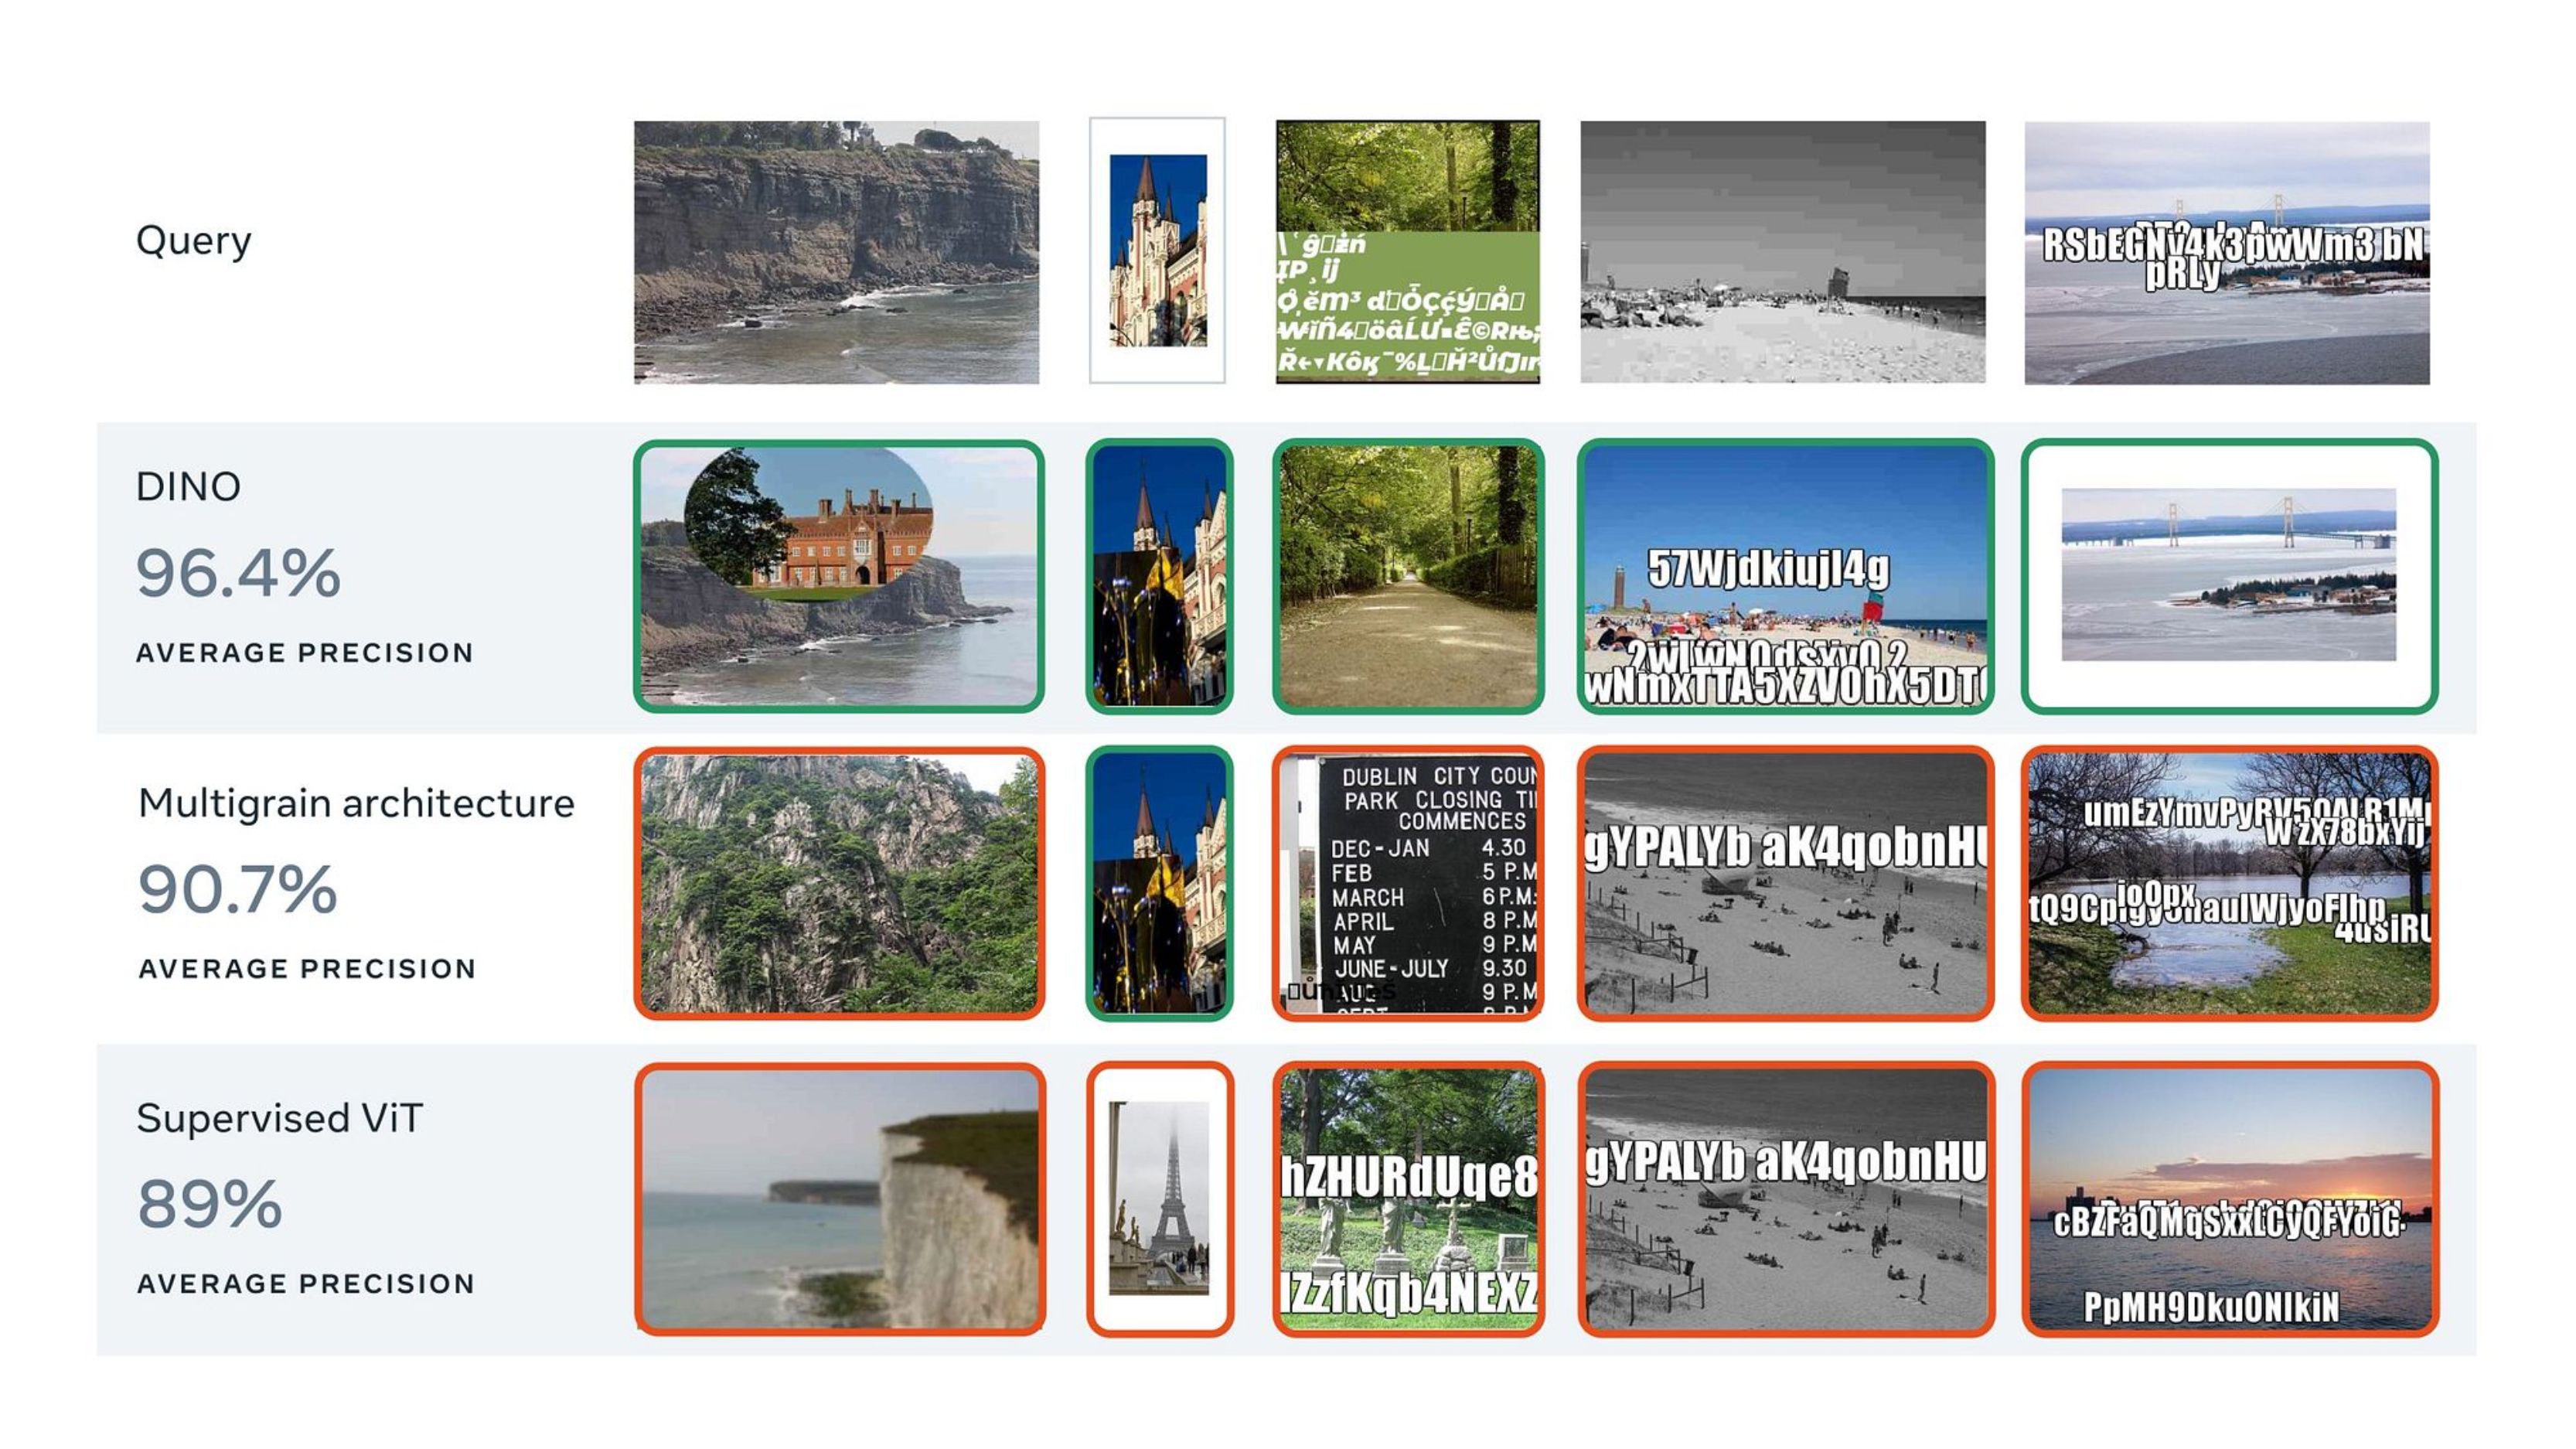
DINO: identificación de copias de imágenes
Evolución de la familia DINO
-
2021: DINO v1
Primer ViT auto-supervisado. Demostró que la atención del modelo podía realizar segmentación de objetos sin supervisión explícita.
-
2022: DINO v2
Escalado a 142M imágenes, con mejoras arquitectónicas. Generó features visuales mucho más robustas y generalizables.
-
2024: DINO v3
Entrenado con 1B+ imágenes, logrando una calidad de representación cercana a la supervisada. Base para nuevos modelos fundacionales.
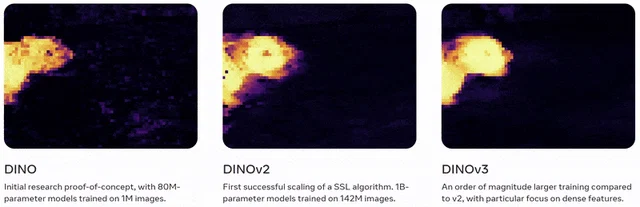
DINOv2 se publicó en 2023 y DINOv3 en 2025. Las fechas de la diapositiva señalan el momento en que cada generación se incorporó al curso.
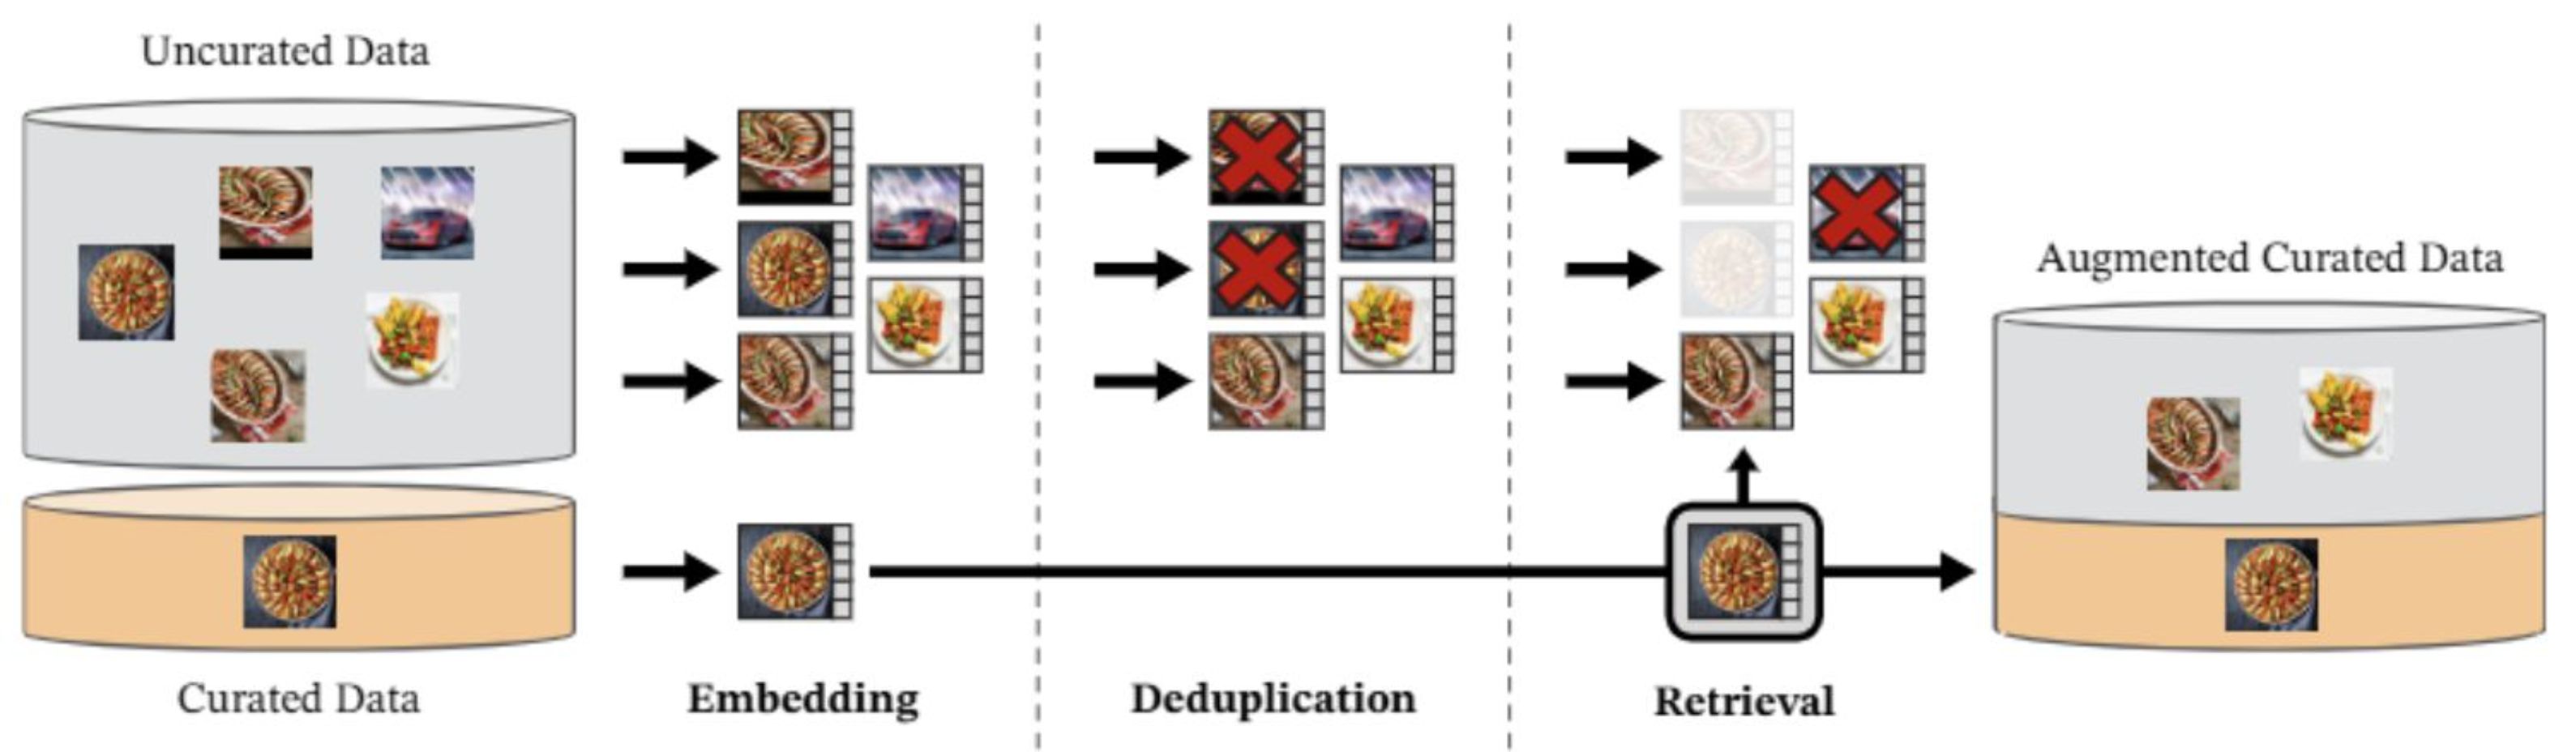
Pipeline de procesamiento de datos DINOv2
-
Ingesta de datos
Imágenes curadas y no curadas (de la web) se combinan para diversidad.
-
Generación de embeddings
Todas las imágenes se transforman en embeddings de alta dimensión.
-
Eliminar duplicados
Se eliminan duplicados o imágenes muy similares de los datos no curados usando embeddings.
-
Matching y enriquecimiento
Imágenes no curadas visualmente similares a las curadas se añaden para enriquecer el dataset.
-
Retrieval auto-supervisado
El sistema expande el dataset añadiendo imágenes relevantes sin etiquetado manual.
Lo que DINO aprende solo
Descubrimientos importantes
Segmentación semántica
Los mapas de atención de DINO actúan como máscaras de objetos, distinguiendo el primer plano del fondo. Identifica objetos coherentes en la escena sin ninguna anotación durante su entrenamiento.
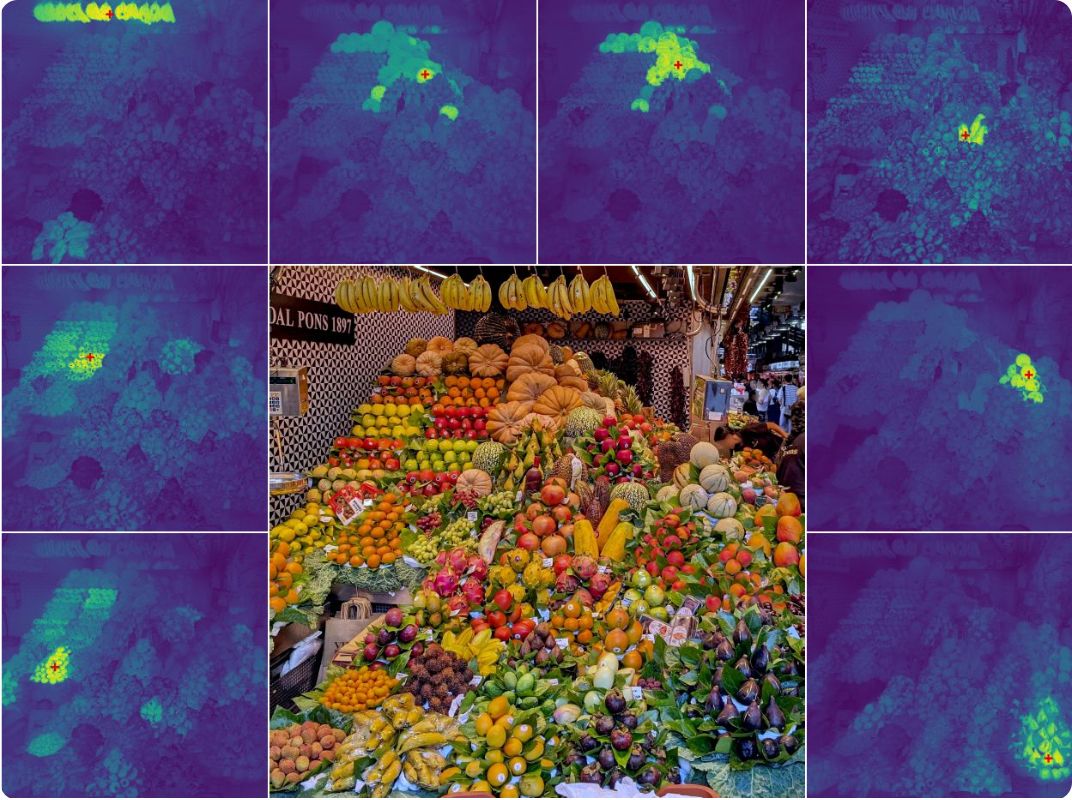
Correspondencias
Es capaz de encontrar puntos equivalentes y coherentes entre diferentes vistas de una imagen o incluso entre imágenes distintas. Esta capacidad surge sin haber sido supervisado nunca para tareas de correspondencia.
Detección de objetos
Los heads de atención de DINO se focalizan naturalmente en objetos salientes dentro de la imagen. Esto ocurre sin que el modelo haya visto una sola bounding box durante su fase de preentrenamiento.
Clasificación
Utilizando las features extraídas por DINO, un clasificador k-NN simple puede lograr buenos resultados. DINO no utiliza etiquetas de clases para el entrenamiento, pero sus representaciones son altamente discriminativas.
DINO como extractor de características
Uso principal
Backbone para extraer características visuales universales de cualquier imagen, sin anotaciones.
Ventajas
- Generales y transferibles.
- Alto rendimiento en dominios nuevos.
- No sesgado a categorías específicas.
Calidad
- Densas (por patch).
- Semánticamente significativas.
- Altamente discriminativas.
Aplicaciones
- Clasificación (k-NN).
- Detección de anomalías.
- Clustering visual.
Entendiendo qué aprende DINO
Mapas de atención
Visualizan las ponderaciones de auto-atención del modelo, mostrando explícitamente dónde se focaliza la red. Revelan segmentación implícita de objetos y la relación entre elementos.
PCA de features
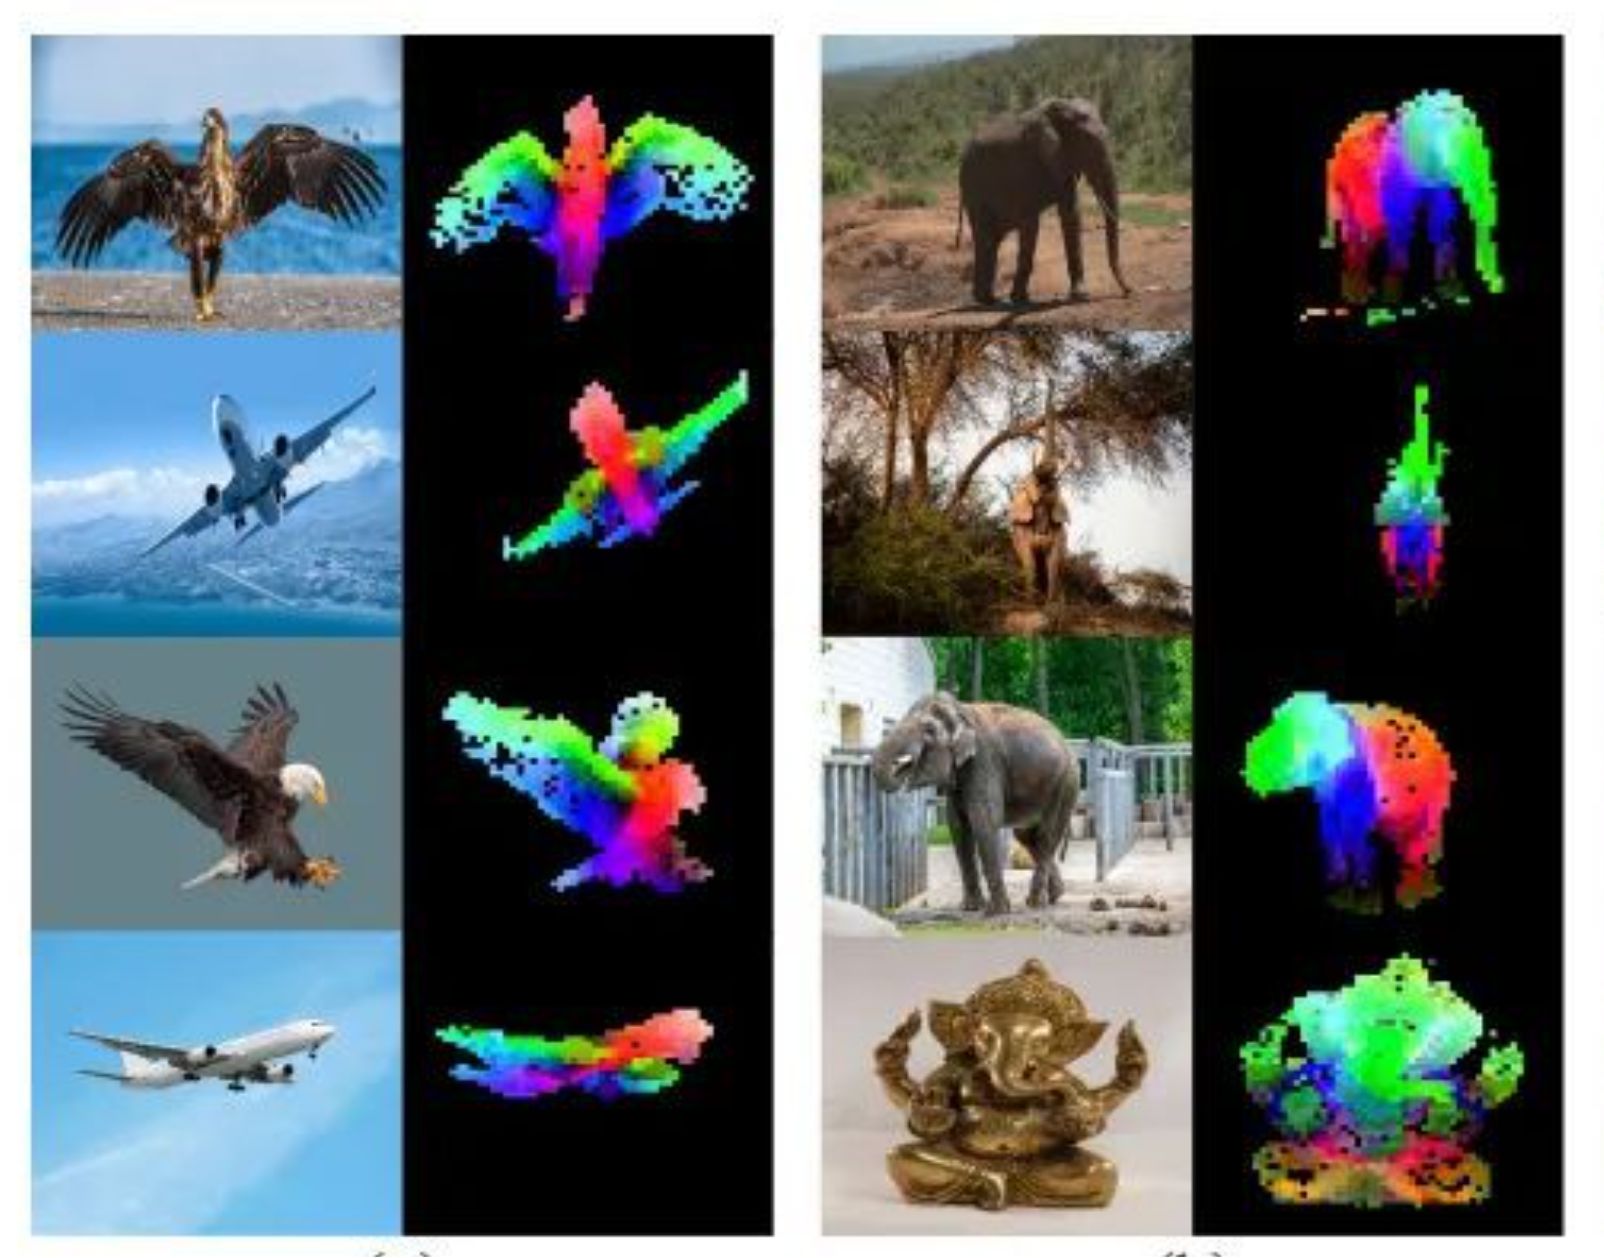
Aplica Análisis de Componentes Principales a las características densas extraídas por DINO. Se mapean los primeros 3 componentes a canales RGB para visualizar agrupaciones semánticas.
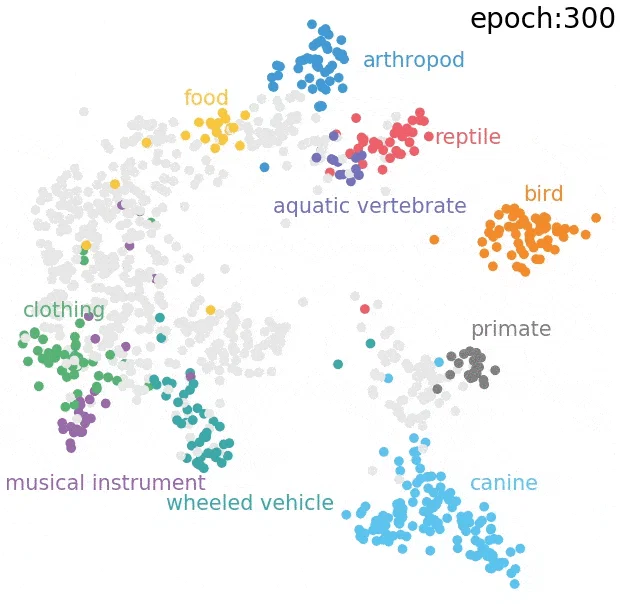
t-SNE / UMAP
Estas técnicas de reducción de dimensionalidad no lineal proyectan los embeddings de alta dimensión en un espacio 2D. Muestran cómo DINO agrupa conceptos visuales similares sin etiquetas.
Vecinos cercanos
Identifica parches de imagen o imágenes completas con las representaciones DINO más similares. Útil para validar la coherencia de las características y encontrar correspondencias visuales.
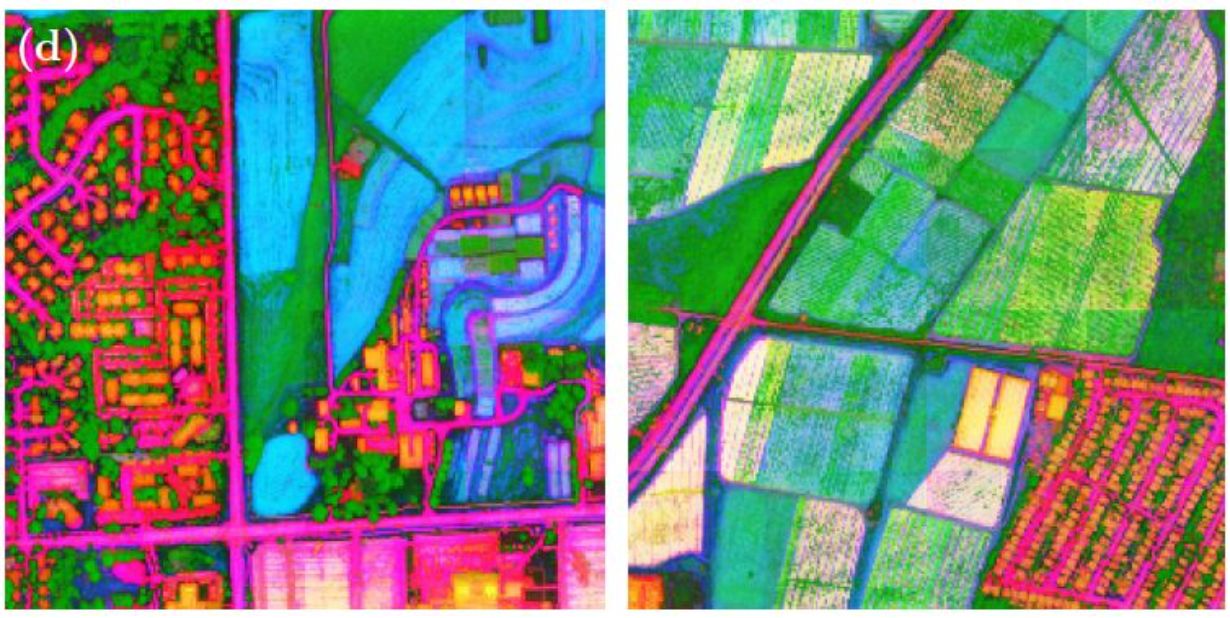
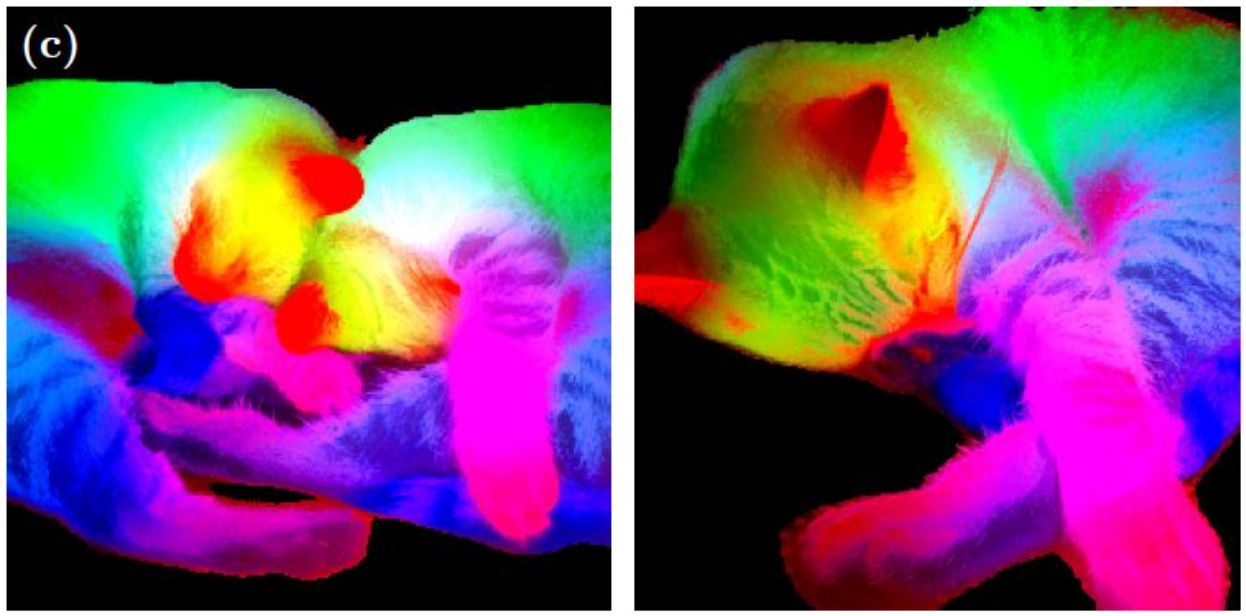
PCA es una proyección lineal útil para colorear características densas. t-SNE y UMAP son técnicas no lineales que proyectan embeddings a 2D para explorar vecindarios. Ninguna crea etiquetas ni demuestra por sí sola que un cluster sea una clase real.
De 768 números a un color
-
Un vector por parche
La imagen se parte en parches de 16 × 16 píxeles y el modelo devuelve un vector por parche, de 768 números en un ViT base. Una imagen de 224 × 224 da 196 vectores.
-
PCA sobre todos los parches
Se juntan esos vectores y se buscan las tres direcciones en las que más varían. Es álgebra pura, sin entrenamiento ni etiquetas.
-
Tres números por parche
Cada parche se proyecta sobre esas tres direcciones. Los 768 números se quedan en tres, que es justo lo que cabe en un color.
-
Los tres números se pintan
Se reescalan a 0-255 y se usan como rojo, verde y azul. El parche vuelve a su sitio en la rejilla y aparece la imagen de colores.
Dos avisos prácticos. El primero: los colores no son comparables entre imágenes salvo que el PCA se ajuste con todas a la vez, porque cada ajuste elige sus propias direcciones y el signo de cada componente es arbitrario. Por eso las figuras publicadas suelen calcular el PCA sobre el conjunto entero de imágenes que enseñan. El segundo: la primera componente suele separar objeto y fondo más que partes concretas, así que es habitual usarla como máscara, quedarse solo con los parches del objeto y repetir el PCA sobre ellos para que las tres componentes se gasten en distinguir partes. El procedimiento no depende de DINO: se puede aplicar a las características densas de cualquier modelo, y lo que cambia de uno a otro es cuánta estructura aparece.
DINO v3
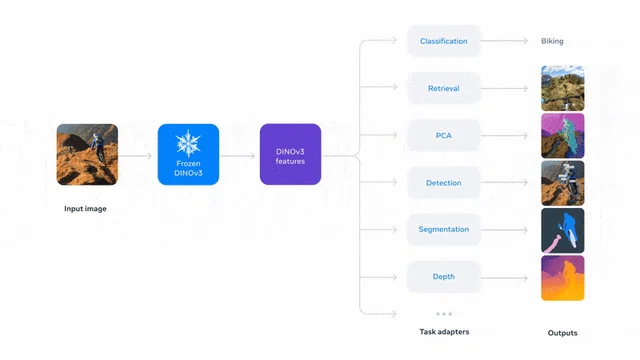
DINO v3: características densas
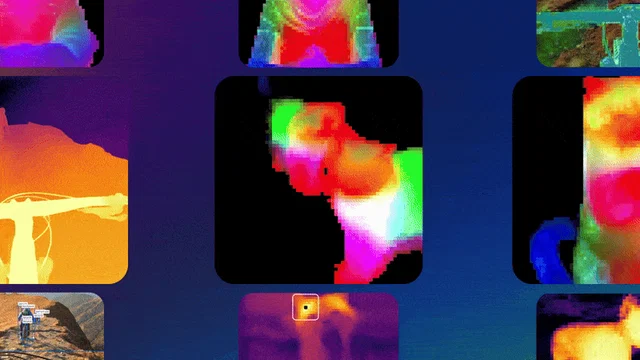
Aceptar o rechazar la pieza
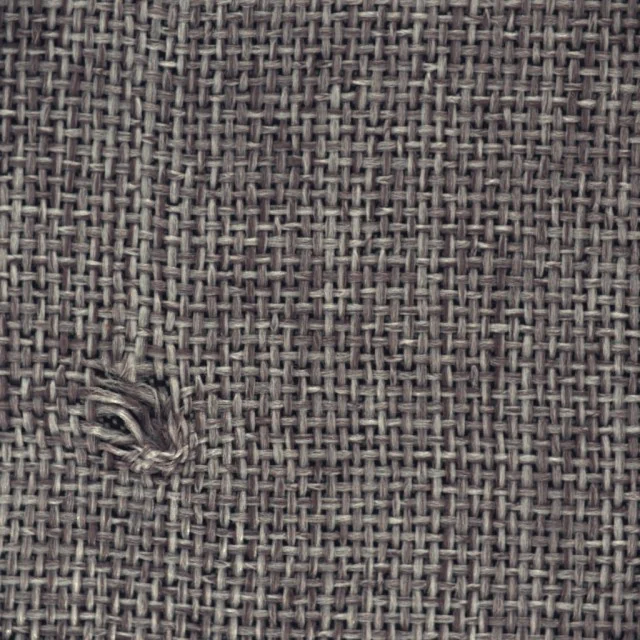
La misma alfombra, buena y con un defecto. Mueve el umbral y mira qué celdas se encienden en cada una.
Se rechaza
Celdas marcadas13
Puntuación más alta1,89
Qué pieza pasa por la cámara
Esta página recoge el estado de la pieza defectuosa con umbral 1,30. Las puntuaciones están precalculadas con un descriptor clásico, no con DINO: cada celda de 35 × 35 píxeles se resume en siete estadísticas de intensidad y de gradiente, se normaliza con las celdas buenas y se puntúa por la distancia a la celda buena más parecida, que es exactamente la regla de PatchCore. Una celda de la pieza buena se compara con las demás celdas buenas y nunca consigo misma, así que su puntuación es honesta. El mapa se suaviza con una media de 3 × 3 para que un parche raro suelto no dispare la alarma. Con este descriptor la pieza buena llega como máximo a 1,28 y la defectuosa a 1,89: el margen existe pero es estrecho, y por debajo de 1,20 aparecen falsas alarmas. Con características de DINOv2 el margen se abre, que es justamente el motivo de usarlas, y el cuaderno del tema lo comprueba con el mismo par de imágenes.