3. Modelos multimodales
CLIP · BLIP · Grounding DINO · VLM (Qwen)
Los modelos fundacionales multimodales combinan visión y lenguaje: entienden instrucciones escritas, describen imágenes, detectan objetos a partir de una descripción y razonan sobre lo que ven.
Modelos fundacionales
Definición
Son modelos preentrenados a gran escala que aprenden representaciones generales y transferibles.
Importancia
El preentrenamiento masivo les da patrones que sirven para otras tareas, y a menudo funcionan sin ningún ejemplo de la tarea (zero-shot).
Capacidades
Permiten reutilizar el conocimiento en muchas tareas, reducen anotación y evitan entrenar desde cero.
Ejemplos
- CLIP: 400 millones de pares imagen-texto.
- DINOv2: 142 millones de imágenes (sin etiquetas).
- SAM: 11 millones de imágenes y 1.100 millones de máscaras (segmentaciones).
Multimodalidad
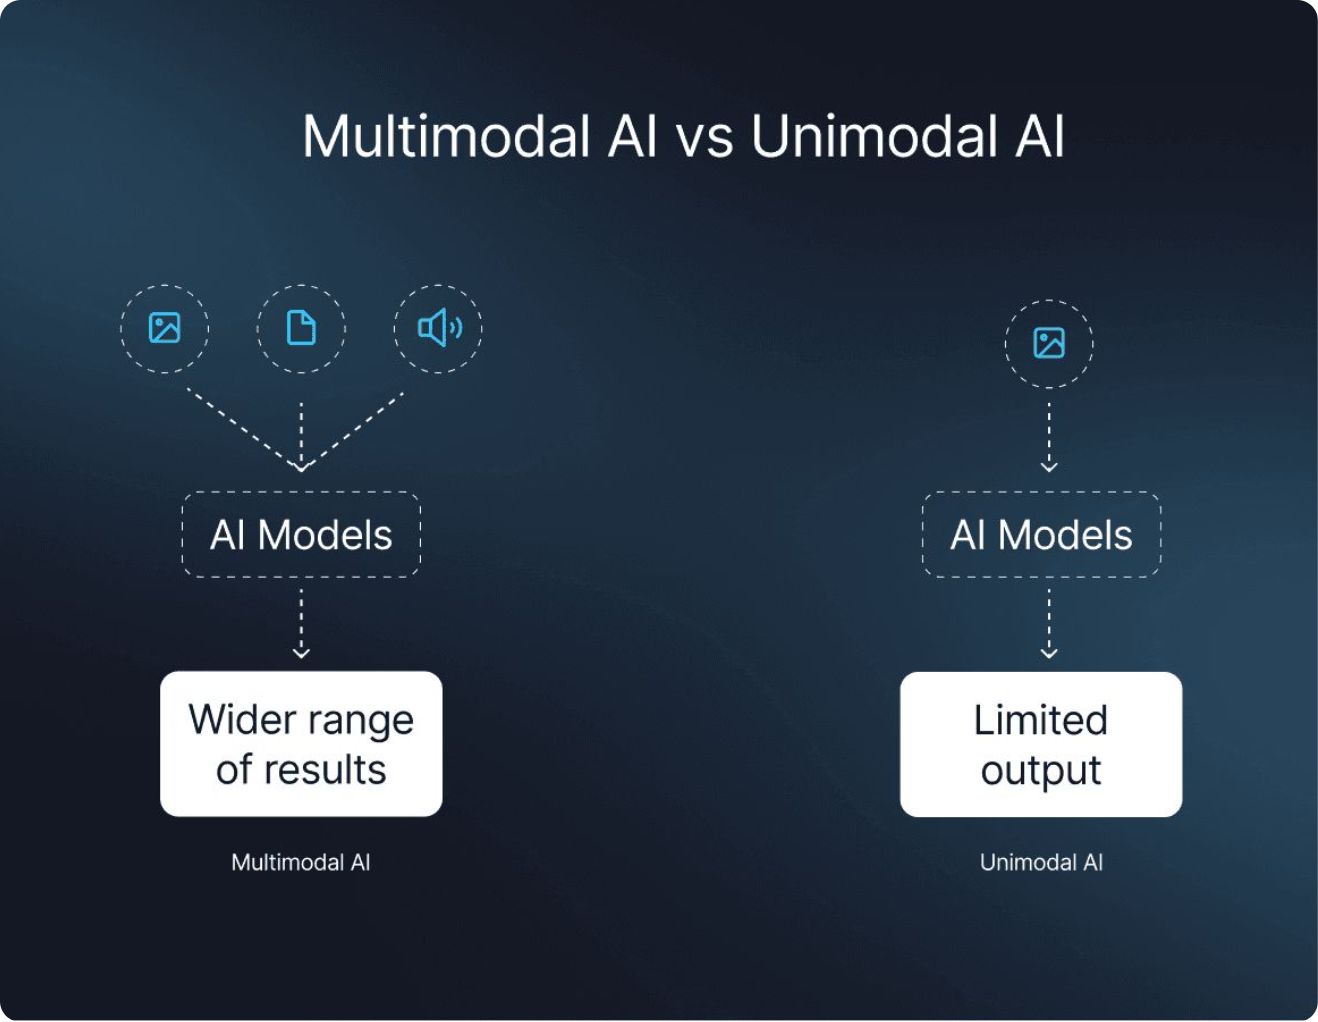
Un modelo multimodal procesa imagen y texto a la vez y aprende las correspondencias entre ambos. Por eso entiende instrucciones sobre una imagen y puede describirla con palabras.
Ejemplos de modelos multimodales:
- CLIP: relaciona imágenes y texto en un espacio compartido.
- BLIP: genera descripciones y responde preguntas sobre imágenes.
- Grounding DINO: detecta objetos mediante descripciones textuales.
- VLM (Qwen): conversa y razona sobre contenido visual.
Zero-shot y composicionalidad
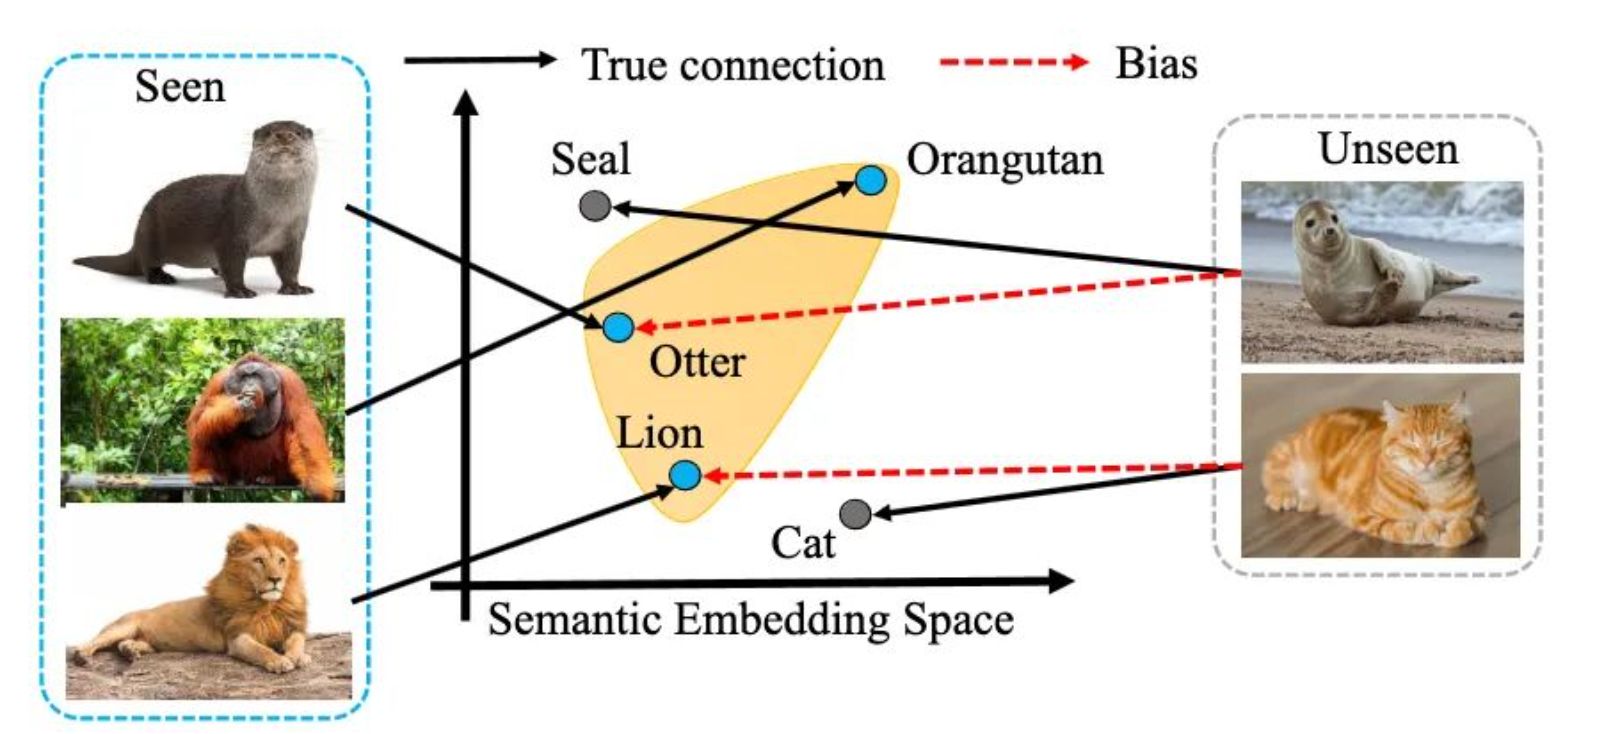
La capacidad zero-shot significa que el modelo puede resolver tareas nuevas sin entrenamiento específico para ellas. Lo que lo hace posible es la composicionalidad: el modelo aprende conceptos atómicos ("perro", "rojo", "corriendo") y los combina libremente.
Ejemplo práctico: el modelo solo ha visto nutria, orangután y león. En una imagen nueva, foca y gato (nunca vistos) se proyectan en el espacio semántico cerca de los conceptos aprendidos (foca ≈ nutria, gato ≈ león). Así reconoce clases nuevas sin reentrenar: añadir una categoría es escribirla, con un coste de anotación casi nulo.
Impacto en producción
- Se ahorran miles de horas de anotación manual para nuevas variantes.
- Se puede experimentar en minutos en lugar de semanas.
Esto pesa mucho en industria o medicina, donde las categorías cambian a menudo. A cambio, suele acertar menos que un modelo ajustado con datos propios.
Categorías nuevas sin reentrenar
En zero-shot, las clases se cambian escribiendo otros textos, sin reentrenar.
Respuesta B. Exacto: es lo que hace CLIP. Las clases son los textos que escribes.
La composicionalidad permite combinar atributos como "rojo", "perro" y "corriendo". Esto acelera la experimentación, aunque las categorías propuestas y la formulación de los textos pueden cambiar el resultado.
CLIP: comparar imágenes con textos
CLIP (Contrastive Language-Image Pre-training) aprende un espacio de embeddings compartido donde imágenes y textos similares están cerca y diferentes están lejos.
Arquitectura: un encoder de imagen y un encoder de texto procesan sus respectivas entradas en paralelo, proyectándolas al mismo espacio vectorial. La similitud se mide con producto escalar o coseno.
- Clasificar sin entrenar: para separar fotos de playa, montaña y ciudad basta con escribir esas tres palabras. CLIP compara cada foto con los tres textos y se queda con el más parecido.
- Buscar fotos escribiendo: es lo que hace la galería del móvil cuando escribes perro en la playa y salen esas fotos, aunque nadie las haya etiquetado.
- Primer filtro: en una tienda online, apartar las fotos que no son de producto antes de pasar el resto a un modelo más lento.
Cómo funciona CLIP
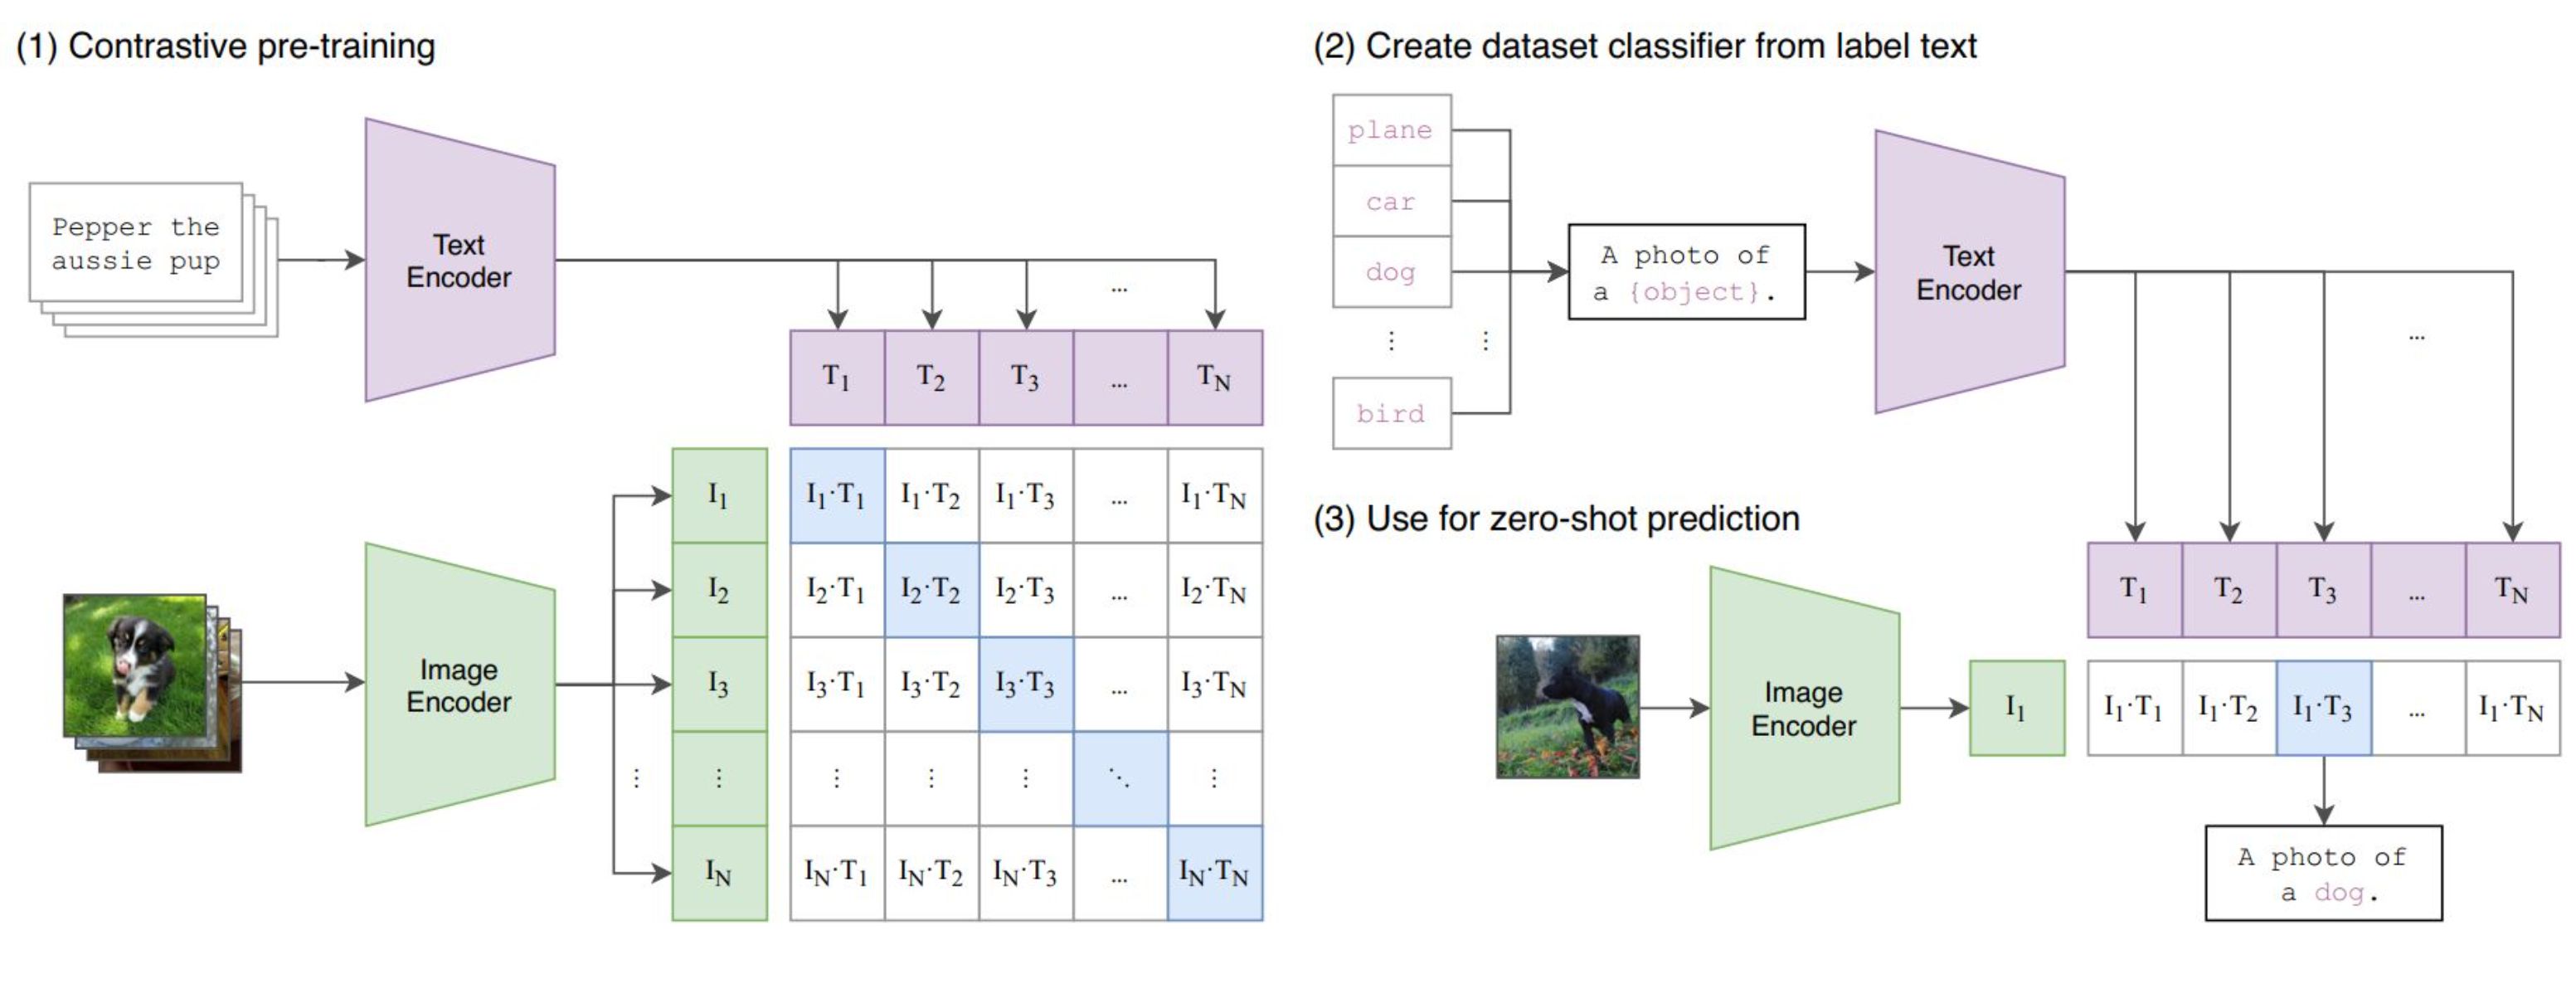
CLIP relaciona imágenes y texto mediante un entrenamiento contrastivo (contrastive learning) y luego aplica ese conocimiento para tareas como la clasificación zero-shot.
-
Imagen a vector
La imagen se convierte en un vector (embedding) con el Image Encoder.
-
Textos a vectores
Los textos de las posibles clases se convierten en vectores con el Text Encoder.
-
Cálculo de similitud
Se calcula la similitud entre el vector de la imagen y cada vector de texto.
-
Predicción
La clase con mayor similitud es la predicción final del modelo.
Ejemplo: para una foto de un gato y los textos "una astronauta…", "un gato…" y "un caballo…", las similitudes son [0.1, 0.9, 0.2] y la predicción es "un gato…".
Similitud coseno
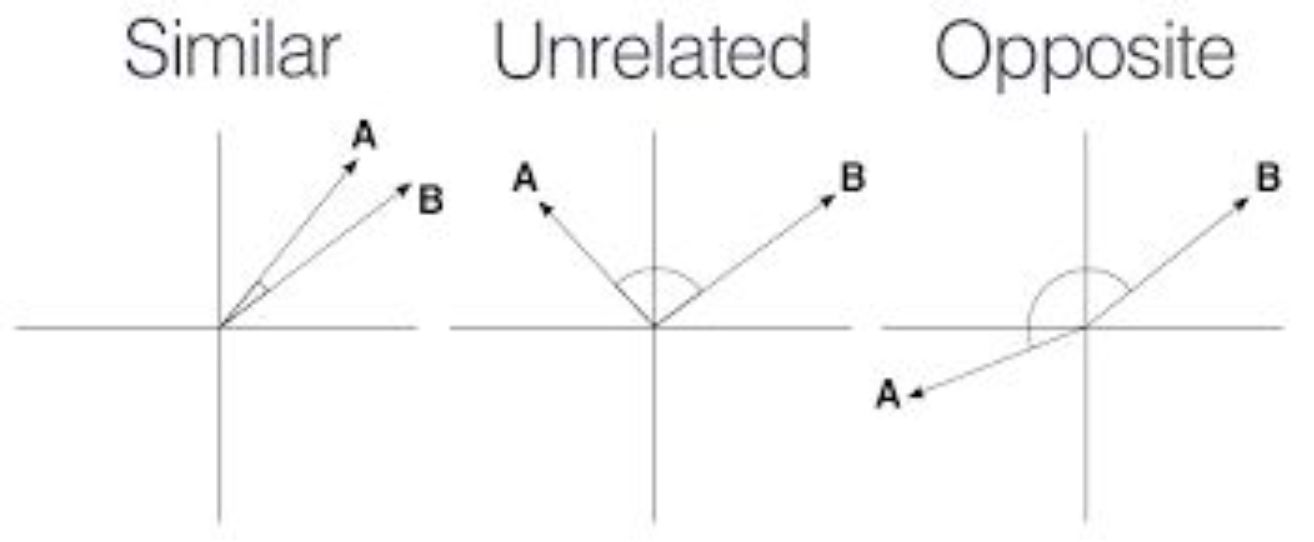
La similitud coseno compara direcciones, no longitudes: gira la imagen y mira qué texto gana.
Las líneas grises de puntos unen los textos que el modelo ha dejado cerca: gato con perro, bicicleta con coche. En naranja, el texto más cercano en línea recta.
- un gato 0,99
- un perro 0,96
- una bicicleta −0,17
- un coche −0,53
Gana "un gato" por ángulo (0,99), aunque "un perro" esté más cerca en línea recta: 0,17 frente a 0,46.
Para qué sirve esto en la práctica: es el motor de la búsqueda por texto en un catálogo de imágenes, de la deduplicación ("¿tengo ya esta foto?") y del primer filtro de moderación. En los tres casos se codifica una vez, se guardan los vectores y luego cada consulta es una comparación rápida.
La similitud coseno solo mira el ángulo entre vectores: vale 1 cuando apuntan igual, 0 cuando son perpendiculares y −1 cuando se oponen. Por eso dos vectores de longitud muy distinta pueden ser casi idénticos para el modelo, como pasa aquí con la imagen y "un gato". La práctica habitual es normalizar los vectores antes de guardarlos; con vectores normalizados, ordenar por coseno y ordenar por distancia euclídea dan el mismo resultado, y la distancia deja de estorbar. La agrupación tampoco es casual: los conceptos que aparecen juntos en los pares de entrenamiento acaban en direcciones próximas, y por eso gato y perro caen a un lado y bicicleta y coche al otro. De ahí se siguen dos consecuencias prácticas: la lista de candidatos condiciona la respuesta, porque el modelo elige siempre uno, y la formulación del texto desplaza su vector, así que reescribir el prompt puede cambiar el ganador sin tocar la imagen.
Cómo se entrena CLIP
Entrenamiento contrastivo a gran escala (400M de pares imagen-texto).
-
La entrada: arquitectura de dos torres
CLIP utiliza dos codificadores independientes que trabajan en paralelo, proyectando la información a un espacio compartido. El Image Encoder (Vision Transformer o ResNet) convierte la imagen en un vector numérico (embedding). El Text Encoder (un Transformer) convierte la descripción textual en otro vector numérico.
-
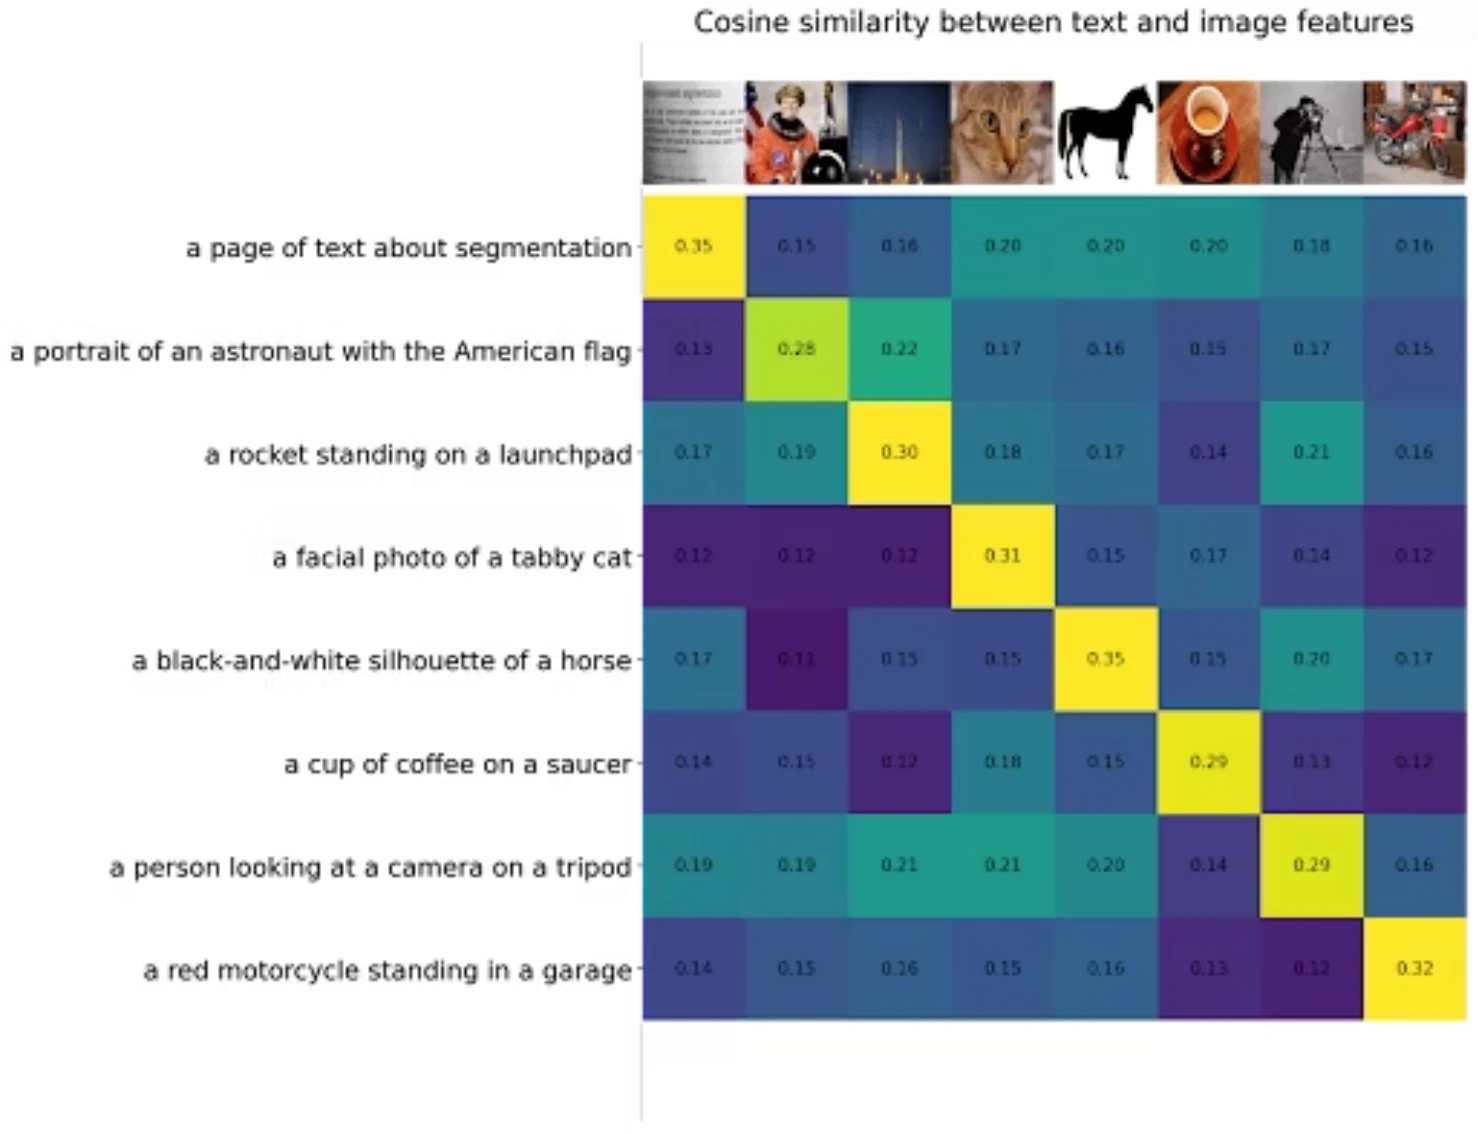
El proceso: la matriz de N × N
El modelo recibe un lote (batch) de N imágenes y sus N textos correspondientes, creando una matriz de N × N posibles parejas. En un lote de 32.768 pares, el tamaño que usó CLIP, hay 32.768 parejas correctas y más de mil millones de combinaciones incorrectas.
-
El objetivo: maximizar la diagonal
El modelo se entrena con una única regla simple (Contrastive Loss):
- Aumentar la similitud (producto escalar) de los pares correctos (en la diagonal).
- Disminuir la similitud de todas las combinaciones incorrectas (fuera de la diagonal).
Limitaciones de CLIP
Qué NO puede hacer
- Generar texto (solo embeddings).
- Detectar objetos (no proporciona bounding boxes).
- Segmentar imágenes (no produce máscaras).
- Responder preguntas sobre contenido visual.
- Contar objetos con precisión.
Problemas conocidos
- Mezcla quién hace qué: "un perro persigue a un gato" y "un gato persigue a un perro" le parecen casi lo mismo.
- Sesgos heredados del dataset de entrenamiento.
- Confunde atributos visuales muy finos.
- Poca comprensión de negaciones en el prompt.
- Alta sensibilidad a la formulación del prompt.
BLIP: describir y responder
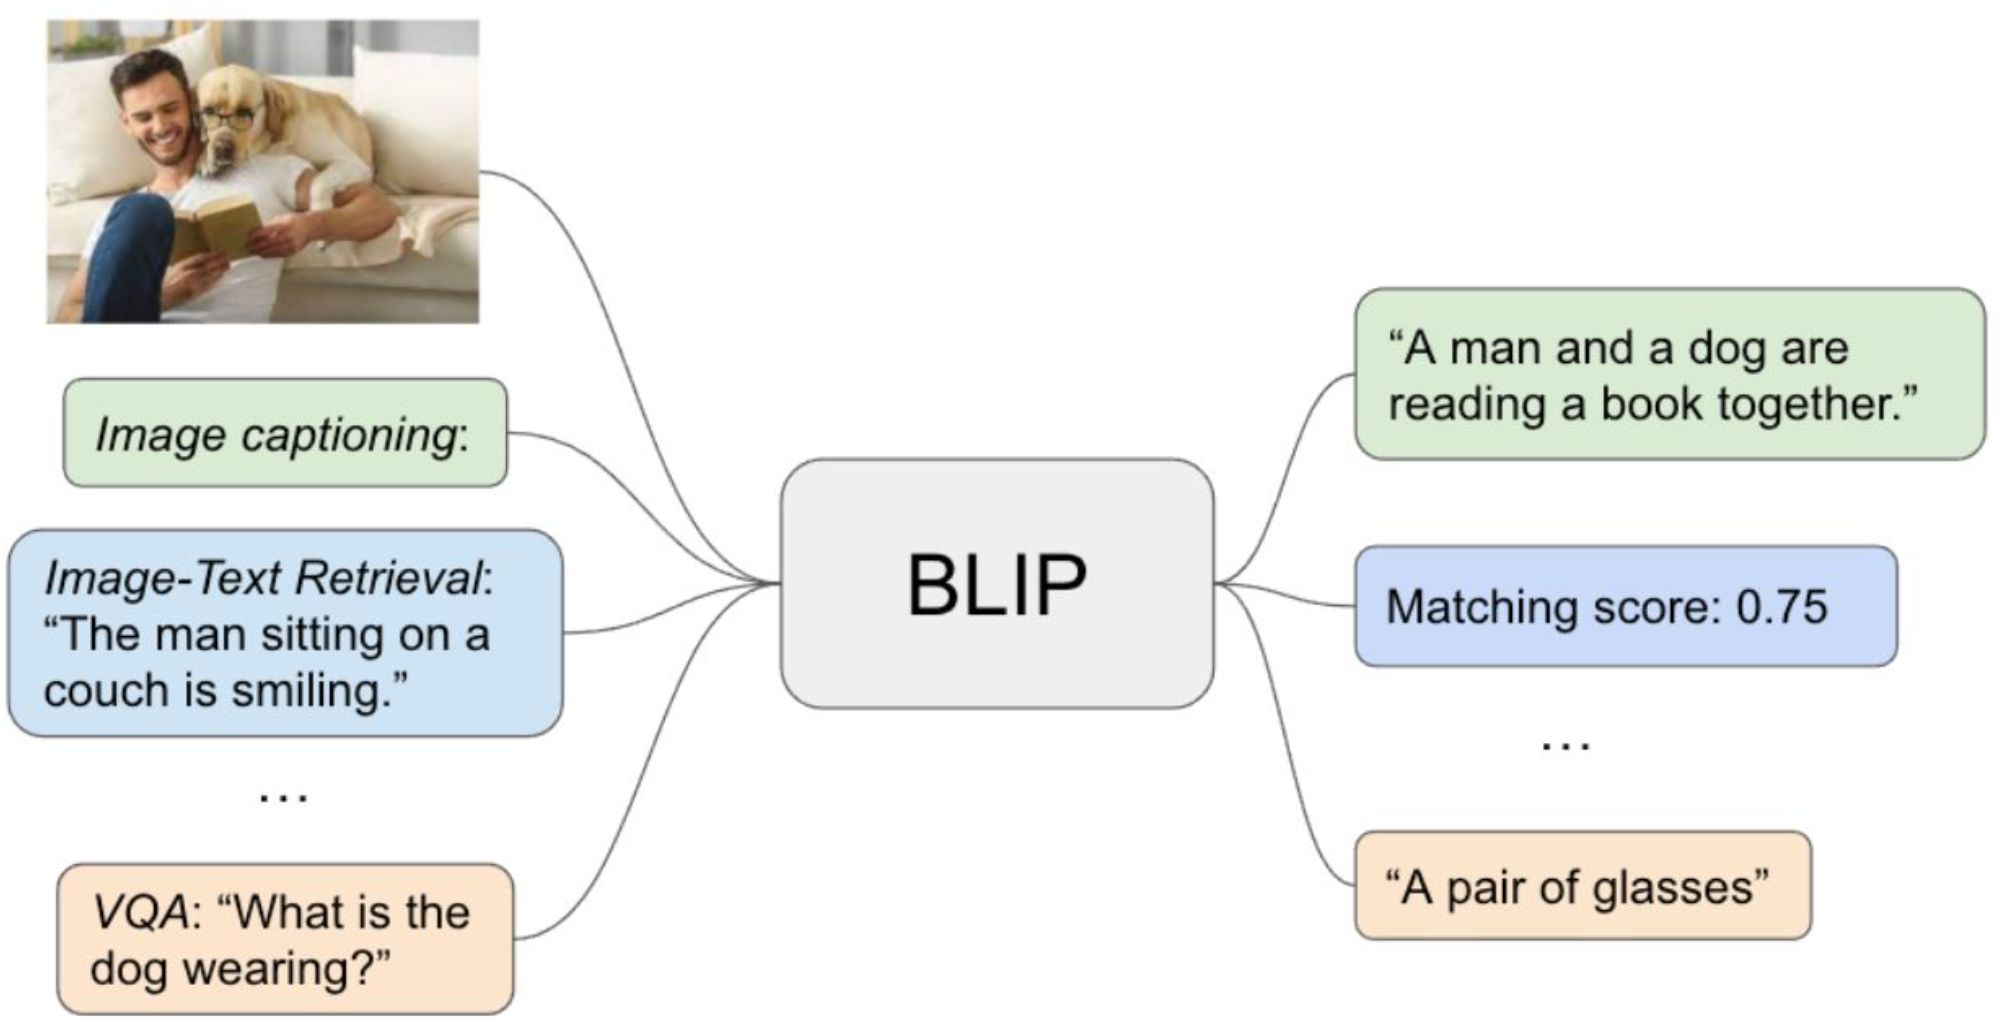
BLIP (Bootstrapping Language-Image Pre-training) también relaciona imágenes y texto, y además genera descripciones (captioning) y responde preguntas sobre la imagen (VQA).
Arquitectura: combina un encoder de imagen con un decoder de lenguaje basado en Transformers. La fusión multimodal ocurre mediante capas de cross-attention que permiten al texto "mirar" las features visuales.
- Documentación automática: generar descripciones de productos, escenas industriales o imágenes médicas.
- Accesibilidad: proporcionar descripciones textuales para personas con discapacidad visual.
- VQA simple: "¿Qué color tiene el casco?" → "Amarillo"; "¿Cuántas personas aparecen?" → "Dos".
Grounding DINO: localizar objetos descritos con texto
Grounding DINO une un detector, DINO, con un codificador de lenguaje para hacer detección guiada por lenguaje natural, sin una lista de clases fija.
Cómo funciona: le das un prompt textual ("encuentra todos los tornillos oxidados" o "localiza cascos amarillos") y el modelo devuelve bounding boxes para cada coincidencia, sin haber sido entrenado explícitamente en esas categorías.
- Elimina la necesidad de reentrenar para cada nueva categoría de objeto.
- Permite detección ad hoc: cambias el texto y cambias lo que detectas.
- Autoetiquetado: propone cajas para anotar un dataset en menos tiempo.
Ojo con el nombre. Aquí DINO es un detector de la familia DETR (Zhang et al., 2022). No tiene nada que ver con el DINO autosupervisado del tema 4, que aprende representaciones sin etiquetas: solo coinciden en el nombre.
Capacidades avanzadas
- Detección compositiva: "coches rojos y personas con cascos" → entiende atributos y combinaciones.
- Referring expressions: "la persona alta de la izquierda" → localización específica mediante descripciones.
Casos de uso y limitaciones de Grounding DINO
Casos de uso
- Inspección industrial sencilla: "defectos en soldadura", "tornillos faltantes", "grietas en superficie".
- Retail y e-commerce: "productos dañados", "etiquetas de precio", "artículos mal colocados".
- Seguridad: "personas sin casco", "vehículos en zona restringida", "objetos abandonados".
- Agricultura: "frutos maduros", "plagas en hojas", "equipos agrícolas".
Limitaciones
- Ambigüedad lingüística: prompts vagos ("cosa roja") pueden generar detecciones imprecisas.
- Objetos muy pequeños: rendimiento reducido en objetos menores al 1 % del área de imagen.
- Escenas complejas: dificultades con múltiples objetos superpuestos o muy similares.
- Dependencia del lenguaje: requiere descripciones precisas; no funciona bien con jerga técnica muy específica.
Localizar por texto
Los modelos multimodales se distinguen por su salida: texto, puntuación o cajas.
Respuesta C. Exacto: devuelve cajas a partir del texto, y hay que medir cómo acierta con tus imágenes.
CLIP puntúa textos frente a una imagen, BLIP genera lenguaje y Grounding DINO devuelve cajas. Para localizar un defecto nombrándolo, la salida que necesitas es una caja.
Cómo recibe la imagen un VLM
Codificador de imagen
Convierte la imagen en vectores, como hace CLIP (por ejemplo, un ViT o SigLIP).
Adaptador
Una capa pequeña que da a esos vectores el mismo formato que las palabras del texto.
Modelo de lenguaje
Recibe la imagen ya convertida junto con vuestra pregunta, como un único texto, y escribe la respuesta.
VLM: Qwen, un modelo para casi todo
Lo que hacen CLIP, BLIP y Grounding DINO por separado, y más, con un solo modelo. Solo cambia el prompt. Respuestas reales de Qwen3.5-2B (→):
Razonar
"¿Pueden arrancar ya los coches?"
→ No, porque hay un peatón cruzando la calle delante de ellos.
Leer texto
Placa electrónica: "¿Qué indica el texto y qué mide la placa?"
→ Pide poner el dedo en el sensor; probablemente mide el pulso.
Responder en JSON
"Devuelve el producto y la web impresos en la placa"
→ {"product": "Easy Pulse", "website": "www.Embedded-Lab.com"}
Conocer el mundo
Foto aérea: "¿Qué ciudad es y qué es la zona verde?"
→ Nueva York, Central Park.
Comparar imágenes
Dos telas: "¿Cuál está dañada y dónde?"
→ La segunda: un agujero deshilachado abajo a la izquierda.
Informe de inspección
"Devuelve defecto, tipo y posición en JSON"
→ {"defect": true, "type": "hole", "location": "bottom left"}
El precio: pesa y tarda más que CLIP o BLIP (4,55 GB de descarga y de uno a cinco segundos por respuesta en una T4). Para una tarea simple y repetida, un modelo especializado sigue siendo mejor opción.
Qwen3.5 entiende también castellano. Acepta imágenes de cualquier proporción sin deformarlas, lo que ayuda a leer documentos y letra pequeña. Las cajas cambian de escala según la versión: Qwen2.5-VL las da en píxeles, y Qwen3-VL y Qwen3.5 de 0 a 1000. Confundirlas no da error, solo dibuja las cajas fuera de sitio.
Qwen como detector
Pidiendo las cajas en JSON, detecta lo que le describáis: varias cosas a la vez, partes de un objeto o un defecto.
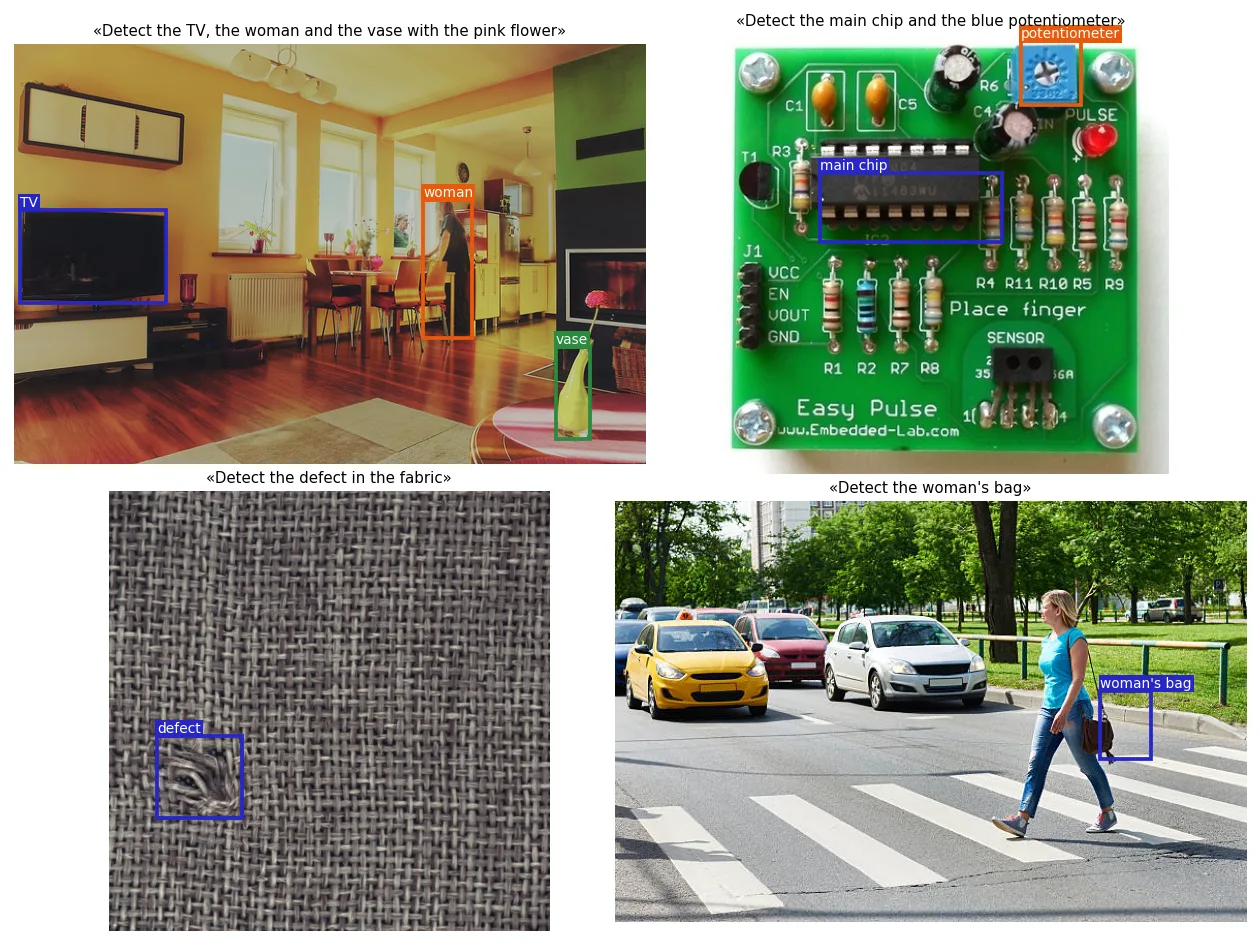
Si la tarea exige razonar antes de localizar, por ejemplo "la fruta que le cayó a Newton", funciona mejor en dos llamadas: primero se le pregunta qué fruta es y después se le pide que la detecte.
Cómo escribir el prompt
Cada familia de modelos espera un tipo de prompt distinto.
Para CLIP
- Usar templates como "una foto de {}".
- Múltiples formulaciones del mismo concepto.
- Evitar negaciones directas en el prompt.
Para Grounding DINO
- Separar conceptos con " . " (punto).
- Ser descriptivo pero conciso.
- Incluir los atributos que distinguen al objeto: color, forma, material.
Para Qwen y otros VLM
- Instrucciones claras y específicas.
- Especificar formato de salida (por ejemplo, JSON).
- Dar ejemplos concretos si es posible.
Malos prompts
- "¿Está bien?"
- "no hay personas sin casco"
Buenos prompts
- "Lista todos los defectos visibles en esta pieza metálica"
- "personas con casco . personas sin casco" (para comparar)
En inglés. CLIP y Grounding DINO aprendieron con textos en inglés. Los ejemplos están traducidos para leerlos mejor, pero en el código van en inglés: "person with helmet . person without helmet". Qwen sí entiende castellano.
¿Qué modelo uso para cada tarea?
La elección del modelo correcto depende de la complejidad de la tarea y las restricciones de latencia.
Regla de decisión rápida:
- ¿Velocidad y filtrar? → CLIP
- ¿Descripciones o Q&A simple? → BLIP
- ¿Localizar objetos por texto? → Grounding DINO
- ¿Razonamiento complejo o datos estructurados? → VLM
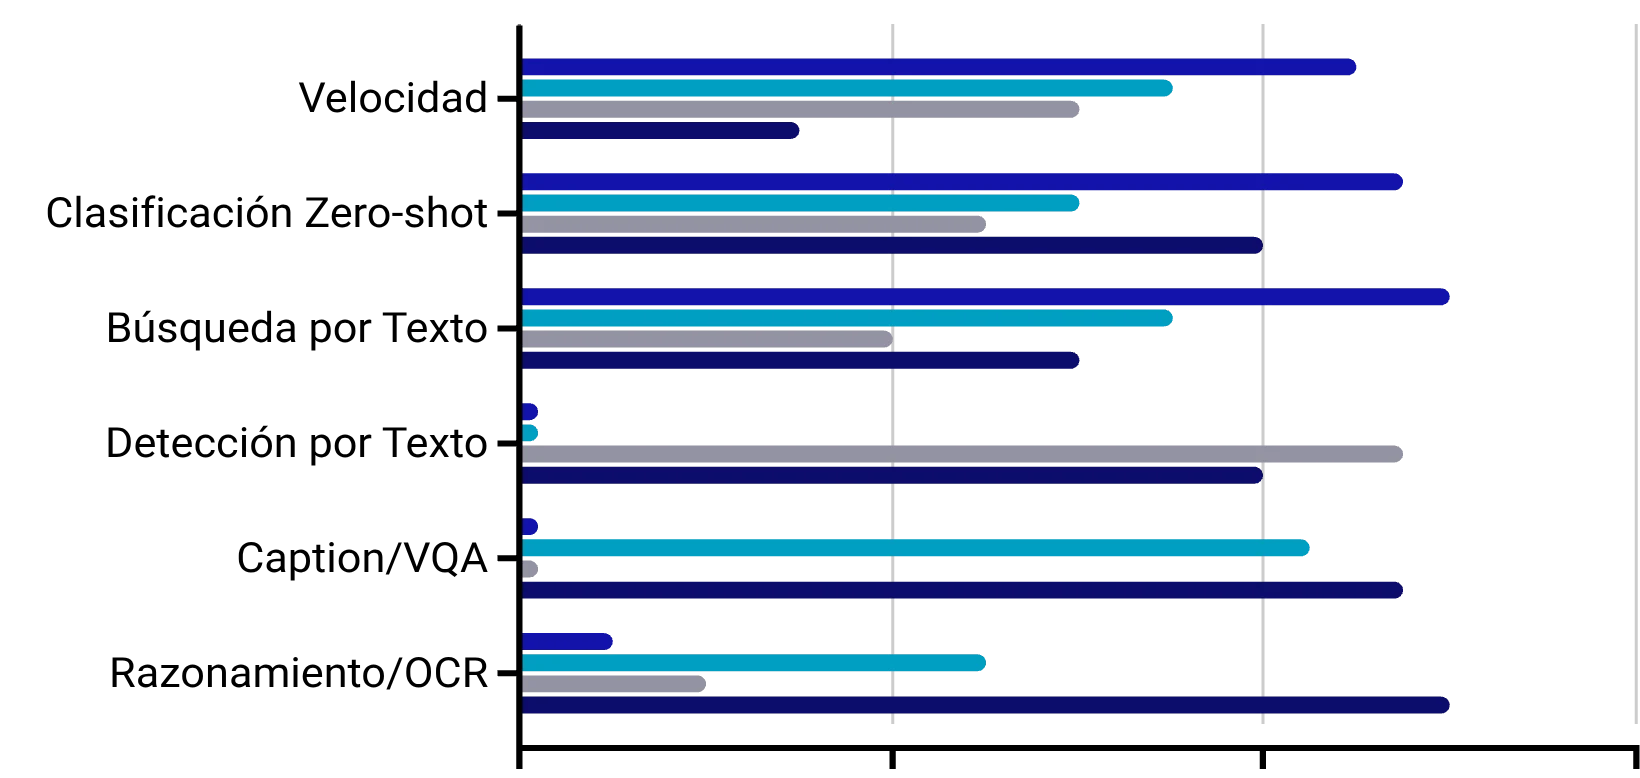
El gráfico ordena capacidades relativas, no mide latencia en un hardware concreto. Para decidir hay que medir en el dispositivo de destino con el tamaño de entrada real.
Elegir modelo
Cada familia resuelve bien una cosa y mal las demás.
Respuesta A. Exacto: BLIP escribe una descripción a partir de la imagen.
Generar una frase es tarea de un modelo generativo. CLIP solo puntúa textos que tú escribes y Grounding DINO devuelve cajas, no lenguaje.
Limitaciones y buenas prácticas
Formas habituales de fallar.
Alucinaciones: los modelos generativos pueden inventar detalles que no existen en la imagen. Especialmente común en VLM cuando preguntas sobre aspectos ambiguos.
Sesgos: los datos de entrenamiento contienen sesgos sociales y culturales que se reflejan en las predicciones. Valida siempre con datos representativos de tu población objetivo.
Prompts ambiguos: "encuentra el problema" puede dar resultados inconsistentes.
Estrategias de mitigación
- Ajusta los umbrales con tus datos: súbelos si hay muchos FP y bájalos si hay muchos FN. Cada modelo puntúa a su manera, así que no hay un valor de partida común.
- Valida con tus datos: los benchmarks públicos no garantizan rendimiento en tu dominio.
- Human-in-the-loop: en casos críticos (medicina, seguridad), siempre revisa las predicciones.
- Prompting específico: evita negaciones ("sin defectos"), prefiere afirmaciones ("tornillos en buen estado"). Pide formato de salida explícito (JSON con campos concretos).
¿Qué prompt escribiríais?
Dos casos. Elige el texto que funciona mejor.
Respuesta C. Correcto. Dos conceptos en positivo, separados por el punto que Grounding DINO usa para distinguirlos, y cada uno nombra algo visible.
Respuesta B. Correcto. Pide en positivo, fija el formato de salida y contempla explícitamente el caso sin defectos, que es donde más alucinan los generativos.
Las tres reglas que resuelven la mayoría de los casos: pedir en positivo en lugar de en negativo, nombrar lo que se busca en vez de preguntar si algo está bien, y separar conceptos con un punto cuando el modelo es Grounding DINO. Para un VLM, además, conviene decir el formato de salida que esperas.
Qué modelo elegir
Responde a dos preguntas y sale el modelo, con la línea para empezar.
CLIP
Ordena tus textos candidatos frente a la imagen. Es el más rápido y ligero, ideal como primer filtro de un catálogo. Sirve igual con poca o mucha latencia.
CLIPModel.from_pretrained("openai/clip-vit-base-patch32")
BLIP
Genera una descripción corta de la imagen, con un coste muy inferior al de un VLM.
BlipForConditionalGeneration.from_pretrained("Salesforce/blip-image-captioning-base")
BLIP, y un VLM si te quedas corto
Empieza por BLIP. Si necesitas que la frase razone o siga instrucciones, salta a un VLM como Qwen3.5 asumiendo el coste.
Salesforce/blip-image-captioning-base y, si hace falta, Qwen/Qwen3.5-2B
Grounding DINO
Le das una frase y devuelve cajas, sin haber sido entrenado en esa categoría. Separa conceptos con un punto. Sirve igual con poca o mucha latencia.
AutoModelForZeroShotObjectDetection.from_pretrained("IDEA-Research/grounding-dino-base")
Un VLM como Qwen3.5
Razona, compara y devuelve JSON con los campos que le pidas. Es el más pesado, así que resérvalo para donde aporte.
Qwen/Qwen3.5-2B
Replantea el problema
Razonar y extraer estructura es caro. Si necesitas volumen, resuelve primero con CLIP o Grounding DINO y manda al VLM solo los casos dudosos.
Si solo uno de cada diez casos llega al VLM, el coste baja casi diez veces y los casos dudosos siguen revisándose.
Antes de usar un modelo multimodal
Siete comprobaciones antes de usar estos modelos en un caso real.
- La lista de candidatos es completaCon CLIP el modelo elige siempre uno. Si falta la opción "ninguna", te devolverá la menos mala.
- Prompts en positivo"Tornillos en buen estado" en vez de "sin óxido". Las negaciones se entienden mal.
- Formato de salida pedido explícitamenteSi esperas JSON, dilo y da un ejemplo de los campos.
- Alucinaciones buscadas a propósitoPrueba con imágenes donde la respuesta correcta sea "no se ve". Un generativo tiende a inventar.
- Sesgos revisados con tus datosValida con población y escenarios representativos de tu uso real.
- Umbral ajustado, no heredadoParte del valor que traiga el modelo y muévelo según veas falsos positivos o negativos.
- Humano en el bucle donde importaMedicina, seguridad y decisiones sobre personas siempre con revisión.
Cuaderno 3: modelos multimodales
Los ejercicios están en el cuaderno. El extra, si da tiempo, lo hacemos juntos; si no, queda para casa.
- CLIP: clasificar sin entrenar
- BLIP: describir una imagen
- Grounding DINO: detectar lo que nombras
- Qwen3.5: preguntar, leer y detectar
- Extra: un prompt para cada modelo
- Para casa: Central Park, informe JSON y buscar fotos
En Colab: Archivo, Guardar una copia en Drive, y Entorno de ejecución, GPU T4.