Tema 03: Modelos multimodales
3. Multimodalidad: unir visión y lenguaje
Modelos fundacionales
Definición
Son modelos preentrenados a gran escala que aprenden representaciones generales y transferibles.
Importancia
Capturan patrones robustos gracias al preentrenamiento masivo y funcionan bien incluso en zero-shot.
Capacidades
Permiten reutilizar el conocimiento en muchas tareas, reducen anotación y evitan entrenar desde cero.
Ejemplos
- CLIP: 400 millones de pares imagen-texto.
- DINOv2: 142 millones de imágenes (sin etiquetas).
- SAM: 11 millones de imágenes y 1.000 millones de máscaras (segmentaciones).
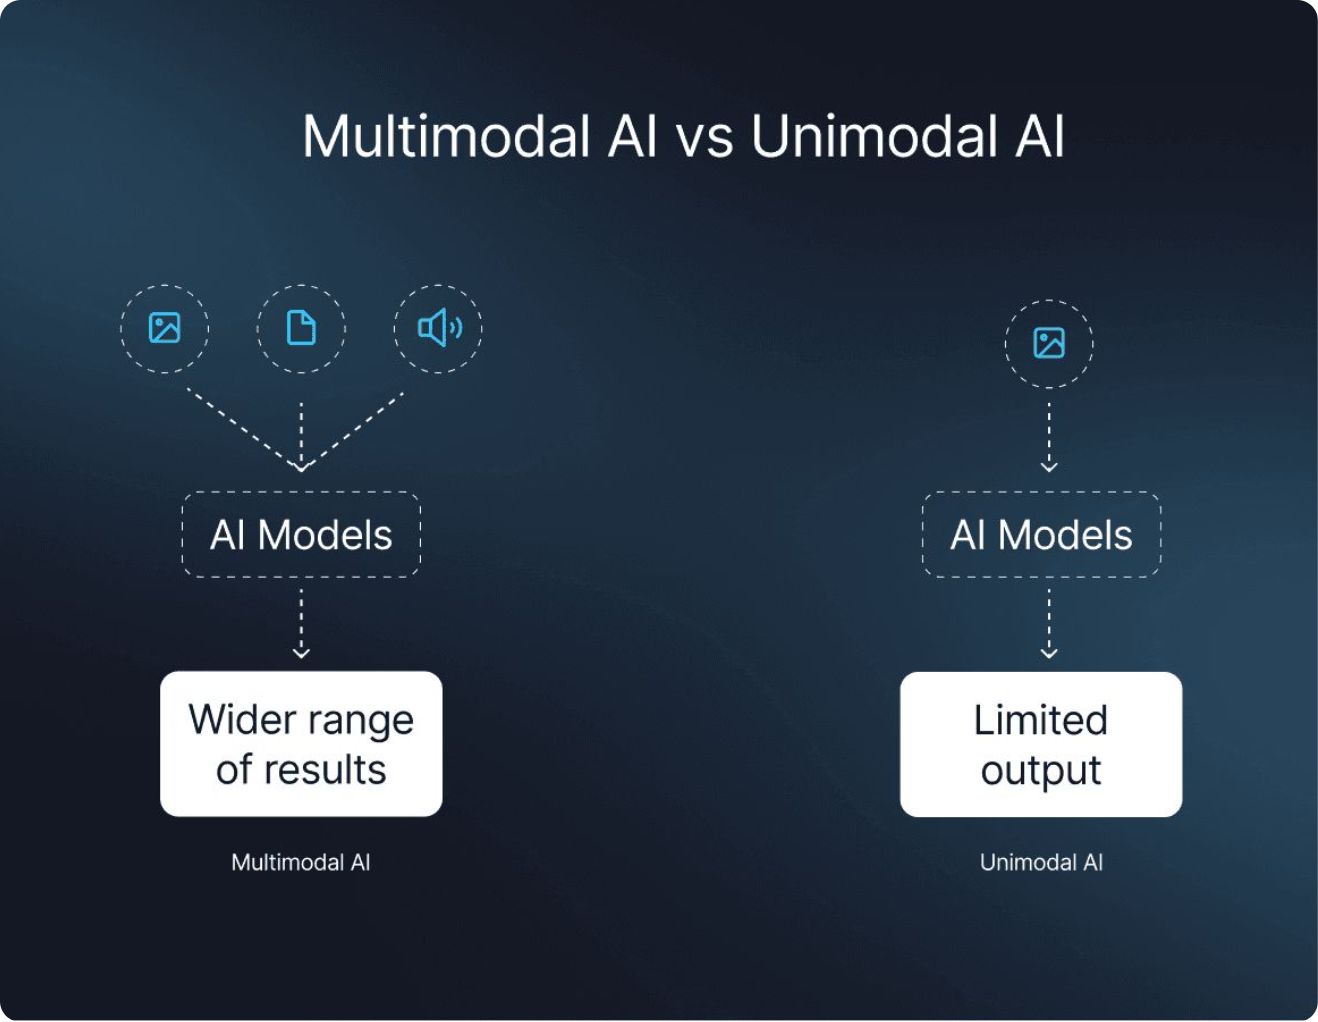
Multimodalidad
Zero-shot y composicionalidad
Impacto en producción
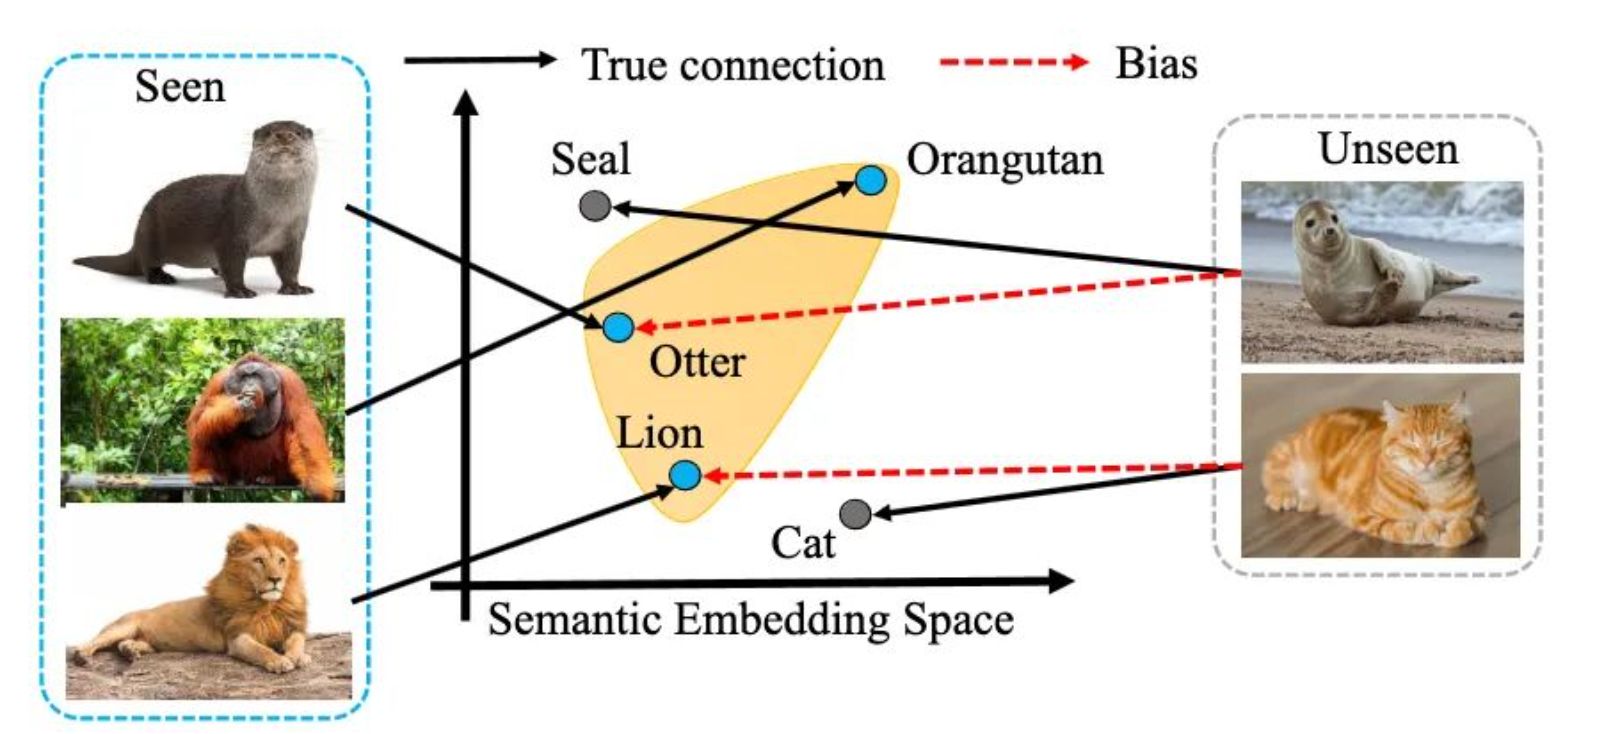
Categorías nuevas sin reentrenar
En zero-shot, las clases llegan como texto y no como una cabeza reentrenada.
Respuesta A. Exacto: CLIP ordena categorías propuestas como texto.
La composicionalidad permite combinar atributos como «rojo», «perro» y «corriendo». Esto acelera la experimentación, aunque las categorías propuestas y la formulación de los textos pueden cambiar el resultado.
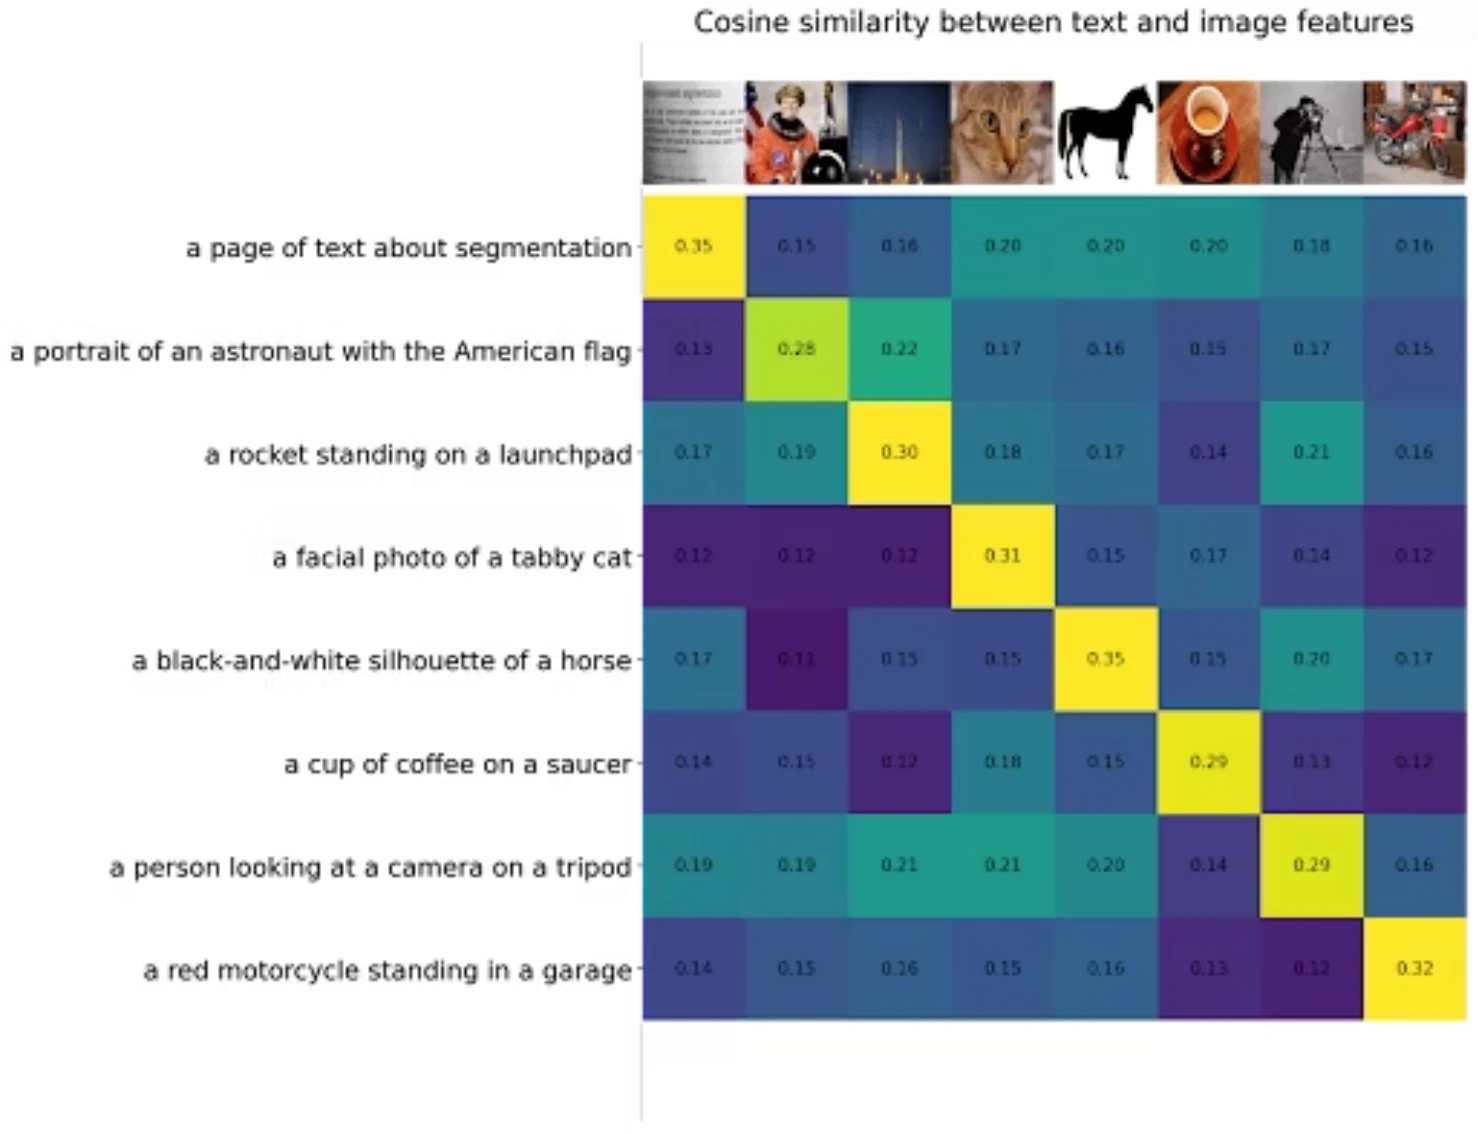
CLIP: imagen - texto (Retrieval/Zero-Shot)
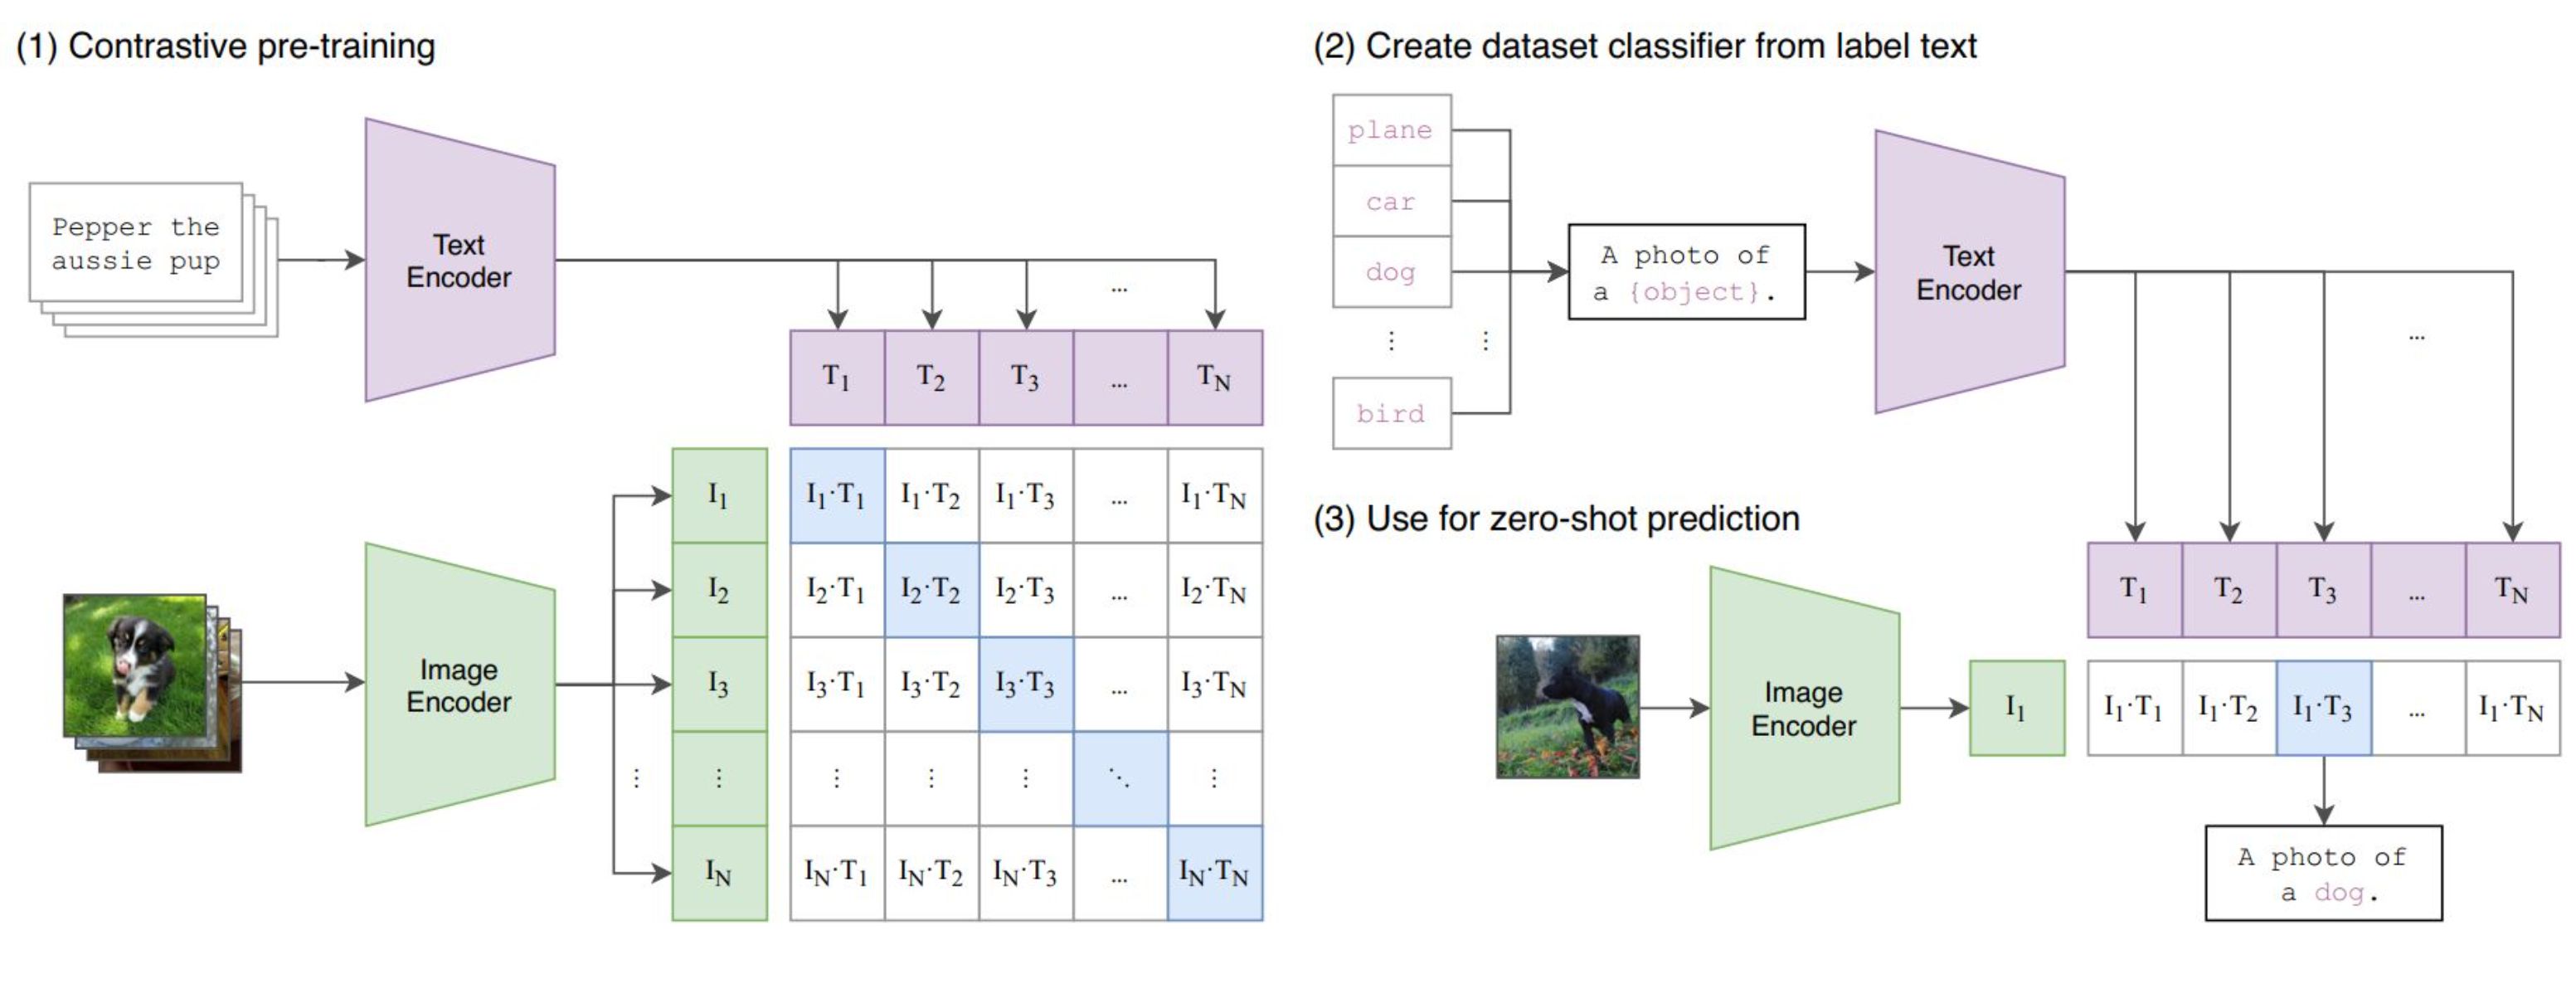
Cómo funciona CLIP
-
Imagen a vector
La imagen se convierte en un vector (embedding) con el Image Encoder.
-
Textos a vectores
Los textos de las posibles clases se convierten en vectores con el Text Encoder.
-
Cálculo de similitud
Se calcula la similitud entre el vector de la imagen y cada vector de texto.
-
Predicción
La clase con mayor similitud es la predicción final del modelo.
Gana el texto más cercano
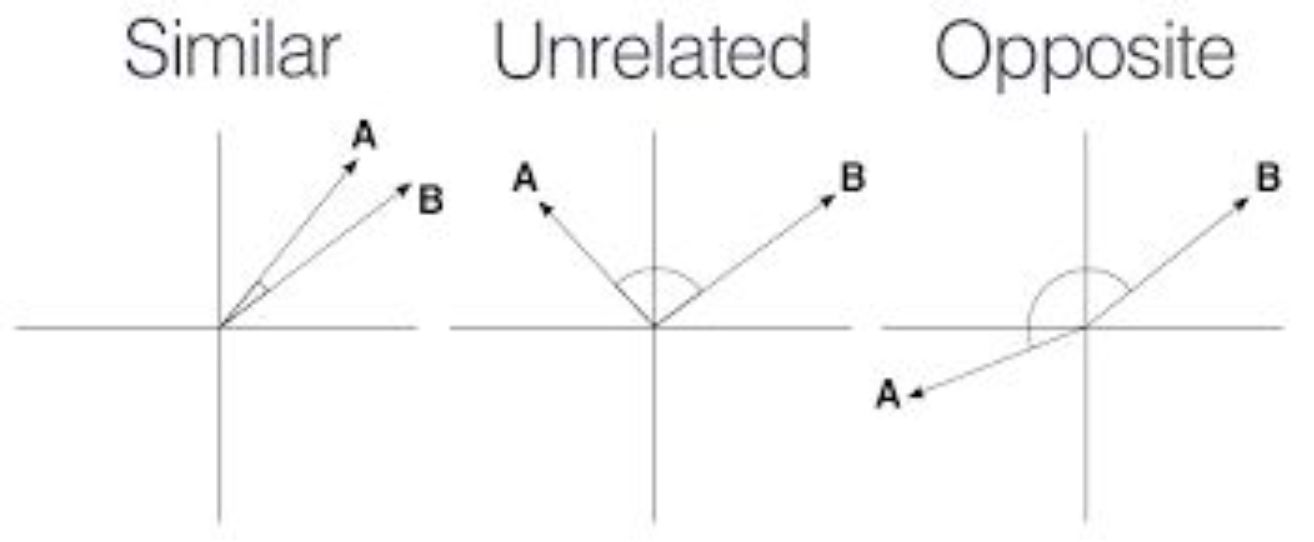
La similitud coseno compara direcciones, no longitudes: mueve la imagen y mira qué texto se queda más cerca.
Los cuatro textos están a distancias distintas del origen y aun así solo cuenta el ángulo. Las líneas de puntos unen los dos que el modelo ha dejado cerca: gato con perro, bicicleta con coche.
- un gato distancia 0,46 0,99
- un perro distancia 0,17 0,96
- una bicicleta distancia 1,18 −0,17
- un coche distancia 0,96 −0,53
La similitud coseno solo mira el ángulo entre vectores: vale 1 cuando apuntan igual, 0 cuando son perpendiculares y −1 cuando se oponen. Por eso dos vectores de longitud muy distinta pueden ser casi idénticos para el modelo, como pasa aquí con la imagen y «un gato». La longitud de un embedding recoge sobre todo cuánta señal tiene el parche o el texto, no de qué habla, así que la práctica habitual es normalizar los vectores antes de guardarlos; con vectores normalizados, ordenar por coseno y ordenar por distancia euclídea dan el mismo resultado, y la distancia deja de estorbar. La agrupación tampoco es casual: los conceptos que aparecen juntos en los pares de entrenamiento acaban en direcciones próximas, y por eso gato y perro caen a un lado y bicicleta y coche al otro. De ahí se siguen dos consecuencias prácticas: la lista de candidatos condiciona la respuesta, porque el modelo elige siempre uno, y la formulación del texto desplaza su vector, así que reescribir el prompt puede cambiar el ganador sin tocar la imagen.
Entrenamiento de CLIP: aprendiendo por asociación
-
La entrada: arquitectura de dos torres
CLIP utiliza dos codificadores independientes que trabajan en paralelo, proyectando la información a un espacio compartido. El Image Encoder (Vision Transformer o ResNet) convierte la imagen en un vector numérico (embedding). El Text Encoder (un Transformer) convierte la descripción textual en otro vector numérico.
-
El proceso: la matriz de N × N
El modelo recibe un lote (batch) de N imágenes y sus N textos correspondientes, creando una matriz de N × N posibles parejas. En un lote de 32.000 pares, se generan 32.000 parejas correctas y millones de combinaciones incorrectas.
-
El objetivo: maximizar la diagonal
El modelo se entrena con una única regla simple (Contrastive Loss):
- Aumentar la similitud (producto escalar) de los pares correctos (en la diagonal).
- Disminuir la similitud de todas las combinaciones incorrectas (fuera de la diagonal).
Limitaciones de CLIP
Qué NO puede hacer
- Generar texto (solo embeddings).
- Detectar objetos (no proporciona bounding boxes).
- Segmentar imágenes (no produce máscaras).
- Responder preguntas sobre contenido visual.
- Contar objetos con precisión.
Problemas conocidos
- Mal rendimiento con texto dentro de imágenes (OCR).
- Sesgos heredados del dataset de entrenamiento.
- Confunde atributos visuales muy finos.
- Poca comprensión de negaciones en el prompt.
- Alta sensibilidad a la formulación del prompt.
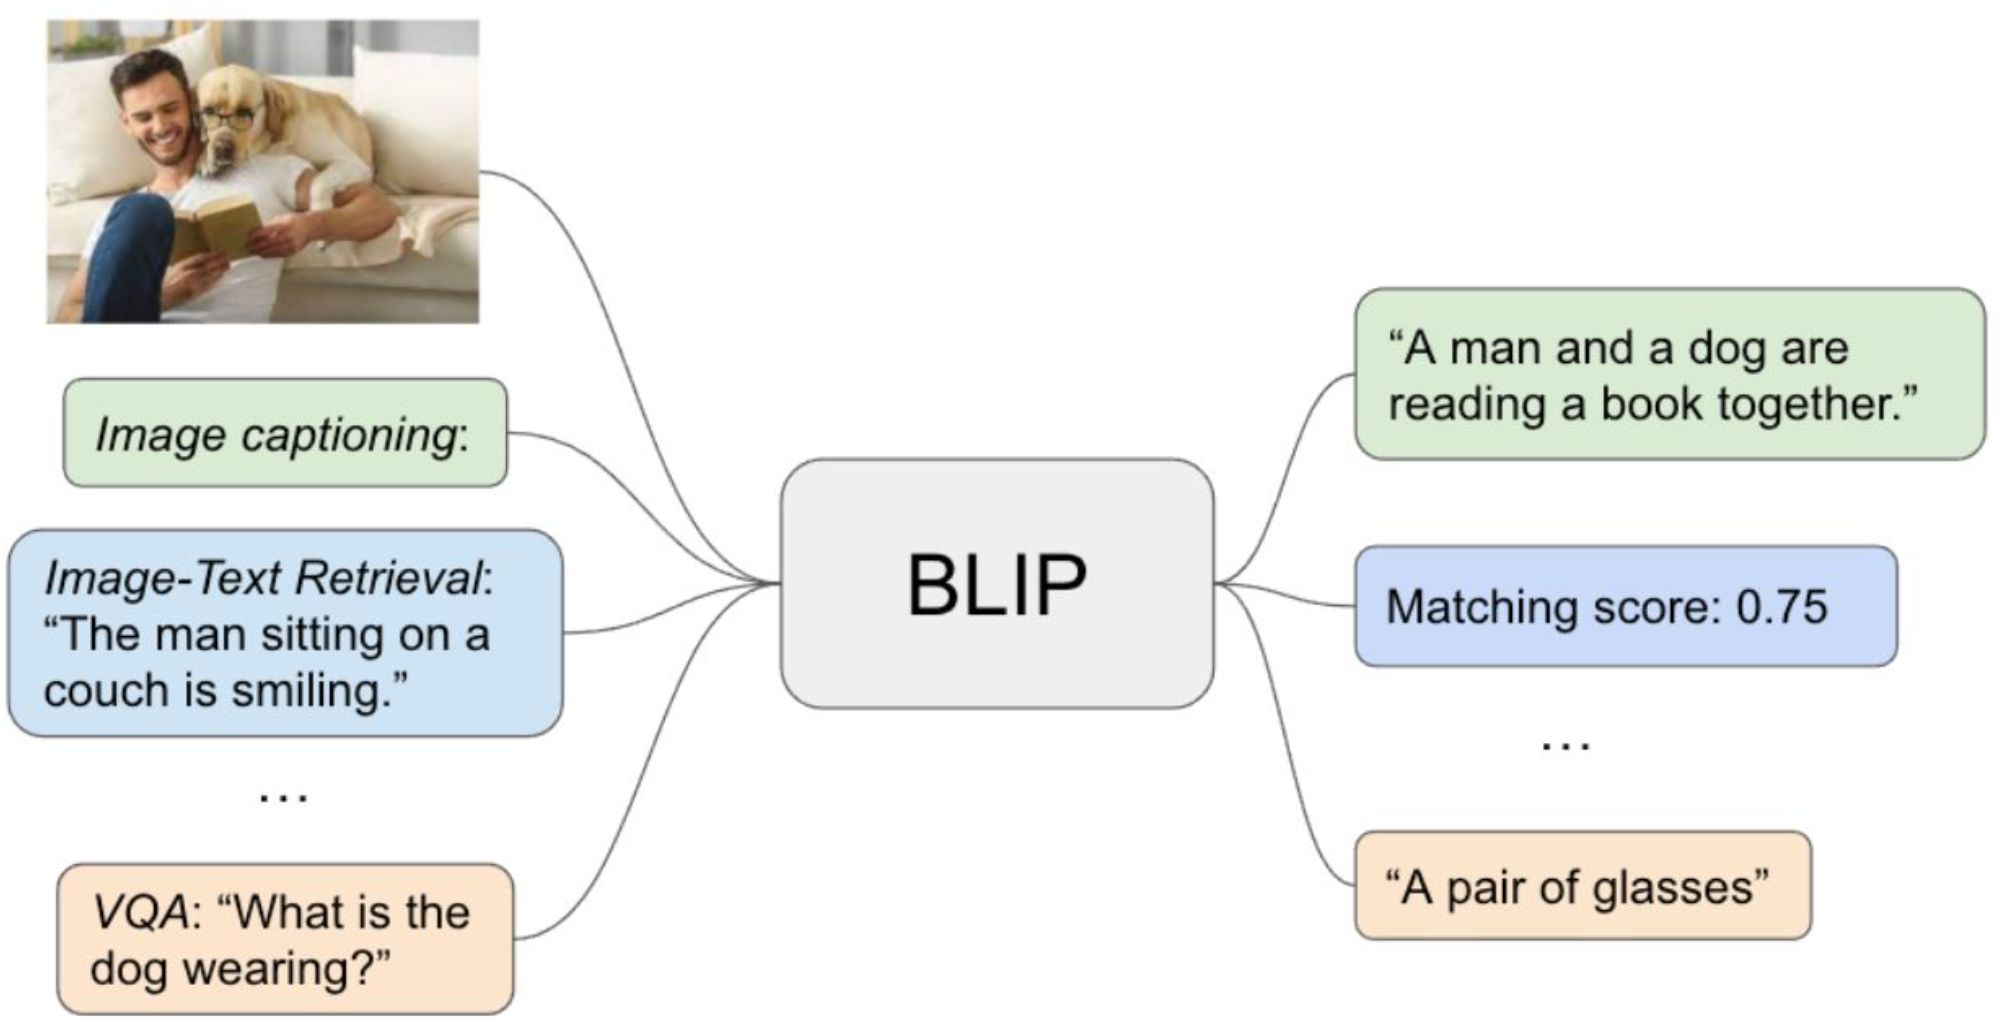
BLIP: describe y responde (generativo)
Grounding DINO: texto → cajas (Open-Vocabulary)
Capacidades avanzadas
Cómo funciona Grounding DINO
-
Codificación de texto
El prompt textual («coche rojo y persona») se transforma en features lingüísticas ricas en significado a través de un modelo BERT.
-
Codificación de imagen
La imagen de entrada es procesada por un Swin Transformer para extraer features visuales de alta resolución.
-
Fusión de características
Mediante atención cruzada intermodal, las features de texto guían la interpretación visual, alineando el lenguaje con las regiones espaciales relevantes de la imagen.
-
Detección head
Un decoder Transformer usa estas features fusionadas para predecir las bounding boxes y las clases de los objetos, todo en base al prompt original.
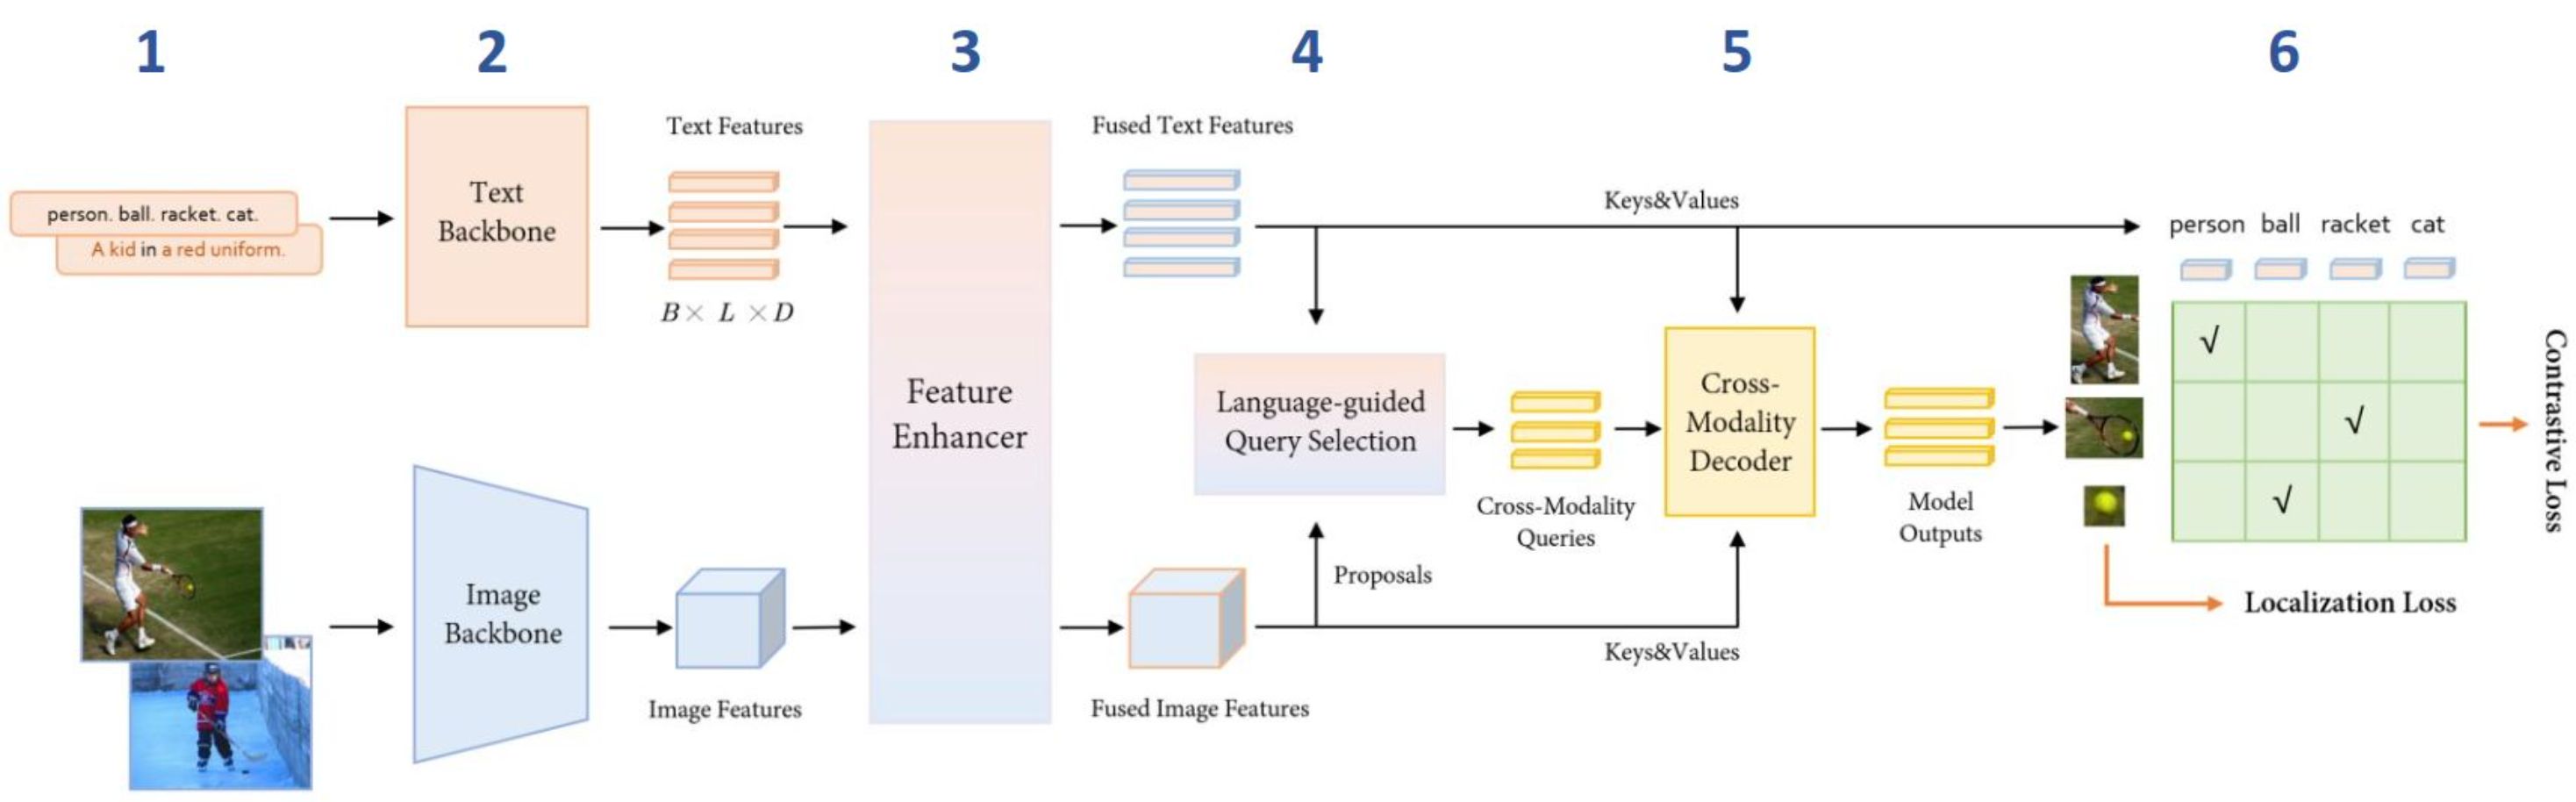
Innovaciones de Grounding DINO
Detección sin anchors
A diferencia de métodos clásicos, no requiere cajas predefinidas, lo que simplifica y flexibiliza el proceso.
Sin NMS necesario
Evita el post-procesamiento de Non-Maximum Suppression, optimizando la predicción de cajas.
Queries guiadas por lenguaje
El texto dirige directamente qué y dónde buscar en la imagen.
Atención cruzada
Permite una profunda interacción entre las representaciones visuales y lingüísticas.
Vocabulario abierto
COCO: 80 clases fijas → Grounding DINO: infinitas clases, cualquier texto describible.
Casos de uso y limitaciones de Grounding DINO
Casos de uso
- Inspección industrial sencilla: «defectos en soldadura», «tornillos faltantes», «grietas en superficie».
- Retail y e-commerce: «productos dañados», «etiquetas de precio», «artículos mal colocados».
- Seguridad: «personas sin casco», «vehículos en zona restringida», «objetos abandonados».
- Agricultura: «frutos maduros», «plagas en hojas», «equipos agrícolas».
Limitaciones
- Ambigüedad lingüística: prompts vagos («cosa roja») pueden generar detecciones imprecisas.
- Objetos muy pequeños: rendimiento reducido en objetos menores al 1 % del área de imagen.
- Escenas complejas: dificultades con múltiples objetos superpuestos o muy similares.
- Dependencia del lenguaje: requiere descripciones precisas; no funciona bien con jerga técnica muy específica.
Nombrar para localizar
Los modelos multimodales se distinguen por su salida: texto, puntuación o cajas.
Respuesta A. Exacto: el prompt guía la búsqueda, pero la evaluación valida el uso.
CLIP puntúa textos frente a una imagen, BLIP genera lenguaje y Grounding DINO devuelve cajas. Para localizar un defecto nombrándolo, la salida que necesitas es una caja.
Anatomía de un VLM: ¿cómo ve el LLM?
Vision encoder (ojos)
Extrae features visuales de la imagen (por ejemplo ViT o SigLIP), transformando píxeles en una representación numérica de alto nivel.
Projector / Adapter (traductor)
Una capa (MLP o Linear) que convierte las features visuales en «tokens visuales», adaptándolos para que tengan el mismo tamaño y formato que los tokens de texto.
LLM Backbone (cerebro)
Recibe [tokens de sistema] + [tokens visuales] + [tokens de usuario] como una única secuencia. La imagen se convierte en una secuencia de tokens pseudo-palabras que se concatenan al prompt de texto.
VLM (Qwen2.5/3-VL): conversa y razona sobre imágenes
Mejores prácticas de prompting
Para CLIP
- Usar templates como «una foto de {}».
- Múltiples formulaciones del mismo concepto.
- Evitar negaciones directas en el prompt.
Para Grounding DINO
- Separar conceptos con « . » (punto).
- Ser descriptivo pero conciso.
- Incluir atributos visuales clave.
Para Qwen y otros VLM
- Instrucciones claras y específicas.
- Especificar formato de salida (por ejemplo, JSON).
- Dar ejemplos concretos si es posible.
Malos prompts
- «¿Está bien?»
- «no hay personas sin casco»
Buenos prompts
- «Lista todos los defectos visibles en esta pieza metálica»
- «personas con casco . personas sin casco» (para comparar)
¿Qué modelo uso para cada tarea?
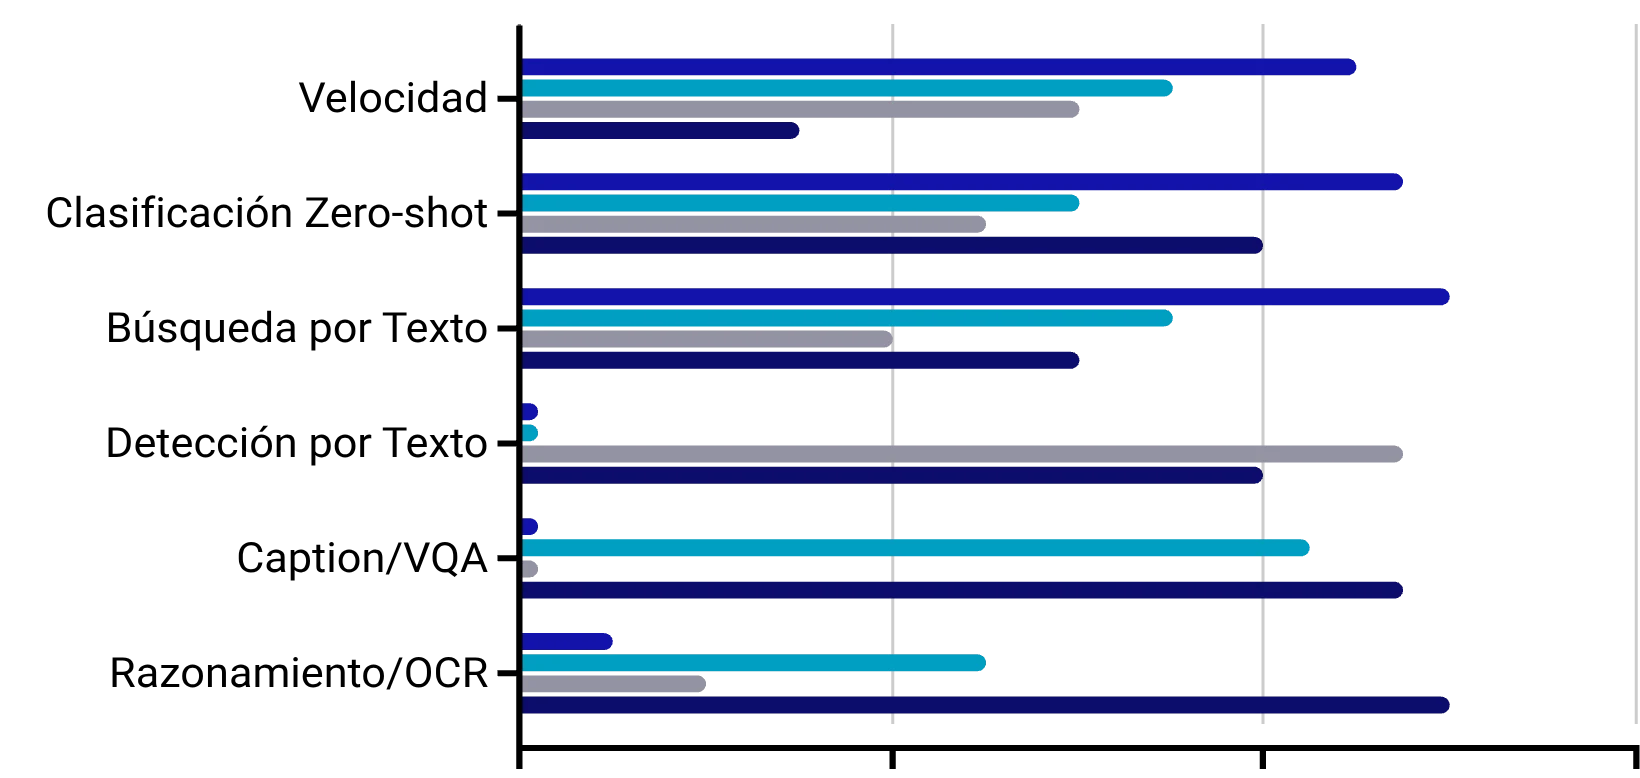
El gráfico ordena capacidades relativas, no mide latencia en un hardware concreto. Para decidir hay que medir en el dispositivo de destino con el tamaño de entrada real.
Aplica la regla de decisión
Cada familia resuelve bien una cosa y mal las demás.
Respuesta A. Exacto: BLIP genera texto condicionado por una imagen.
Generar una frase es tarea de un modelo generativo. CLIP solo puntúa textos que tú escribes y Grounding DINO devuelve cajas, no lenguaje.
Limitaciones y buenas prácticas
Estrategias de mitigación
Clasificar sin entrenar nada
Escribes las clases como texto y CLIP te ordena cuál encaja mejor.
import torch
from PIL import Image
from transformers import CLIPProcessor, CLIPModel

clip_id = "openai/clip-vit-base-patch32"
processor = CLIPProcessor.from_pretrained(clip_id)
model = CLIPModel.from_pretrained(clip_id)

image = Image.open("mi_imagen.jpg").convert("RGB")
clases = ["una foto de una pieza en buen estado",
          "una foto de una pieza con óxido",
          "una foto de una pieza rota"]

inputs = processor(text=clases, images=image, return_tensors="pt", padding=True)
with torch.no_grad():
    probs = model(**inputs).logits_per_image.softmax(dim=1)[0]

for clase, p in zip(clases, probs):
print(f"{p:.2f} {clase}")Taller de prompts
Dos prompts que fallan en clase y cómo se arreglan.
Respuesta C. Correcto. Dos conceptos en positivo, separados por el punto que Grounding DINO usa para distinguirlos, y cada uno nombra algo visible.
Respuesta B. Correcto. Pide en positivo, fija el formato de salida y contempla explícitamente el caso sin defectos, que es donde más alucinan los generativos.
Las tres reglas que resuelven la mayoría de los casos: pedir en positivo en lugar de en negativo, nombrar lo que se busca en vez de preguntar si algo está bien, y separar conceptos con un punto cuando el modelo es Grounding DINO. Para un VLM, además, conviene decir el formato de salida que esperas.
¿Cuál de los cuatro te sirve?
Responde a dos preguntas y sale el modelo, con la línea para empezar.
CLIP
Ordena tus textos candidatos frente a la imagen. Es el más rápido y ligero, ideal como primer filtro de un catálogo.
CLIPModel.from_pretrained("openai/clip-vit-base-patch32")
BLIP
Genera descripciones y responde preguntas sencillas sobre la imagen, con un coste muy inferior al de un VLM.
BlipForConditionalGeneration.from_pretrained("Salesforce/blip-image-captioning-base")
BLIP, y un VLM si te quedas corto
Empieza por BLIP. Si necesitas que la frase razone o siga instrucciones, salta a Qwen-VL asumiendo el coste.
Salesforce/blip-image-captioning-base y, si hace falta, Qwen/Qwen2.5-VL-7B-Instruct
Grounding DINO
Le das una frase y devuelve cajas, sin haber sido entrenado en esa categoría. Separa conceptos con un punto.
AutoModelForZeroShotObjectDetection.from_pretrained("IDEA-Research/grounding-dino-base")
Un VLM como Qwen2.5-VL
Razona, compara y devuelve JSON con los campos que le pidas. Es el más pesado, así que resérvalo para donde aporte.
Qwen/Qwen2.5-VL-7B-Instruct
Replantea el problema
Razonar y extraer estructura es caro. Si necesitas volumen, resuelve primero con CLIP o Grounding DINO y manda al VLM solo los casos dudosos.
Ese filtrado en dos etapas suele bajar el coste un orden de magnitud sin perder los casos que importan.
Antes de fiarte de una salida multimodal
Siete comprobaciones para modelos que hablan con mucha seguridad.
- La lista de candidatos es completaCon CLIP el modelo elige siempre uno. Si falta la opción «ninguna», te devolverá la menos mala.
- Prompts en positivo«Tornillos en buen estado» en vez de «sin óxido». Las negaciones se entienden mal.
- Formato de salida pedido explícitamenteSi esperas JSON, dilo y da un ejemplo de los campos.
- Alucinaciones buscadas a propósitoPrueba con imágenes donde la respuesta correcta sea «no se ve». Un generativo tiende a inventar.
- Sesgos revisados con tus datosValida con población y escenarios representativos de tu uso real.
- Umbral ajustado, no heredadoEmpieza en 0,5 y muévelo según veas falsos positivos o negativos.
- Humano en el bucle donde importaMedicina, seguridad y decisiones sobre personas siempre con revisión.
Cuatro formas de mirar
Compara CLIP, BLIP, Grounding DINO y Qwen con la misma imagen.
- Guarda una copia en Drive.
- Cambia imagen y prompts.
- Contrasta salidas y errores.
Usa la misma imagen para separar capacidades: CLIP ordena textos, BLIP genera una descripción, Grounding DINO localiza conceptos y Qwen responde instrucciones. Registra el prompt, el modelo y el error observado; una salida más larga o fluida no implica una respuesta más correcta.