Tema 05: Segmentación con SAM
Modelos fundacionales en visión artificial
Tema 5: Segmentación con SAM
Día 2 del curso
- Web del curso
- datamecum.sergiovillanuevalopez.com
- Práctica
- Cuaderno 5 en Colab (5_SAM.ipynb)
- Profesor
- Sergio Villanueva · Datamecum
5. SAM: Segment Anything (v1, v2, v3)
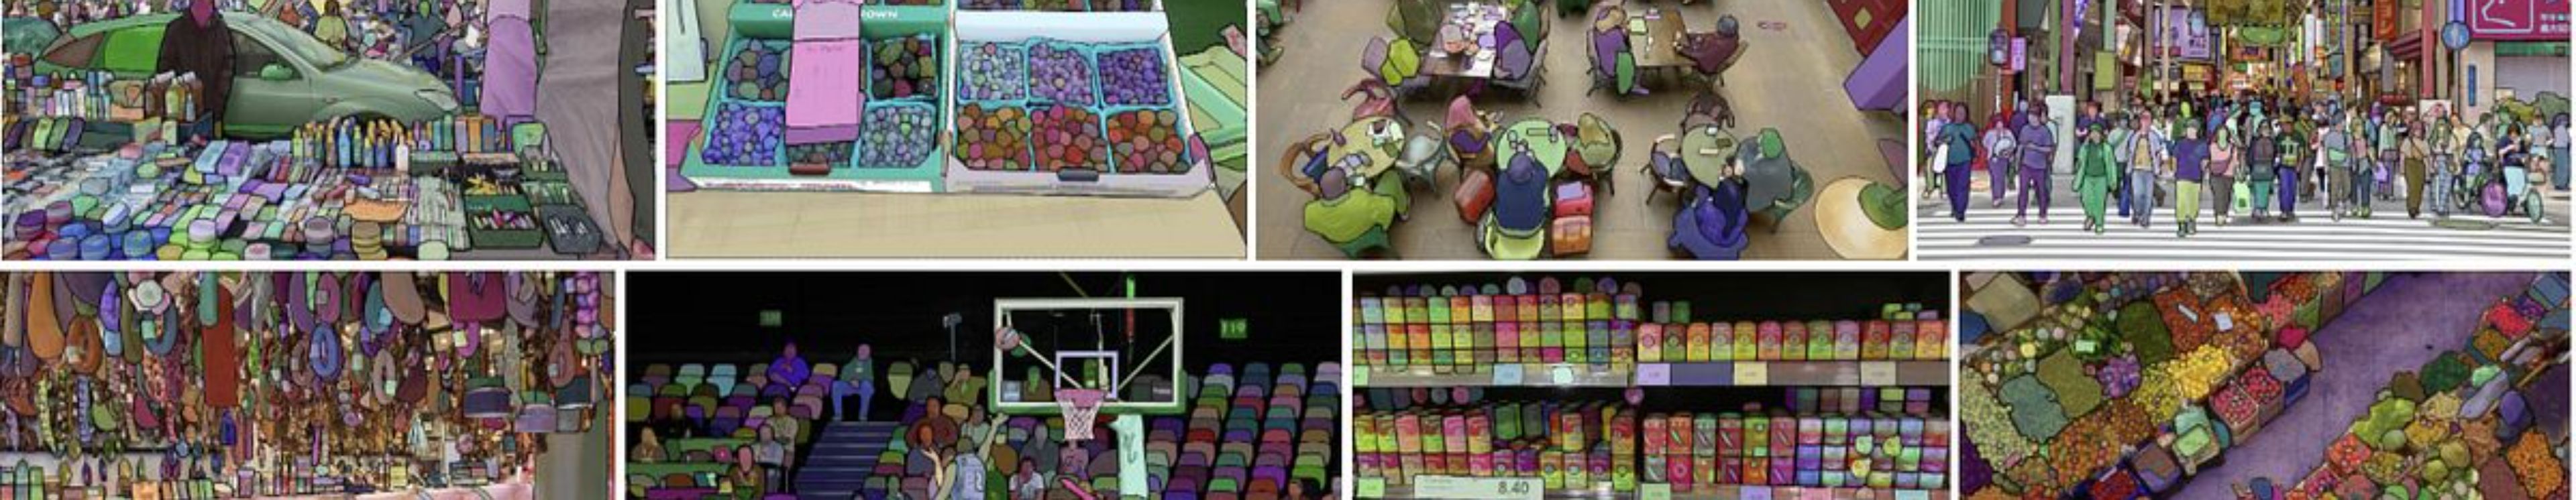
¿Qué es segmentación?
Tipos de segmentación
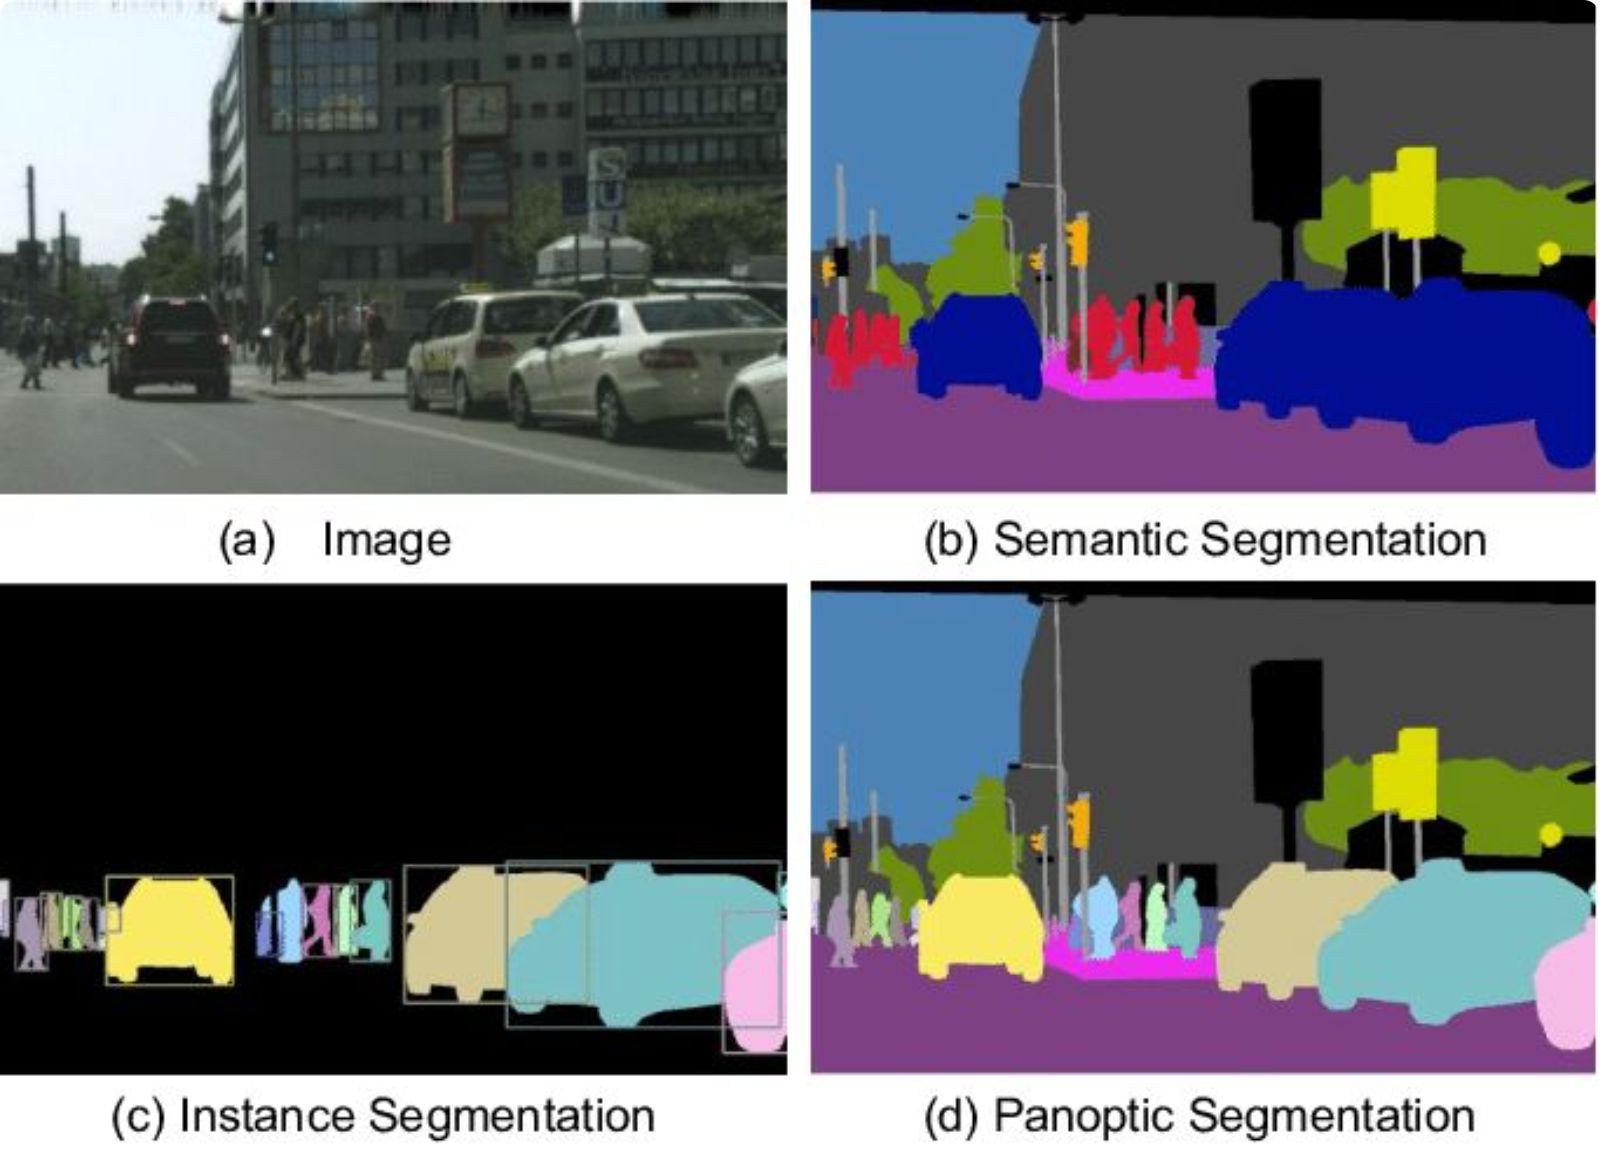
Semántica
Cada píxel se clasifica en una categoría (por ejemplo, "coche", "persona", "fondo"). No distingue entre instancias individuales del mismo tipo de objeto: todos los coches reciben la misma máscara y etiqueta.
Por instancias
Cada objeto individual detectado recibe una máscara única y su propia etiqueta. Permite distinguir entre objetos del mismo tipo, como "coche 1", "coche 2", "persona A", "persona B".
Panóptica
Combina la segmentación semántica y por instancias. Asigna una máscara única y una etiqueta a cada instancia de objeto cubriendo toda la imagen. Es la más completa pero también la más compleja.
Cómo funciona SAM
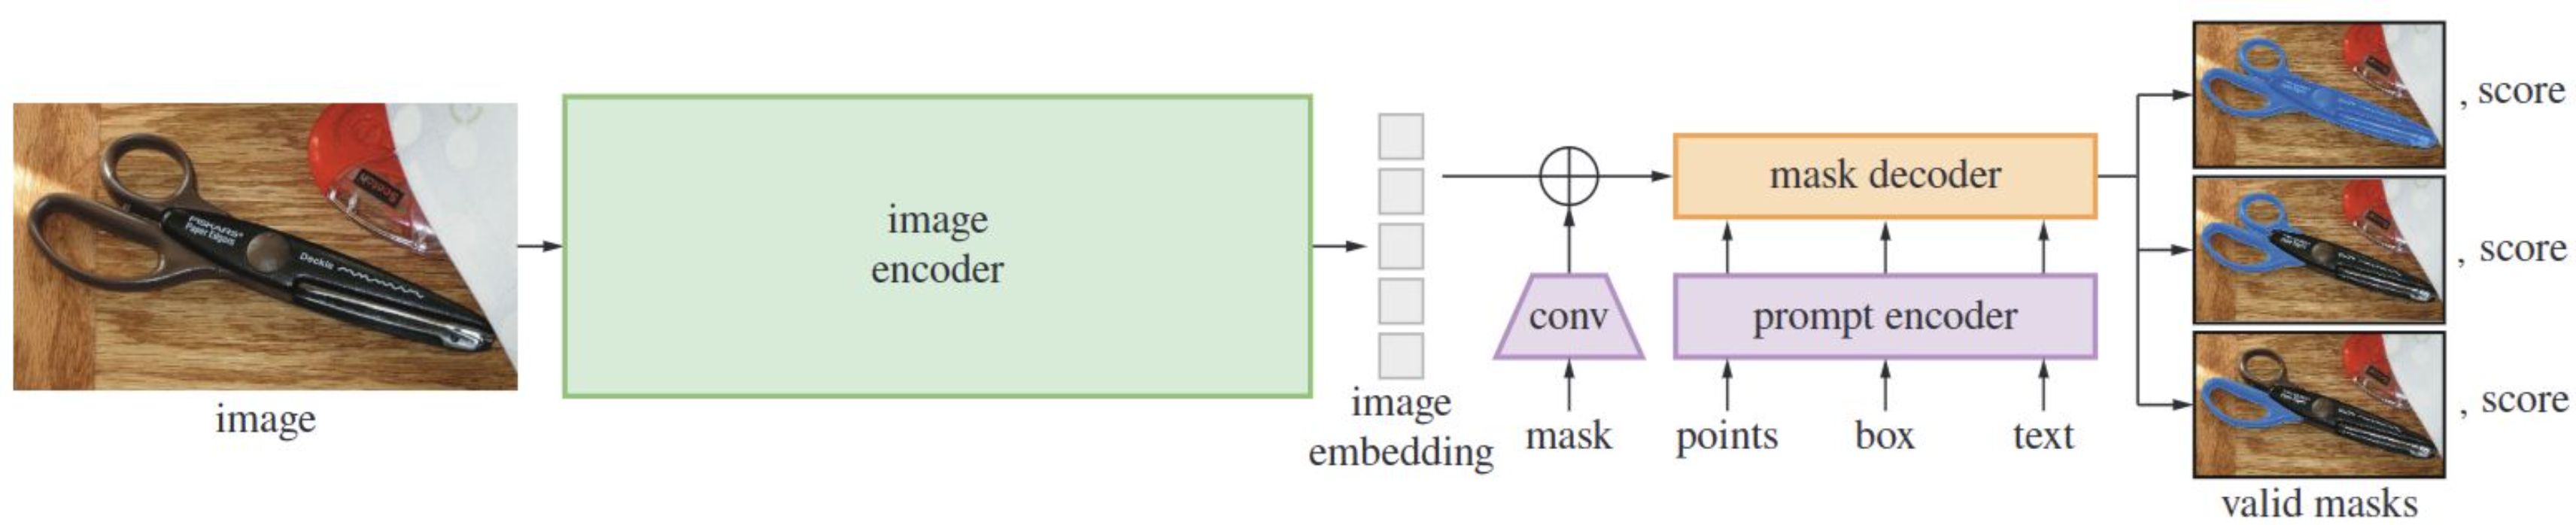
Codificador de imagen (lo pesado)
Un ViT grande convierte la imagen en un mapa de características. Se ejecuta una vez por imagen y el resultado se reutiliza para todos los clics.
Codificador de indicaciones
Convierte los puntos, las cajas o una máscara previa en vectores. Es casi instantáneo.
Decodificador de máscaras
Junta las dos cosas y devuelve tres máscaras candidatas (objeto, parte y subparte) con su puntuación. Tarda unos 50 ms, incluso en el navegador.
Evolución: SAM → SAM 2 → SAM 3
-
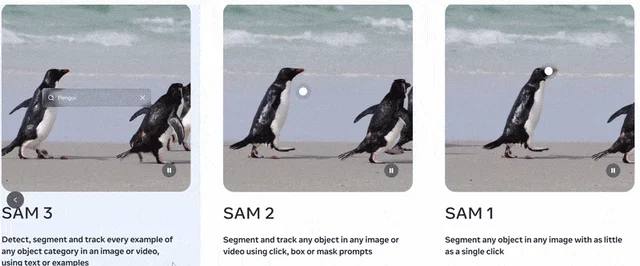
2023 · SAM 1
Segmentación universal en imagen con prompts de puntos y cajas. Dataset SA-1B: unos 11 millones de imágenes y 1.100 millones de máscaras.
-
2024 · SAM 2
Extiende a vídeo con memoria en streaming; más preciso y hasta 6 veces más rápido que SAM 1 en imagen. Dataset SA-V: unos 51.000 vídeos y 643.000 masklets.
-
2025 · SAM 3
Modelo unificado que detecta, segmenta y sigue todas las instancias de un concepto, dado por texto o por ejemplos, en imagen y vídeo.
Motor de datos: 1.100 millones de máscaras
-
Anotación asistida
Personas anotan con una herramienta que ya usa una primera versión de SAM: hacen clics y corrigen la máscara. El modelo se reentrena con lo anotado.
-
Anotación semiautomática
SAM marca solo los objetos que tiene claros y las personas añaden los que faltan. Así el dataset gana variedad, y el modelo se vuelve a reentrenar.
-
Anotación totalmente automática
Cuando el modelo ya es fiable, anota imágenes completas de forma autónoma. Solo se aceptan las máscaras con alta confianza, permitiendo un escalado masivo de datos.
Segmentar con indicaciones (promptable segmentation)
Tipos de prompts y sus capacidades
Puntos
- Múltiples puntos: incluye o excluye áreas específicas para refinar la máscara deseada.
- Precisión: útil para objetos ambiguos o con bordes complejos.
Cajas (bounding box)
- Delimitación amplia: dibuja una caja alrededor del objeto; SAM la convierte en una máscara precisa.
- Rapidez: ideal para segmentación rápida de objetos bien definidos.
Máscara inicial
- Refinamiento: proporciona una máscara aproximada (rough) y el modelo perfecciona los bordes y rellena huecos.
- Perfeccionamiento: útil para mejorar segmentaciones previas o manuales.
Texto
- SAM 1 y SAM 2: mediante adaptadores (CLIP o Grounding DINO), se puede usar texto como "el coche rojo".
- SAM 3 (nativo): acepta directamente frases nominales cortas ("autobús amarillo") y segmenta todas las instancias. Para frases con razonamiento, como "el de la izquierda", hace falta un VLM.
Ejemplar (crop)
- SAM 3: a partir de un recorte de ejemplo, segmenta todas las instancias del mismo concepto en la imagen o vídeo.
- Generalización: ideal para tareas de conteo o seguimiento de objetos idénticos.
Segment everything
- Cobertura completa: genera una máscara para cada objeto detectable en la imagen sin prompts específicos.
- Análisis exhaustivo: útil para la inspección completa de escenas complejas.
Punto, caja o texto
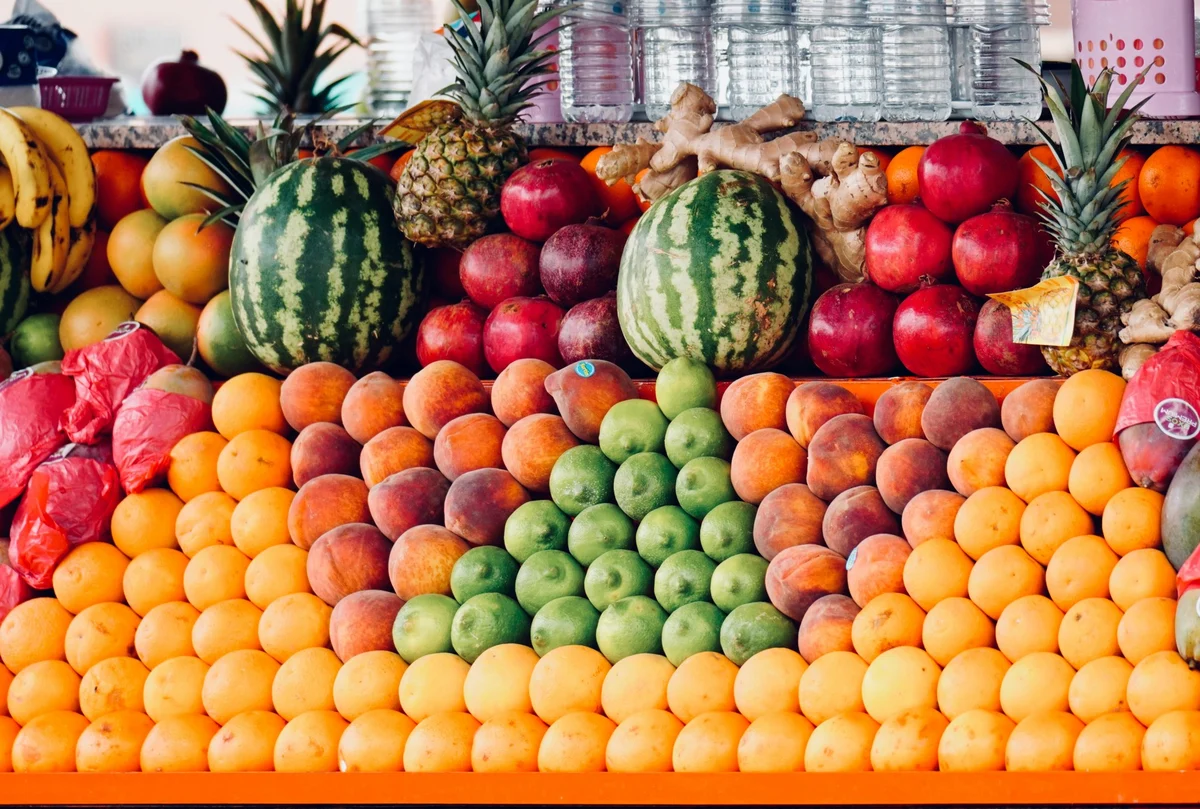
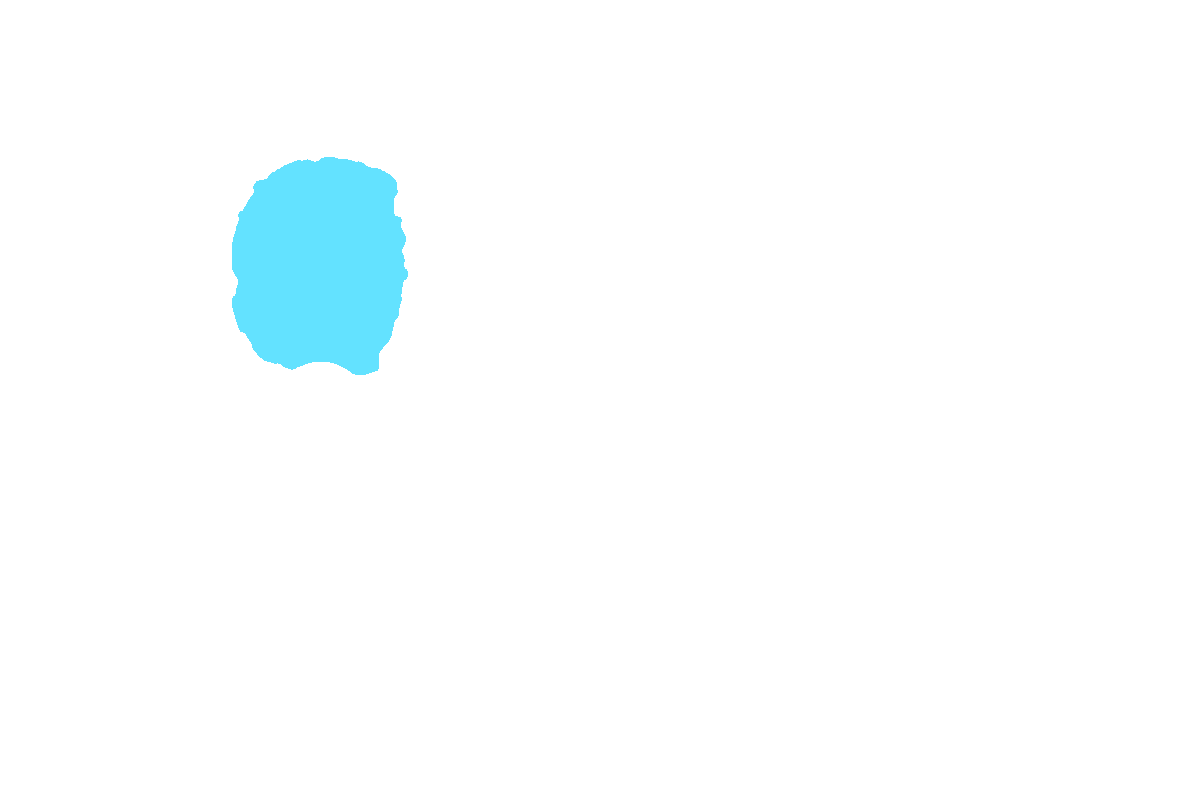
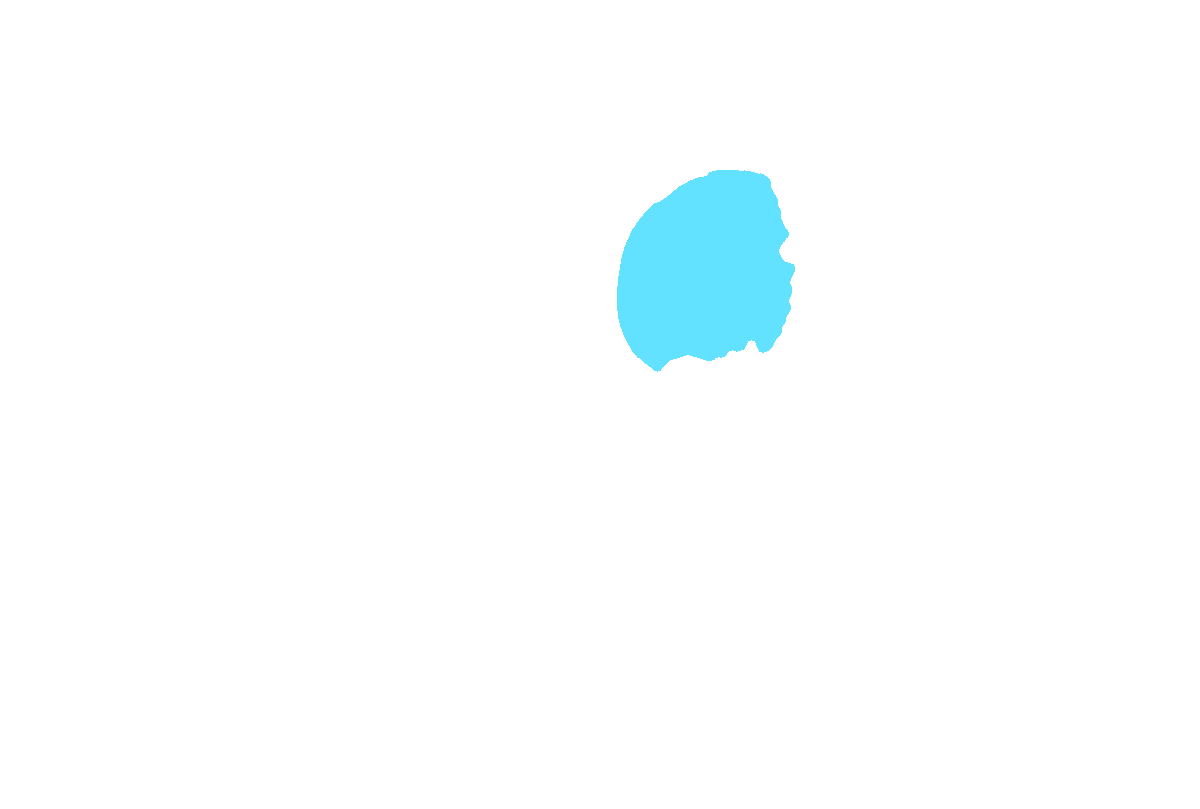
Pulsa cada indicación: un punto o una caja devuelven un objeto; el texto "sandía" devuelve todas las sandías.
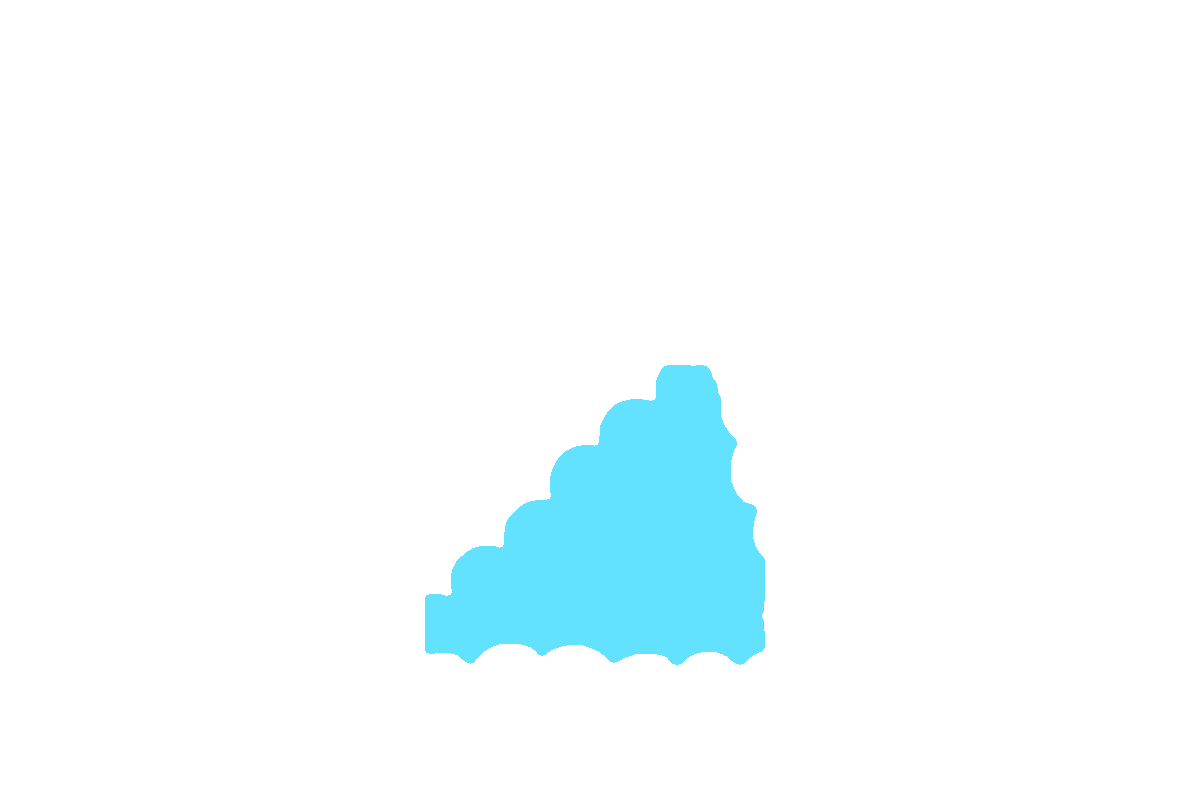
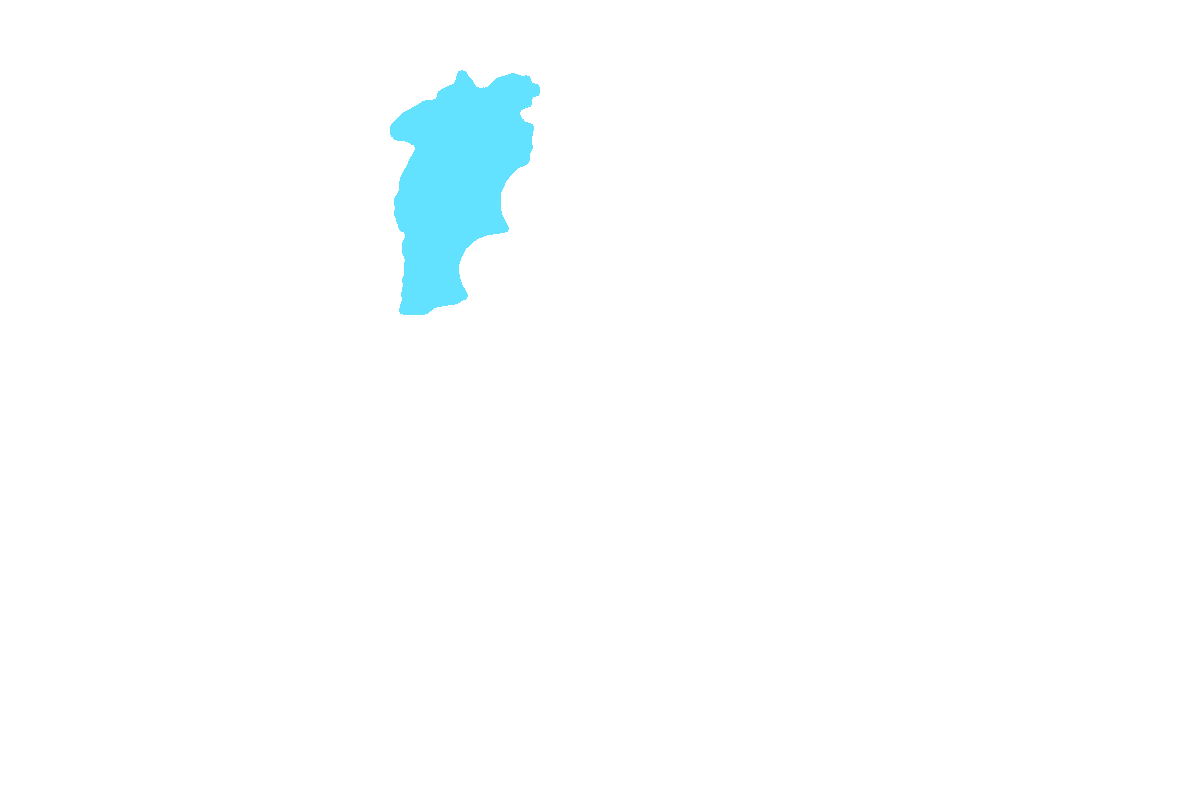
Qué le indicas al modelo
Máscaras devueltas 1
Esta página recoge el estado con un punto sobre la sandía izquierda. Lo que conviene retener es una diferencia de interfaz: un punto o una caja identifican dónde, y devuelven la instancia que hay ahí; un concepto en texto o un ejemplar identifican qué, y devuelven todas las coincidencias. SAM 1 y SAM 2 admiten de forma nativa lo primero, y para lo segundo necesitan un modelo externo que traduzca el texto; SAM 3 incorpora el texto y los ejemplares como prompts propios. Las máscaras de esta demostración se calcularon con GrabCut a partir de una caja, no con SAM: el cuaderno del tema las genera con el modelo real.
Qué es una máscara
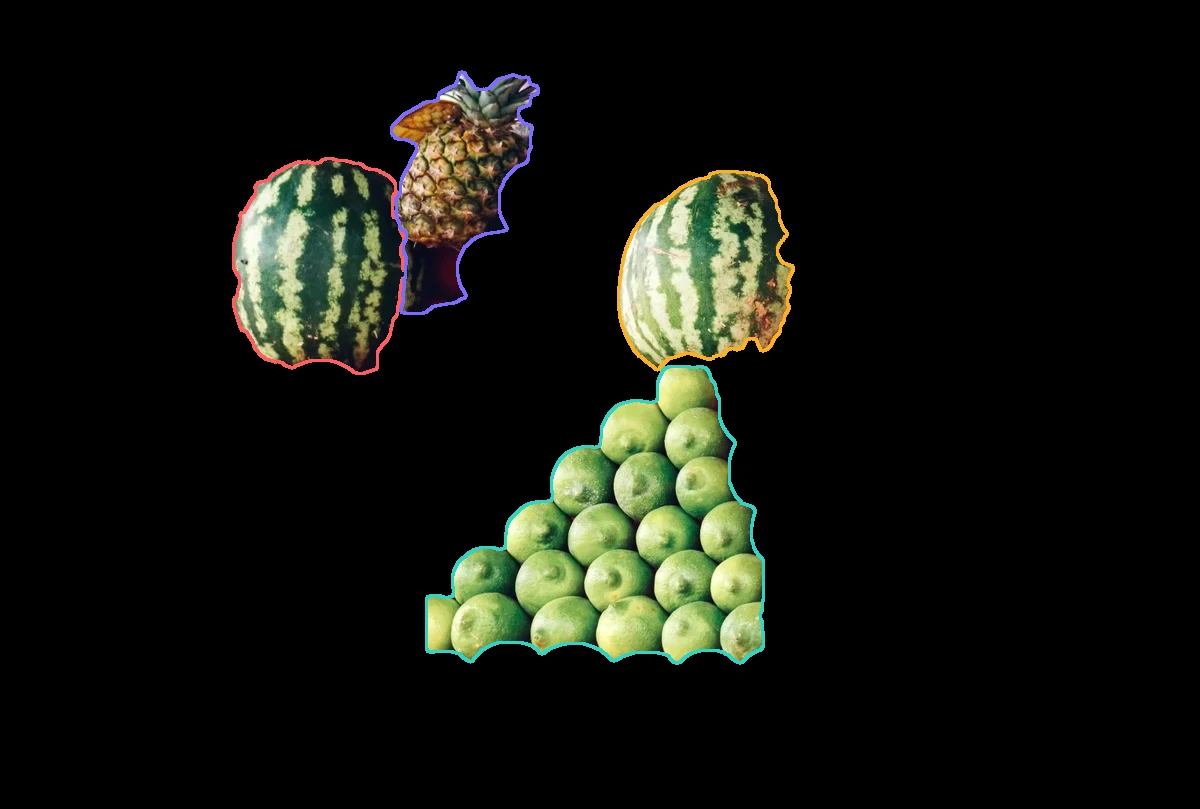
La imagen en negro se compone multiplicando la foto por la unión de las cuatro máscaras, que es lo mismo que hace cualquier herramienta de recorte automático. Las máscaras están precalculadas con GrabCut a partir de una caja, no con SAM: el cuaderno del tema las genera con el modelo real. Un detalle que se ve al deslizar: el contorno de las limas rodea el montón entero porque la indicación fue una caja sobre el montón, no sobre una lima suelta.
Empezar con un punto
El punto positivo señala una región que debe pertenecer a la máscara.
Respuesta C. Exacto: el punto le dice a SAM qué objeto quieres.
La primera indicación puede admitir varias interpretaciones: objeto completo, parte o subparte. Por eso algunas versiones devuelven varias máscaras candidatas con puntuaciones.
Corregir sin volver a entrenar
Los nuevos clics añaden información sobre qué incluir y qué excluir.
Respuesta B. Exacto: el punto negativo le dice qué tiene que quedar fuera.
En vídeo con SAM 2, una corrección puede actualizar la memoria y propagarse. La interacción debe evaluarse por calidad final y por número de clics o tiempo requerido.
Cuándo usar (y cuándo no) SAM
Úsalo si… (ideal para flexibilidad y zero-shot)
- Segmentación zero-shot crítica: necesitas segmentar objetos desconocidos, raros o que no existían en tu dataset de entrenamiento (por ejemplo, microscopía o imagen submarina).
- Vídeo y coherencia temporal: requieres rastrear objetos que se mueven, ocultan y reaparecen sin entrenar un tracker específico, gracias a la memoria de SAM 2 y 3.
- Interacción humana (human-in-the-loop): estás construyendo herramientas de anotación de datos o edición donde el usuario refina el resultado con clics o cajas.
- Búsqueda por conceptos (SAM 3): necesitas encontrar todas las instancias de un concepto abstracto ("tornillos oxidados") usando texto o ejemplos visuales, no solo puntos.
- Escasez de datos: no tienes miles de máscaras anotadas para entrenar un modelo supervisado tradicional.
Evítalo si… (mejor usar modelos supervisados clásicos)
- Restricciones de hardware extremas (edge): necesitas inferencia en milisegundos en dispositivos IoT o móviles antiguos. SAM 3 es el más exigente: su paper da unos 30 ms por imagen con más de cien objetos en una H200, una GPU de centro de datos. Mide memoria y latencia en tu equipo.
- Entorno cerrado y repetitivo: si tu problema es "detectar botellas en una cinta transportadora", con clases fijas y fondo controlado, un modelo ligero como RF-DETR-Seg será mucho más rápido y barato de desplegar.
- Razonamiento complejo: SAM 3 entiende frases nominales simples. Si necesitas lógica compleja, necesitas un VLM.
SAM no dice qué es
SAM marca el contorno, pero no sabe qué objeto es. El nombre lo tiene que poner otro modelo.
Respuesta A. Exacto: SAM da el contorno y otro modelo pone el nombre.
SAM resulta valioso con poca anotación, interacción humana o vídeo. Un modelo supervisado pequeño puede ser más rápido y barato para clases estables y fondos controlados. Siempre hay que evaluar bordes, objetos pequeños, oclusiones y consumo de memoria.
¿Qué versión de SAM necesitas?
Las tres segmentan, pero no aceptan las mismas indicaciones ni el mismo medio.
SAM 2 (o SAM 1)
Imagen y clics es su caso más sencillo. SAM 2 es más rápido y es el que usa el cuaderno; SAM 1 también sirve.
facebook/sam2.1-hiera-small
SAM 2
Recuerda el objeto de un fotograma a otro, aunque se tape un momento. Una corrección en un fotograma se propaga al resto.
facebook/sam2.1-hiera-small, o la large si el borde importa más que la velocidad
SAM 3, o SAM 2 con un detector delante
SAM 3 acepta texto y recortes de ejemplo de forma nativa y devuelve todas las instancias del concepto. La alternativa clásica es Grounding DINO produciendo cajas que alimentan a SAM 2.
Esa combinación es la que monta el cuaderno del tema.
SAM 3
SAM 3 detecta por concepto y sigue las instancias en el tiempo. La alternativa es que Grounding DINO dé las cajas en el primer fotograma y SAM 2 siga el objeto.
Cuenta con que es el más exigente en hardware de los tres.
Antes de usar SAM
Seis cosas que probar antes de montarlo.
- Bordes difíciles probadosPelo, transparencias, objetos muy pequeños. Ahí es donde se cae la máscara.
- Ambigüedad resueltaDecide si te quedas con la máscara de mayor puntuación o le enseñas las tres al usuario.
- Coste de interacción medidoCuántos clics de media hacen falta para una máscara aceptable.
- Encoder reutilizadoUna vez por imagen, no una por clic. Es la diferencia entre fluido y lento.
- Reconocimiento resuelto aparteSAM delimita pero no nombra. Decide quién pone la etiqueta.
- Alternativa ligera comparadaCon clases fijas y fondo controlado, un modelo supervisado pequeño puede salir mejor y más barato.
Cuaderno 5: SAM
Los ejercicios están en el cuaderno. El extra, si da tiempo, lo hacemos juntos; si no, queda para casa.
- Segmentar con un punto y afinar con varios
- Segmentar por texto: Grounding DINO y SAM 2
- Segmentar con instrucciones: Qwen3.5 y SAM 2
- Búsqueda semántica con SAM y CLIP
- Extra: el perímetro del lago de Central Park
En Colab: Archivo, Guardar una copia en Drive, y Entorno de ejecución, GPU T4.