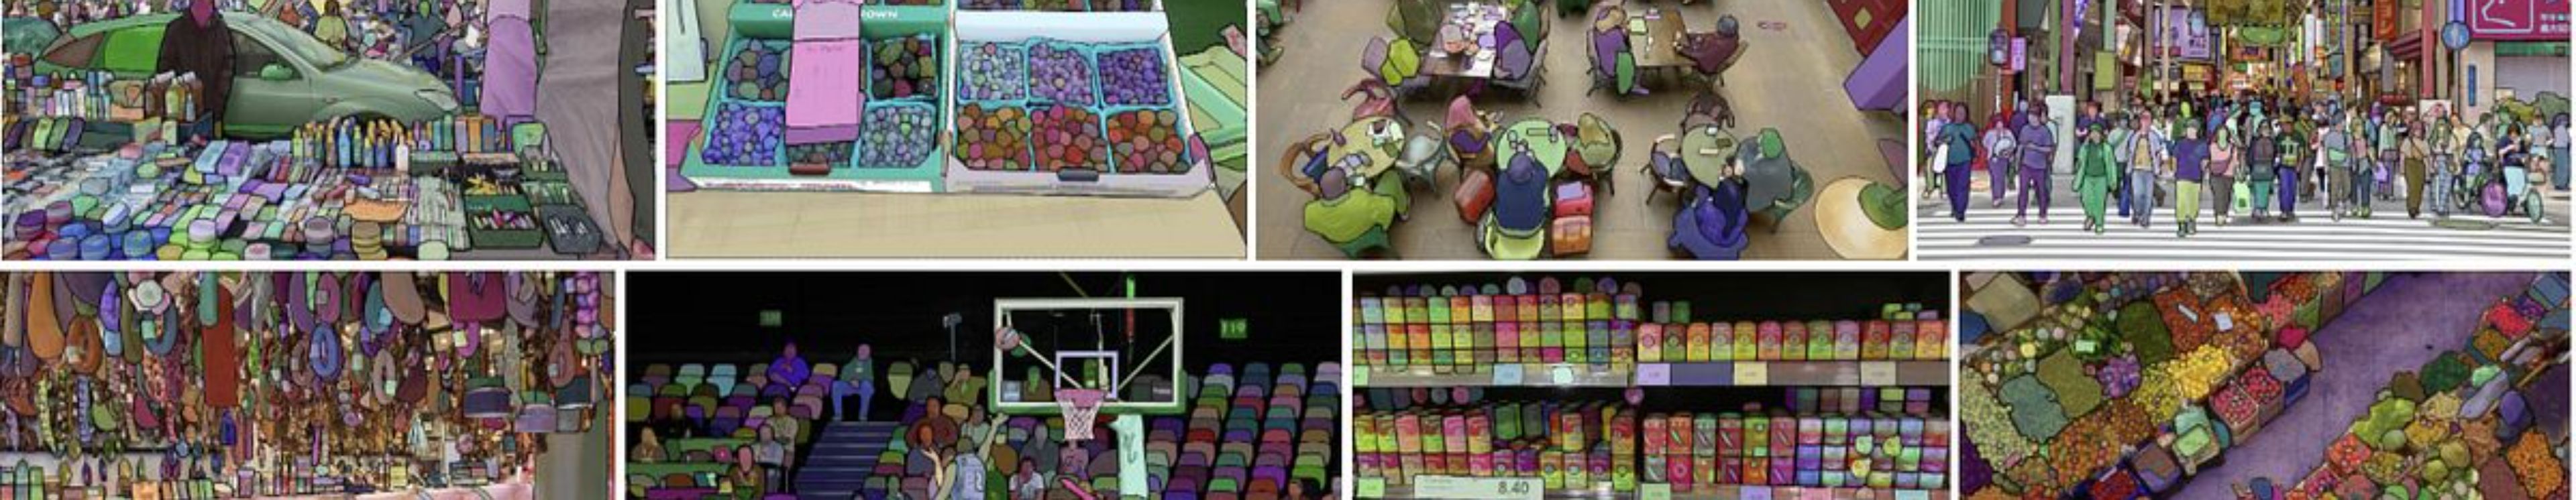
Segmentación universal en imagen y vídeo, con prompts.
SAM (Segment Anything Model) segmenta cualquier objeto de cualquier imagen a partir de indicaciones sencillas (puntos, cajas, máscaras), sin entrenar para clases concretas. Desde SAM 2 hace lo mismo en vídeo, manteniendo el objeto entre fotogramas.
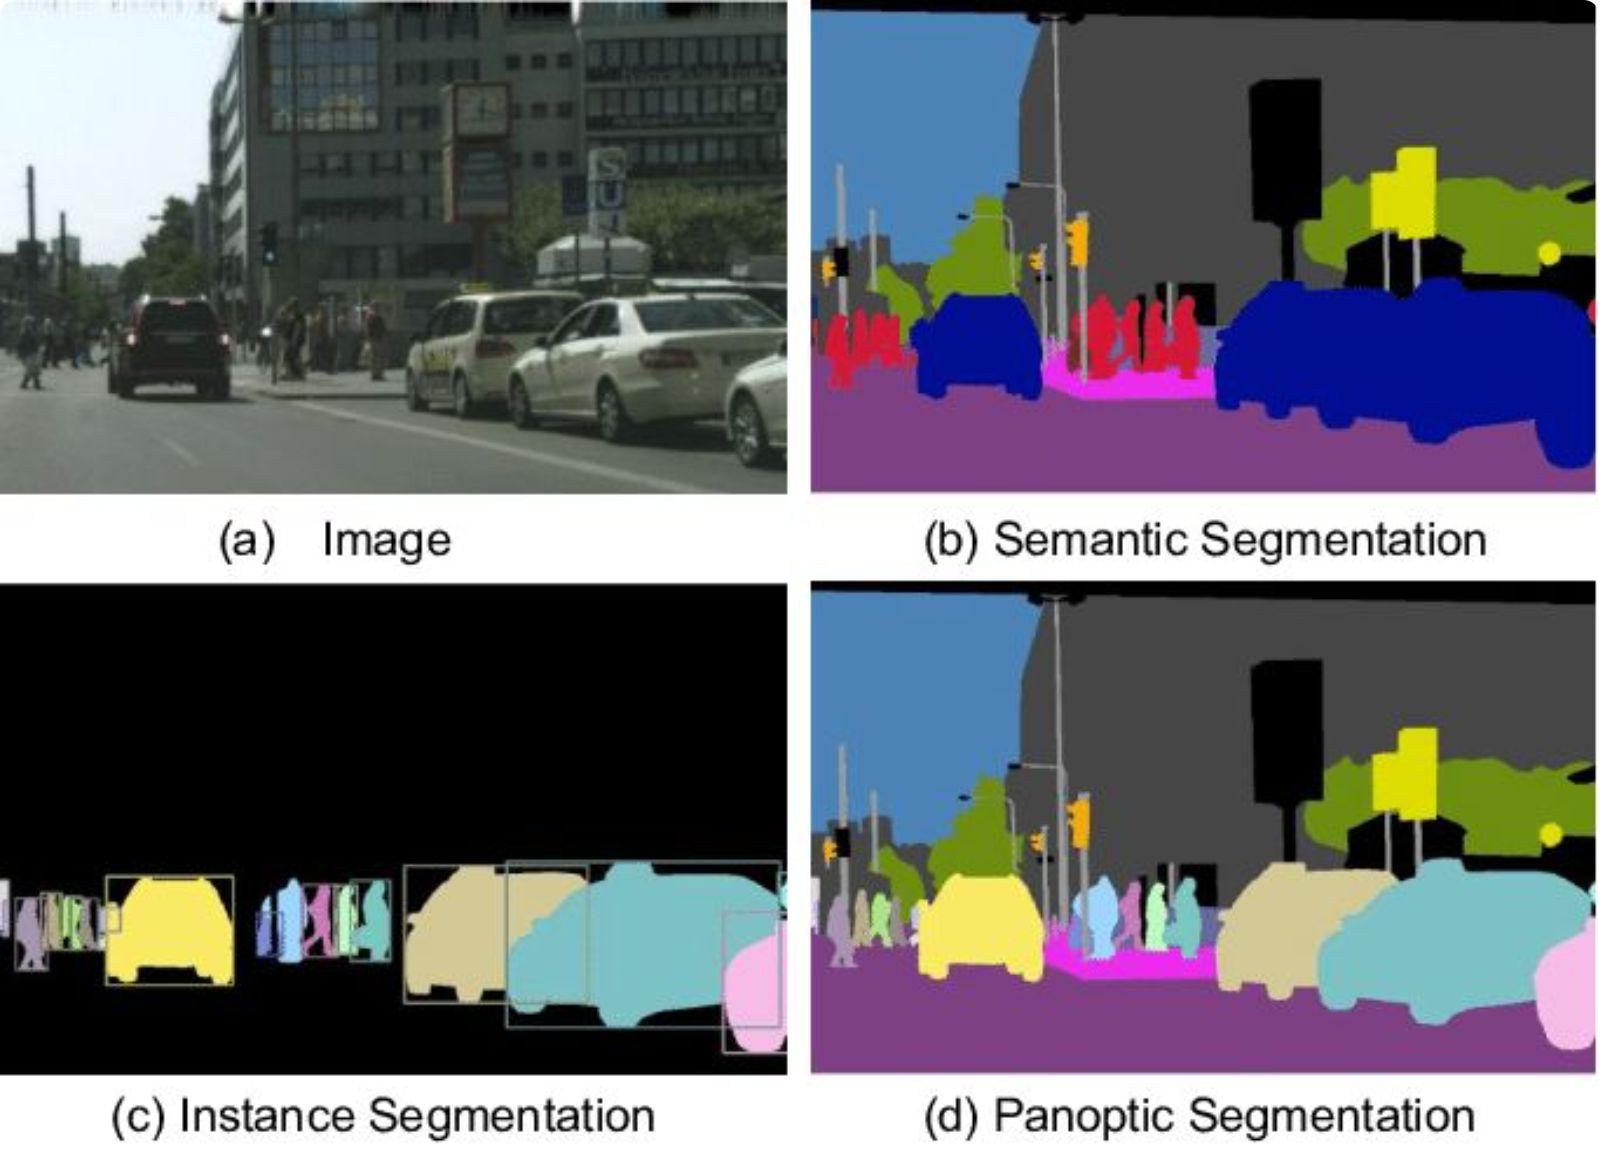
La segmentación de imágenes es una tarea básica en visión artificial que da más que una caja: asigna una etiqueta a cada píxel de una imagen, delimitando el contorno exacto de los objetos y el fondo.
Cada píxel se clasifica en una categoría (por ejemplo, "coche", "persona", "fondo"). No distingue entre instancias individuales del mismo tipo de objeto: todos los coches reciben la misma máscara y etiqueta.
Cada objeto individual detectado recibe una máscara única y su propia etiqueta. Permite distinguir entre objetos del mismo tipo, como "coche 1", "coche 2", "persona A", "persona B".
Combina la segmentación semántica y por instancias. Asigna una máscara única y una etiqueta a cada instancia de objeto cubriendo toda la imagen. Es la más completa pero también la más compleja.
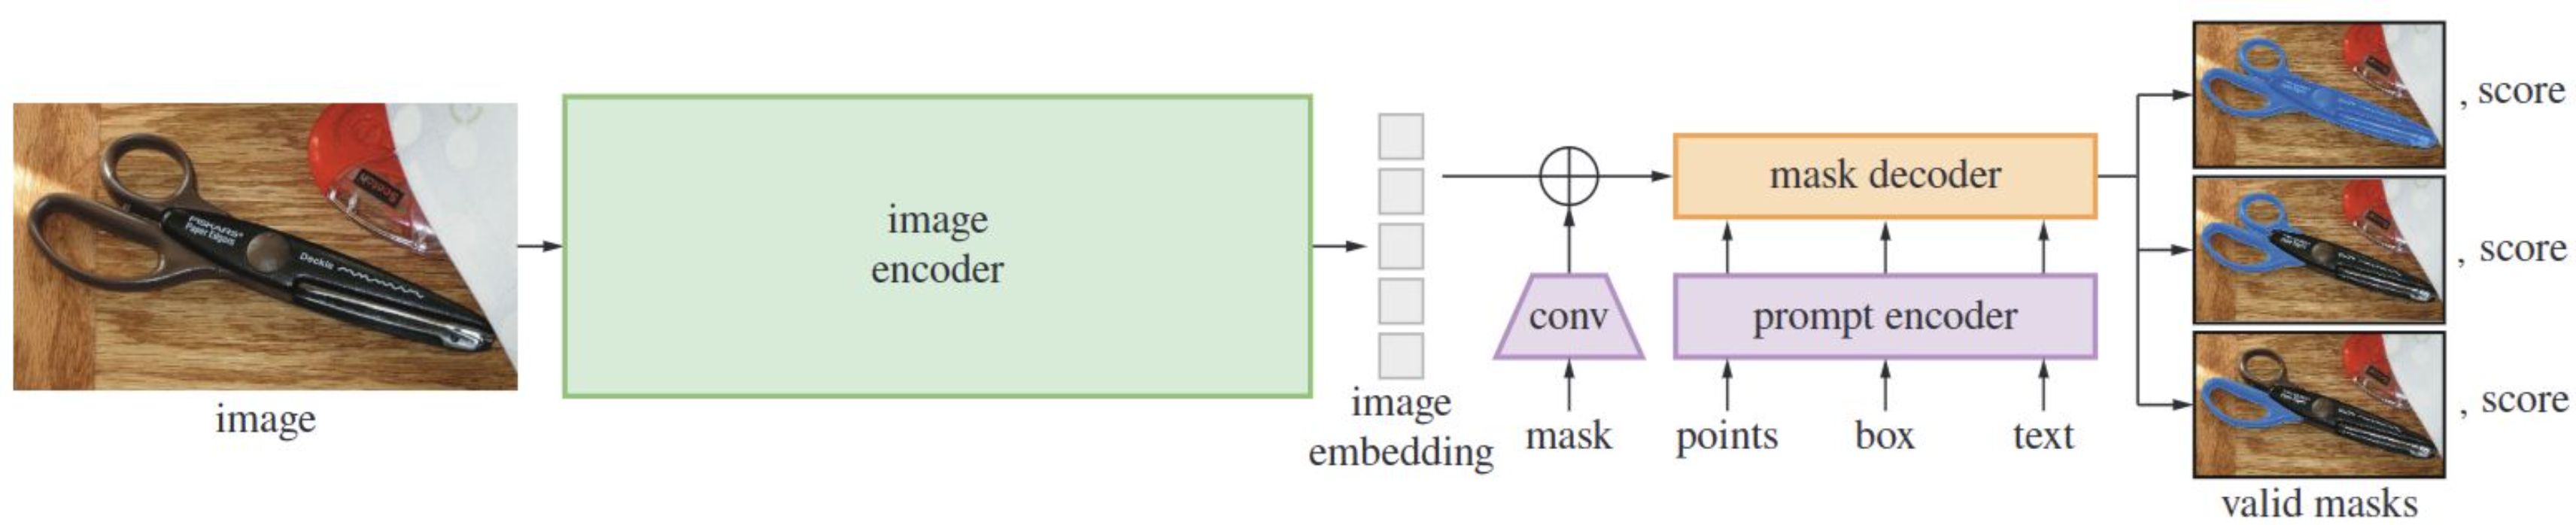
SAM tiene una parte pesada que mira la imagen una sola vez y una parte ligera que responde a cada clic. Por eso, tras el primer cálculo, cada indicación se resuelve al momento.
Un ViT grande convierte la imagen en un mapa de características. Se ejecuta una vez por imagen y el resultado se reutiliza para todos los clics.
Convierte los puntos, las cajas o una máscara previa en vectores. Es casi instantáneo.
Junta las dos cosas y devuelve tres máscaras candidatas (objeto, parte y subparte) con su puntuación. Tarda unos 50 ms, incluso en el navegador.
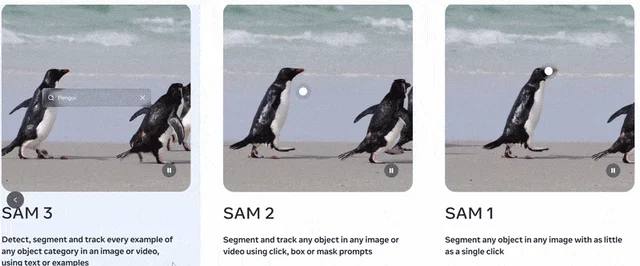
SAM 1 no entiende texto. Para segmentar "el coche rojo" hace falta otro modelo que dé la caja, como Grounding DINO. SAM 2 añade memoria para vídeo y SAM 3 acepta texto: lo veis en la pantalla siguiente.
SAM trabaja con imágenes, SAM 2 añade vídeo y SAM 3 acepta un concepto escrito o un ejemplo.
Segmentación universal en imagen con prompts de puntos y cajas. Dataset SA-1B: unos 11 millones de imágenes y 1.100 millones de máscaras.
Extiende a vídeo con memoria en streaming; más preciso y hasta 6 veces más rápido que SAM 1 en imagen. Dataset SA-V: unos 51.000 vídeos y 643.000 masklets.
Modelo unificado que detecta, segmenta y sigue todas las instancias de un concepto, dado por texto o por ejemplos, en imagen y vídeo.
SA-1B, el dataset con el que se entrenó SAM, salió de un "motor de datos": un ciclo en el que personas y modelo anotan juntos y el modelo va haciendo cada vez más parte del trabajo.
Personas anotan con una herramienta que ya usa una primera versión de SAM: hacen clics y corrigen la máscara. El modelo se reentrena con lo anotado.
SAM marca solo los objetos que tiene claros y las personas añaden los que faltan. Así el dataset gana variedad, y el modelo se vuelve a reentrenar.
Cuando el modelo ya es fiable, anota imágenes completas de forma autónoma. Solo se aceptan las máscaras con alta confianza, permitiendo un escalado masivo de datos.
El resultado: el 99,1 % de las máscaras de SA-1B las generó el propio SAM en la fase automática.
Le indicas a SAM qué quieres segmentar con un punto, una caja u otra indicación, y no hace falta reentrenarlo.
Meta AI publica un Segment Anything Playground, un espacio interactivo para probar estos prompts sobre medios propios.
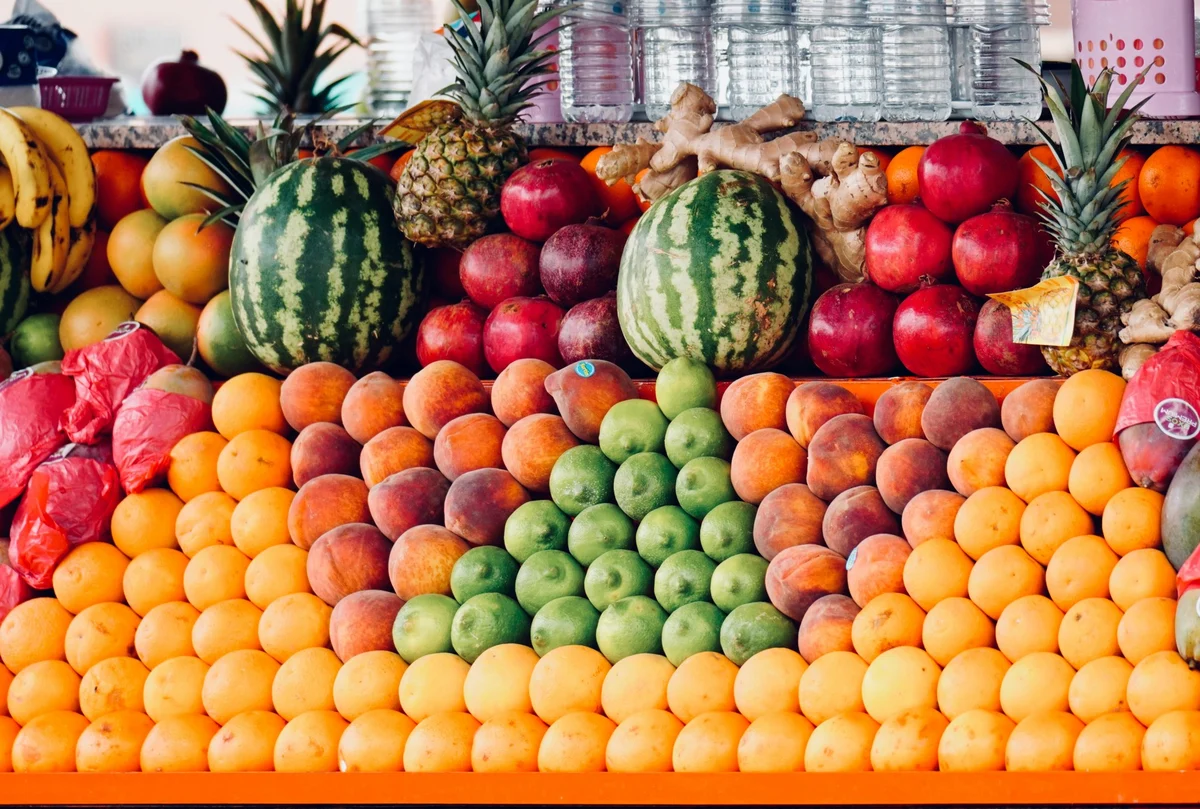
Pulsa cada indicación: un punto o una caja devuelven un objeto; el texto "sandía" devuelve todas las sandías.
Qué le indicas al modelo
Un punto señala una región concreta, así que el modelo devuelve esa sandía y no la otra.
Máscaras devueltas 1
Esta página recoge el estado con un punto sobre la sandía izquierda. Lo que conviene retener es una diferencia de interfaz: un punto o una caja identifican dónde, y devuelven la instancia que hay ahí; un concepto en texto o un ejemplar identifican qué, y devuelven todas las coincidencias. SAM 1 y SAM 2 admiten de forma nativa lo primero, y para lo segundo necesitan un modelo externo que traduzca el texto; SAM 3 incorpora el texto y los ejemplares como prompts propios. Las máscaras de esta demostración se calcularon con GrabCut a partir de una caja, no con SAM: el cuaderno del tema las genera con el modelo real.
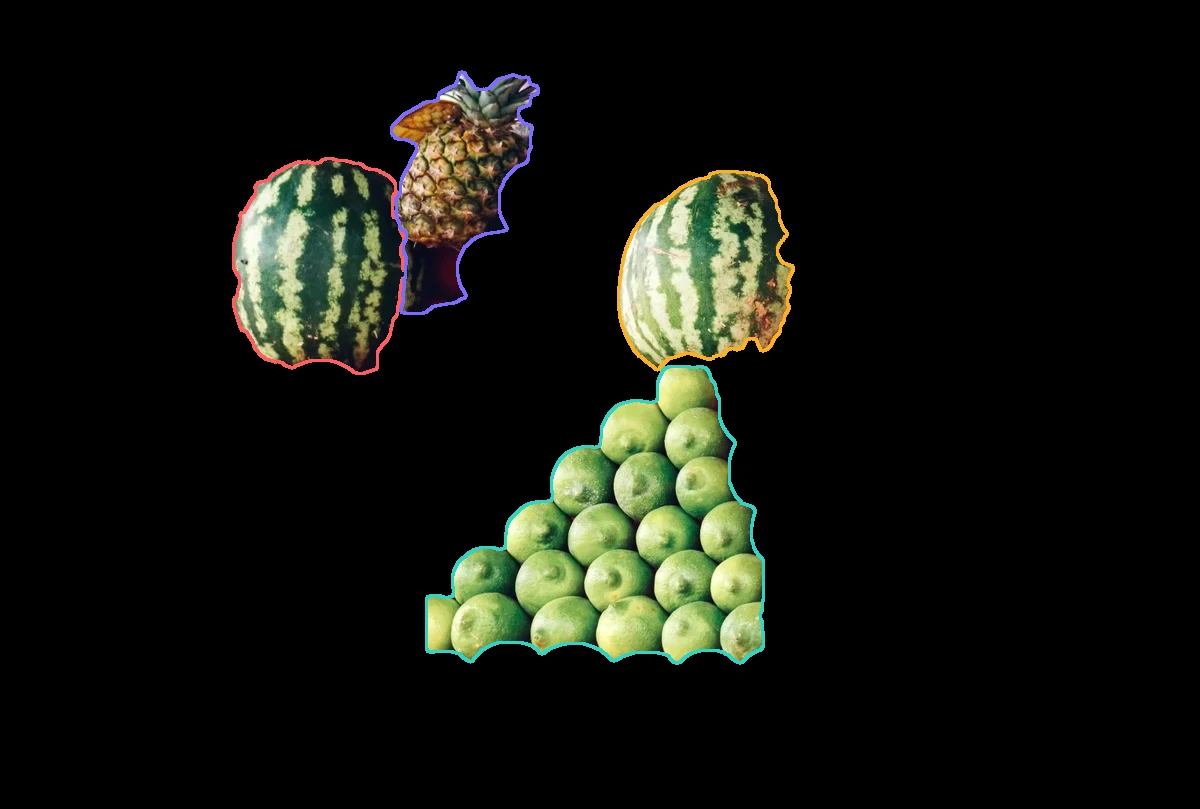
Desliza para quitar el fondo. Lo que queda es la salida de la segmentación: una lista de píxeles por instancia, cada una con su contorno, no un recorte rectangular.
Una máscara pesa poco. Con ella puedes medir el área en píxeles o recortar el objeto con su forma exacta, cosas que una caja no permite.
La imagen en negro se compone multiplicando la foto por la unión de las cuatro máscaras, que es lo mismo que hace cualquier herramienta de recorte automático. Las máscaras están precalculadas con GrabCut a partir de una caja, no con SAM: el cuaderno del tema las genera con el modelo real. Un detalle que se ve al deslizar: el contorno de las limas rodea el montón entero porque la indicación fue una caja sobre el montón, no sobre una lima suelta.
El punto positivo señala una región que debe pertenecer a la máscara.
Respuesta C. Exacto: el punto le dice a SAM qué objeto quieres.
La primera indicación puede admitir varias interpretaciones: objeto completo, parte o subparte. Por eso algunas versiones devuelven varias máscaras candidatas con puntuaciones.
Los nuevos clics añaden información sobre qué incluir y qué excluir.
Respuesta B. Exacto: el punto negativo le dice qué tiene que quedar fuera.
En vídeo con SAM 2, una corrección puede actualizar la memoria y propagarse. La interacción debe evaluarse por calidad final y por número de clics o tiempo requerido.
SAM marca el contorno, pero no sabe qué objeto es. El nombre lo tiene que poner otro modelo.
Respuesta A. Exacto: SAM da el contorno y otro modelo pone el nombre.
SAM resulta valioso con poca anotación, interacción humana o vídeo. Un modelo supervisado pequeño puede ser más rápido y barato para clases estables y fondos controlados. Siempre hay que evaluar bordes, objetos pequeños, oclusiones y consumo de memoria.
Las tres segmentan, pero no aceptan las mismas indicaciones ni el mismo medio.
Imagen y clics es su caso más sencillo. SAM 2 es más rápido y es el que usa el cuaderno; SAM 1 también sirve.
facebook/sam2.1-hiera-small
Recuerda el objeto de un fotograma a otro, aunque se tape un momento. Una corrección en un fotograma se propaga al resto.
facebook/sam2.1-hiera-small, o la large si el borde importa más que la velocidad
SAM 3 acepta texto y recortes de ejemplo de forma nativa y devuelve todas las instancias del concepto. La alternativa clásica es Grounding DINO produciendo cajas que alimentan a SAM 2.
Esa combinación es la que monta el cuaderno del tema.
SAM 3 detecta por concepto y sigue las instancias en el tiempo. La alternativa es que Grounding DINO dé las cajas en el primer fotograma y SAM 2 siga el objeto.
Cuenta con que es el más exigente en hardware de los tres.
Seis cosas que probar antes de montarlo.
Los ejercicios están en el cuaderno. El extra, si da tiempo, lo hacemos juntos; si no, queda para casa.
En Colab: Archivo, Guardar una copia en Drive, y Entorno de ejecución, GPU T4.