Tema 06: Otras tareas de visión
Otras tareas fundacionales de visión artificial
Estimación de pose
Identificar y localizar puntos clave del cuerpo humano o de objetos en imágenes y vídeos.
OCR moderno
Extraer texto de imágenes y documentos, transformándolo en datos editables y buscables.
Super-resolución
Mejorar la calidad y resolución de imágenes o vídeos, a menudo a partir de datos de baja resolución.
Background removal
Segmentar y eliminar automáticamente el fondo de una imagen, aislando el objeto principal.
Estimación de profundidad
Calcular la distancia de los objetos en una escena respecto a la cámara, creando mapas de profundidad.
Image matching
Encontrar correspondencias o similitudes entre dos o más imágenes para tareas como la localización o el reconocimiento.
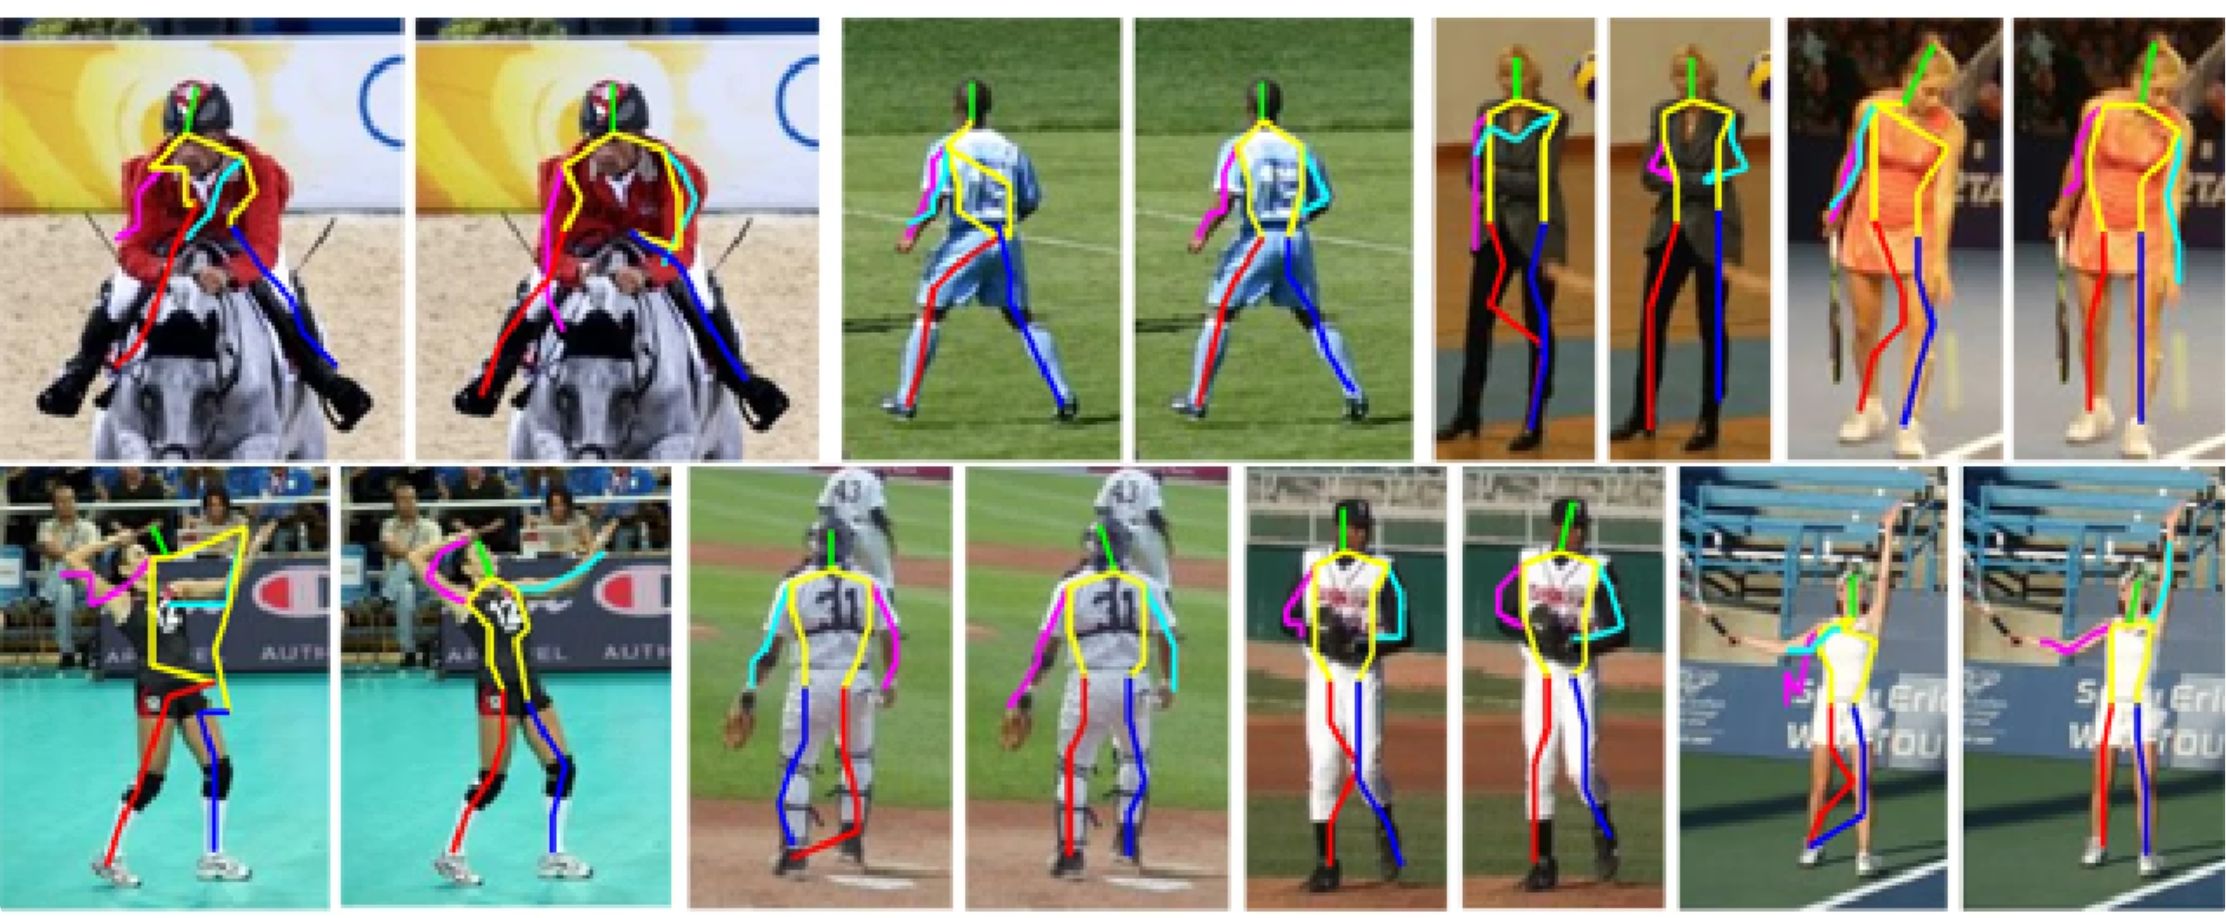
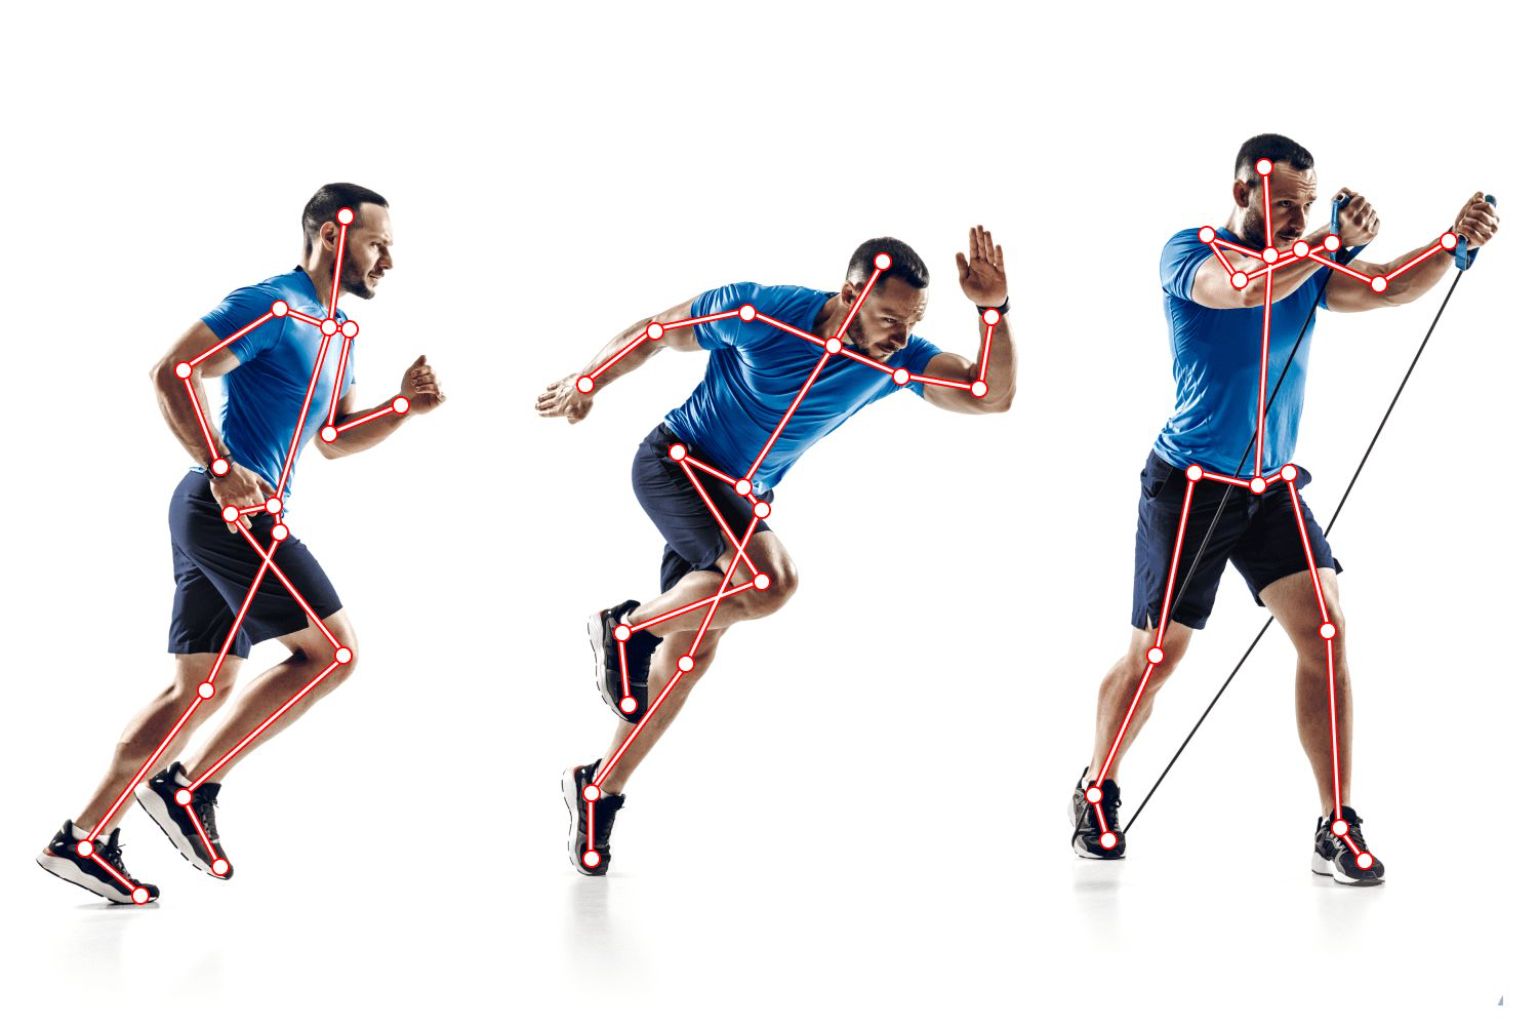
Estimación de pose humana: de píxeles a esqueletos
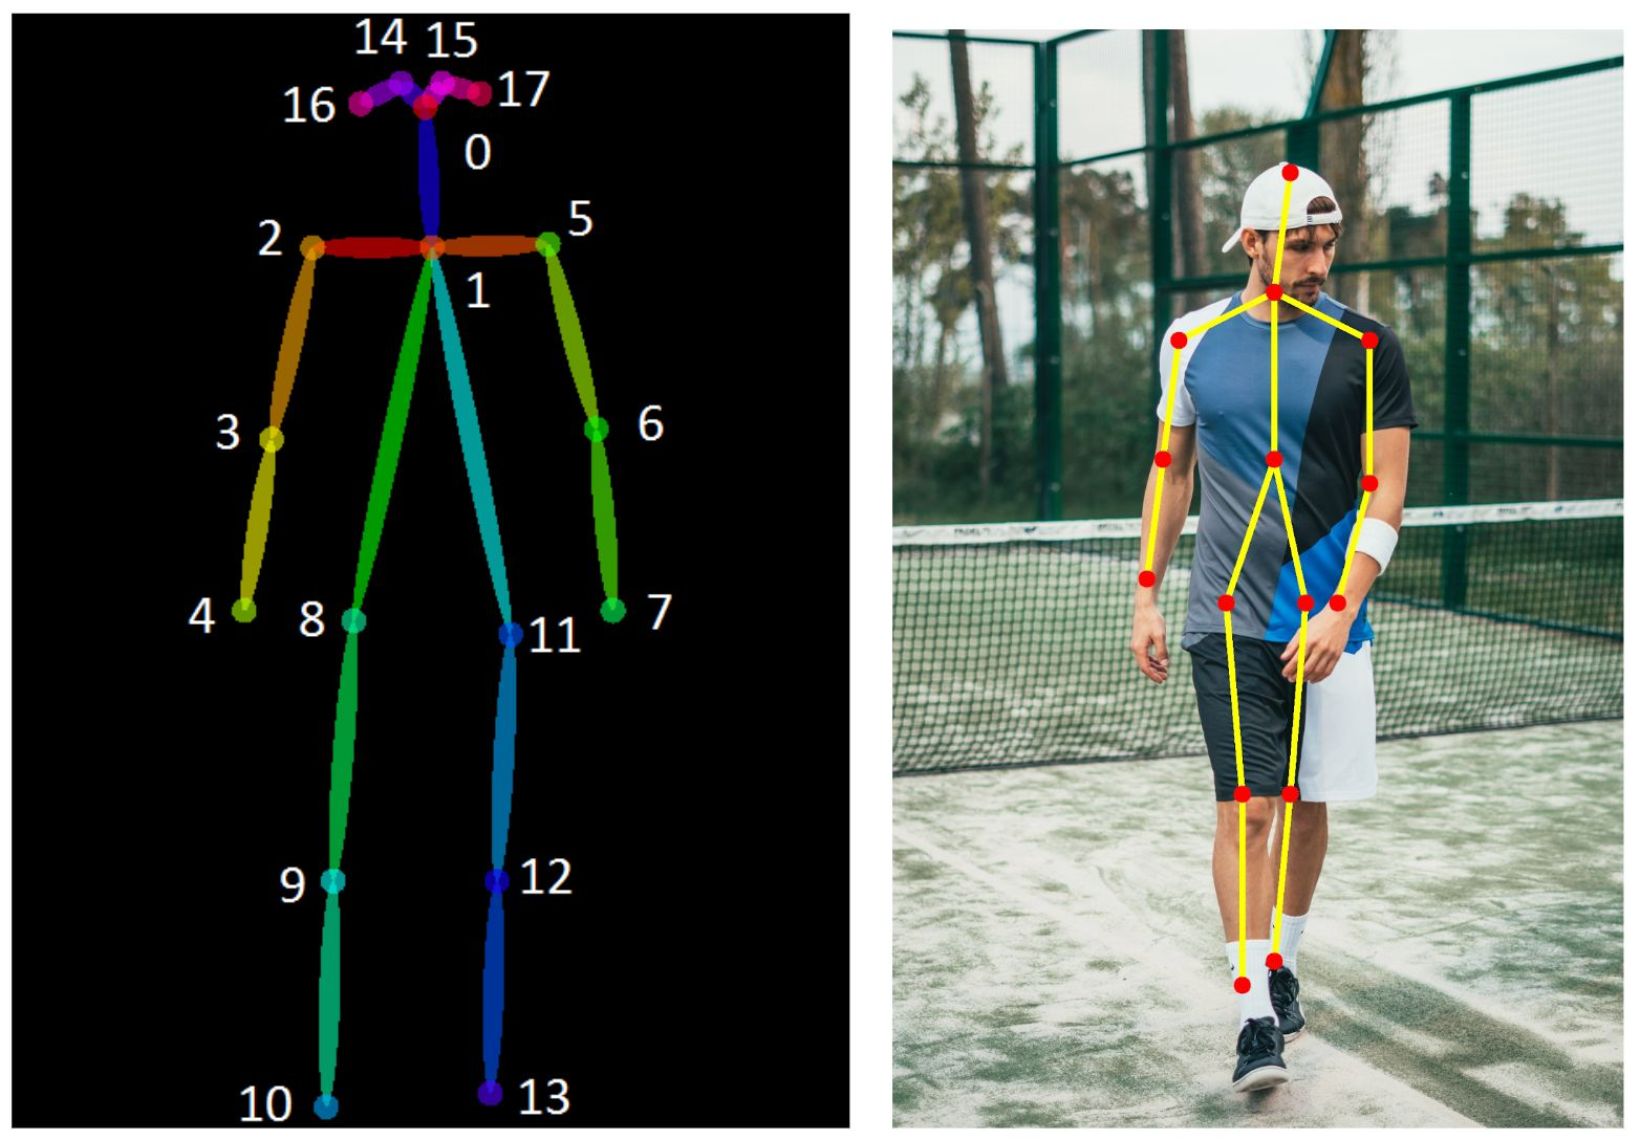
Enfoques de modelado: top-down vs. bottom-up
Top-down (alta precisión)
Proceso: primero detecta personas (cajas), luego estima la pose dentro de cada una.
Ejemplos: HRNet, ViTPose.
- Pros: máxima precisión, robustez a distintas escalas.
- Contras: lento en grandes aglomeraciones, con coste lineal en el número de personas.
Bottom-up (alta velocidad)
Proceso: detecta todos los puntos clave de la imagen a la vez, luego los agrupa en personas.
Ejemplo: OpenPose.
- Pros: velocidad constante, independiente del número de personas.
- Contras: menos preciso, el agrupamiento de puntos es complejo.
Single-stage (el equilibrio moderno)
Proceso: redes como YOLO-Pose predicen cajas y puntos simultáneamente en una sola pasada (end-to-end).
- Ventaja: velocidad en tiempo real con precisión competitiva, ideal para dispositivos edge.
Modelos destacados y evaluación
-
MediaPipe (Google)
Funciona eficientemente en CPU. Ideal para aplicaciones de fitness, filtros AR o escenarios de una sola persona. El problema es que solo da los keypoints de una sola persona. También sirve para manos y cara.
-
YOLOv8-Pose (ultralytics)
El estándar industrial actual. Ofrece un equilibrio óptimo entre velocidad y precisión. Excelente para detección multi-persona y es fácil de entrenar y adaptar.
-
OpenPose (CMU)
El pionero académico que estableció las bases. Aunque influyente, hoy en día es computacionalmente pesado en comparación con opciones más modernas.
-
HRNet
Prioridad en precisión extrema. Cuando la exactitud es crítica (análisis médico, biomecánico) y la velocidad de inferencia es secundaria.
¿Cómo medimos la calidad? La métrica OKS
El mismo error no penaliza igual
La tolerancia depende de la articulación y del tamaño de la persona. Mueve las dos cosas y mira cuándo la pose deja de contar como acierto.
El muñeco mide siempre lo mismo y representa a la persona entera: si la persona encoge, el mismo error en píxeles se ve mayor sobre ella. Las tolerancias son las constantes de COCO.
Cuenta como acierto
OKS del esqueleto0,92
Umbral de acierto0,50
- Ojo rígido 0,80
- Muñeca flexible 0,96
- Cadera flexible 0,99
Esta página recoge el estado con 5 px de error en una persona de 150 px. OKS aplica a cada punto exp(−d² / (2 s² k²)), donde d es el error en píxeles, s la escala de la persona y k = 2σ una constante propia de cada articulación medida sobre anotaciones humanas. Los ojos tienen σ = 0,025 y la cadera σ = 0,107, así que la cadera tolera más de cuatro veces el error antes de penalizar lo mismo. La escala entra dividiendo, de modo que la tolerancia en píxeles es proporcional al tamaño de la persona: en una persona de 60 px el ojo pierde medio punto a partir de 4 px, y en una de 400 px aguanta hasta 24 px. El OKS del esqueleto es la media de los puntos visibles, y sustituye al IoU cuando se calcula AP para pose: COCO promedia AP con umbrales de 0,50 a 0,95, así que el 0,50 de esta pantalla es el criterio más indulgente de los diez.
Cinco píxeles no son cinco píxeles
La tolerancia de cada articulación sale de cómo de acuerdo se ponen los anotadores humanos.
Respuesta B. Exacto: normaliza por tamaño y usa una tolerancia específica por keypoint.
Las constantes por articulación se estimaron midiendo la dispersión entre anotadores. Donde las personas coinciden mucho, como los ojos, el modelo tiene menos margen.
Impacto real y desafíos técnicos
Sport y fitness
- Entrenador IA: conteo preciso de repeticiones (sentadillas, flexiones…).
- Análisis de técnica: medición de ángulos corporales para prevenir lesiones.
- Aplicaciones en plataformas como Nike Training o Peloton.
Seguridad industrial y ergonomía
- Detección de posturas peligrosas: identificar movimientos de riesgo al levantar peso.
- «Hombre caído»: alertas de seguridad en tiempo real en entornos peligrosos.
- Optimización: mejora de la eficiencia en líneas de montaje.
Salud y rehabilitación
- Fisioterapia remota: validación de ejercicios en casa sin supervisión presencial.
- Análisis de marcha: detección temprana de patologías neurológicas o musculoesqueléticas.
El gran reto: oclusiones y reconstrucción 3D
OCR moderno: de leer caracteres a entender documentos
El pasado: enfoque clásico (Tesseract)
Metodología: basado en reglas heurísticas y detección de contornos para identificar caracteres individuales.
Limitaciones comunes:
- Falla con texto curvo, distorsionado o en perspectivas inusuales.
- Poca robustez ante fuentes manuscritas complejas o variaciones tipográficas.
- Sensible al ruido de fondo, baja resolución o iluminación deficiente.
- Requiere preprocesamiento intensivo (normalización, binarización).
El presente: transformers para OCR (TrOCR y VLM)
Arquitectura end-to-end: utiliza Vision Transformers (ViT) para codificar la imagen de forma global y un modelo de lenguaje (como BERT o GPT) decodifica la secuencia de texto resultante.
Ventaja fundamental: no «lee» letra a letra, sino que «entiende» la secuencia visual completa del texto en contexto, de forma similar a como los humanos leen.
Estado del arte (SOTA):
- TrOCR (Microsoft): un referente específico para tareas de OCR.
- Qwen 2.5/3-VL: un VLM avanzado que integra OCR con capacidades de razonamiento multimodal.
Herramientas prácticas de OCR
EasyOCR: el comodín versátil
Una opción todo terreno para cualquier proyecto. Es ligera, soporta más de 80 idiomas y funciona eficientemente en CPU. Ideal para prototipos rápidos y escenarios donde no se dispone de GPU.
TrOCR (Hugging Face): precisión avanzada
Ofrece la máxima precisión, especialmente diseñado para textos manuscritos, históricos o muy específicos. Requiere una GPU para un rendimiento óptimo debido a su arquitectura basada en Transformers.
VLM (Qwen, GPT-4V): documentos estructurados
Perfectos para casos de uso complejos como el procesamiento de facturas o tablas. Permiten extraer información estructurada, por ejemplo JSON, en lugar de solo texto plano, integrando visión y lenguaje para un razonamiento avanzado.
Lo que devuelve cada generación de OCR
La misma foto de una placa, leída de tres formas. Cambia la herramienta y mira qué recibe tu programa.
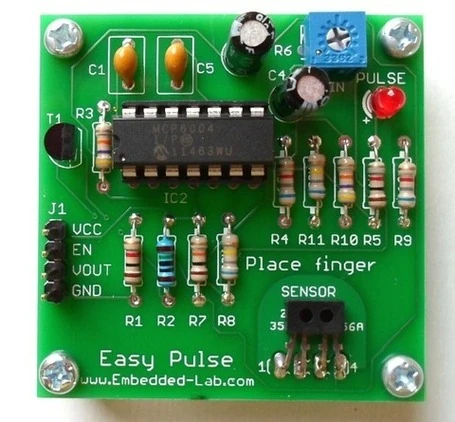
Qué herramienta usas
C1  C5  R6  C4  PULSE
T1  R3  MCP6004
IC2  R4  R11  R10  R5  R9
J1  VCC  EN  VOUT  GND
R1  R2  R7  R8
Place finger  SENSOR
Easy Pulse
www.Embedded-Lab.com
texto posición tamaño
PULSE (357, 70) 44 x 13
MCP6004 (163, 122) 47 x 16
IC2 (161, 189) 36 x 18
VCC ( 71, 221) 36 x 19
GND ( 71, 283) 38 x 19
R1 (126, 317) 25 x 16
Place finger (250, 252) 120 x 26
SENSOR (282, 281) 55 x 19
Easy Pulse (103, 344) 135 x 34
www.Embedded-Lab.com ( 82, 378) 175 x 23{
"placa": "Easy Pulse",
"fabricante": "www.Embedded-Lab.com",
"integrado": "MCP6004",
"conector": {
"referencia": "J1",
"pines": ["VCC", "EN", "VOUT", "GND"]
},
"sensor": {
"etiqueta": "SENSOR",
"instruccion": "Place finger"
},
"resistencias": ["R1", "R2", "R4", "R5", "R7", "R8", "R9", "R10", "R11"]
}Las cajas de esta pantalla están medidas a mano sobre la foto para ilustrar el formato de salida, no las ha producido un OCR. Tres cosas que se ven en esta imagen y que aparecen en cualquier planta: el texto de la serigrafía es de bajo contraste sobre verde y el brillo del cobre lo rompe, hay texto a distintas escalas en la misma foto, y varias referencias quedan parcialmente tapadas por los componentes. Por eso la resolución de captura manda más que el modelo: con menos de veinte píxeles de altura por carácter, ningún OCR actual lee de forma fiable. Sobre latencia y coste, Tesseract corre en CPU en decenas de milisegundos, un modelo de detección más reconocimiento ronda las décimas de segundo en GPU, y un VLM se va a varios segundos por imagen, así que en línea suele combinarse: detección rápida siempre y VLM solo sobre las piezas dudosas.
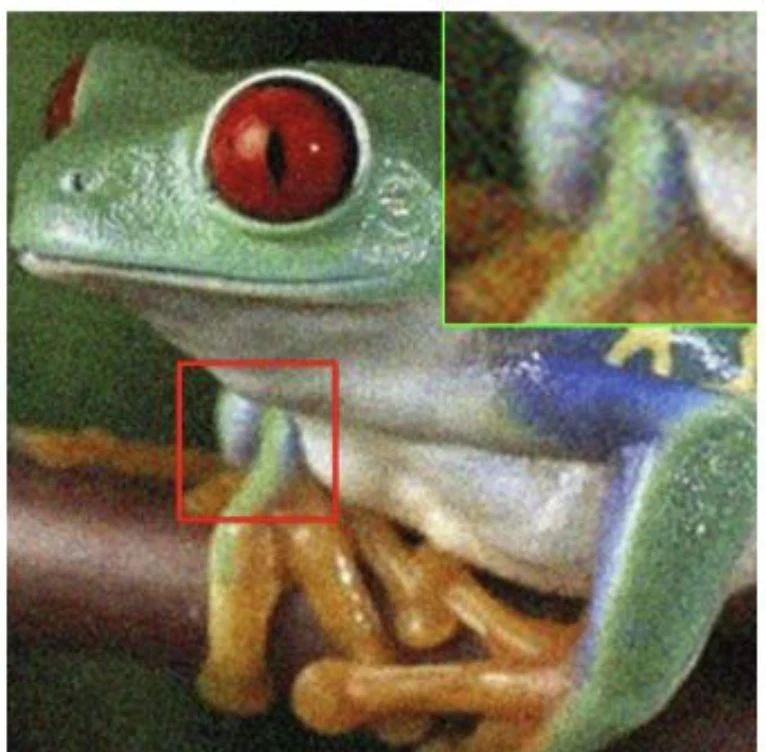
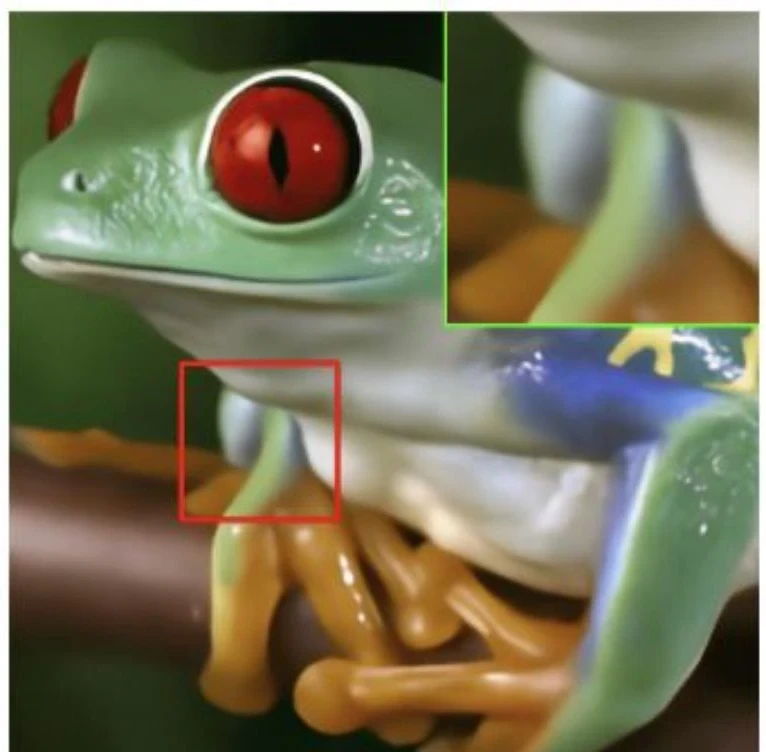
Super-resolución: restaurando el detalle perdido
Aplicaciones reales y limitaciones
Restauración de archivos
- Digitalización de fotos antiguas o documentos históricos dañados.
- Mejora de contenido multimedia antiguo (remasterización).
Medicina e imagen satelital
- Mejorar la legibilidad de escáneres médicos.
- Zoom en imágenes aéreas o satelitales.
E-commerce y marketing
- Mejorar fotos de productos de baja calidad enviadas por usuarios o proveedores.
- Lograr una apariencia profesional en la web para el catálogo de productos.
Detalle generado no es evidencia
Lo que aparece al ampliar puede venir del modelo, no del sensor.
Respuesta B. Exacto: la mejora visual no convierte el detalle generado en evidencia.
La superresolución sintetiza textura plausible a partir de patrones aprendidos. En un contexto diagnóstico, cualquier estructura nueva debe comprobarse sobre la imagen original.
Eliminación de fondo profesional
El problema: bordes difusos
Segmentar objetos sólidos es fácil. Pero elementos como el pelo, el pelaje o el vidrio transparente son extremadamente difíciles de separar debido a sus bordes difusos y semitransparentes.
La solución: RMBG-1.4 (BRIA AI)
Un modelo de vanguardia diseñado para el alpha matting. Genera un canal alfa de transparencia gradual en los bordes, no una máscara binaria. Esto permite recortes profesionales que se integran perfectamente en cualquier fondo, sin el efecto «pegatina».
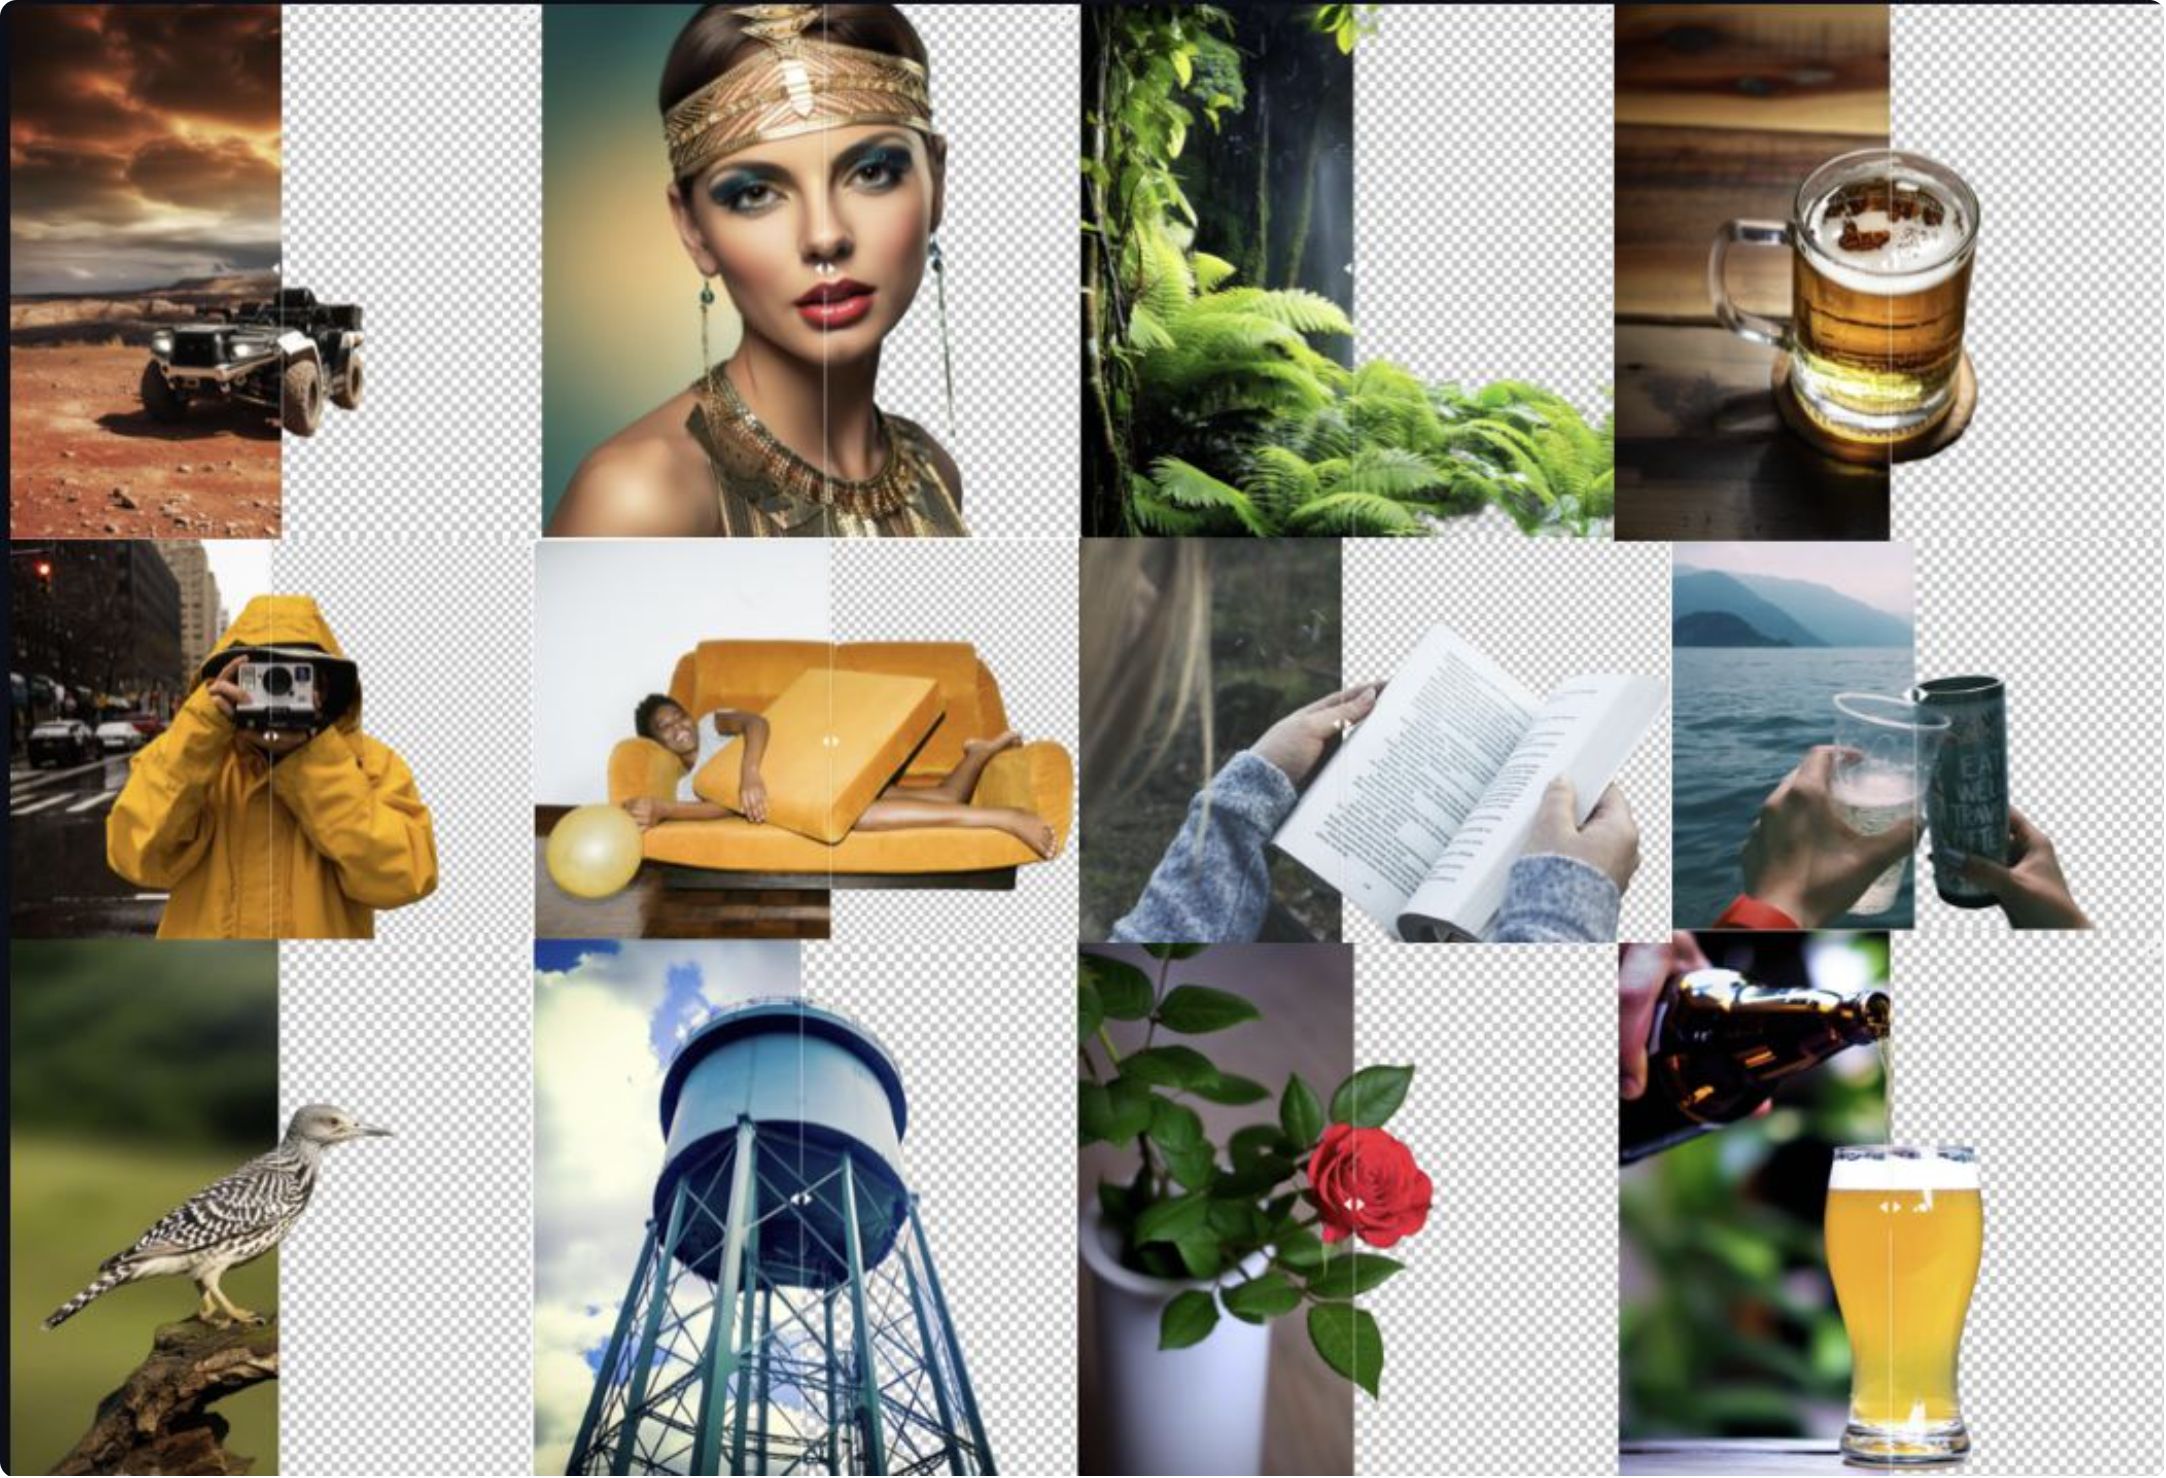
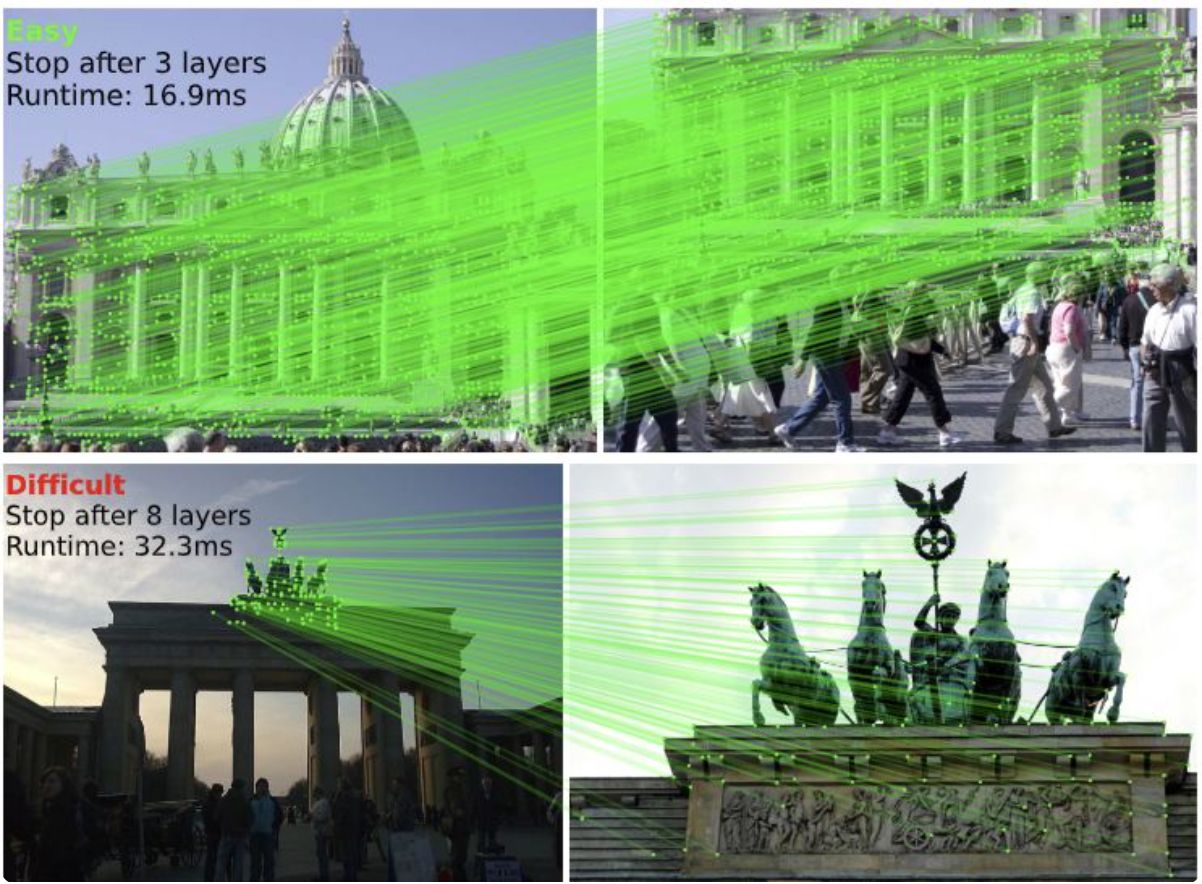
Image matching: encontrando parejas visuales
La nueva era: deep learning
Detector (SuperPoint, DISK)
Una red neuronal avanzada que identifica los puntos clave y más distintivos (esquinas, texturas complejas) en una imagen, superando con creces la precisión de los algoritmos matemáticos clásicos.
Matcher (LightGlue)
Un modelo basado en Transformer que evalúa los puntos detectados en ambas imágenes y determina cuáles corresponden entre sí, filtrando eficazmente los errores geométricos y emparejamientos incorrectos.
La mitad de las parejas sobran
Un matcher devuelve más parejas de las que valen. El filtro que las separa no mira el aspecto, mira la geometría: mueve el umbral y comprueba cuáles encajan con la escena.
Esquema con una homografía real: la misma fachada vista desde otro sitio. Las parejas y su error se calculan en el navegador.
Estimación sólida
Parejas aceptadas9
Descartadas6
Esta página recoge el estado con 2 px de umbral. El procedimiento real es RANSAC: se eligen cuatro parejas al azar, se calcula la homografía que implican, se cuenta cuántas de las demás quedan por debajo del umbral de reproyección, y se repite unos cientos de veces quedándose con la hipótesis que más apoyo reúne. Esta pantalla enseña el paso de recuento con la homografía correcta ya fijada, que es donde se ve el compromiso. Las cuatro parejas muy alejadas son los errores típicos del matching: dos ventanas iguales en fachadas repetidas, un reflejo y un punto en el cielo, donde no hay textura estable. Las dos parejas intermedias, a 4,5 y 7,5 px, son las que deciden si el umbral está bien puesto: entran al subirlo y arrastran error a la estimación. Con imágenes de verdad, el umbral se elige en píxeles de la imagen original, así que cambiar la resolución de captura obliga a revisarlo.
Reconstruyendo el mundo en 3D
Fotogrametría (SfM)
Al identificar y conectar puntos coincidentes en múltiples fotos de una escena, se puede reconstruir la geometría 3D del objeto y la posición de la cámara en cada toma.
SLAM (robótica)
Un robot utiliza el matching de características para comprender su posición dentro de un entorno y construir un mapa del mismo, incluso mientras se mueve y explora.
Panoramas (stitching)
Permite fusionar sin problemas varias imágenes superpuestas en una única foto de gran formato o una vista de 360 grados, eliminando duplicados y alineando las perspectivas.
Depth estimation: 3D desde una sola imagen
Depth Anything V2/V3
Un modelo fundacional entrenado con millones de imágenes etiquetadas y no etiquetadas, aprovechando la diversidad del mundo real.
Capacidad
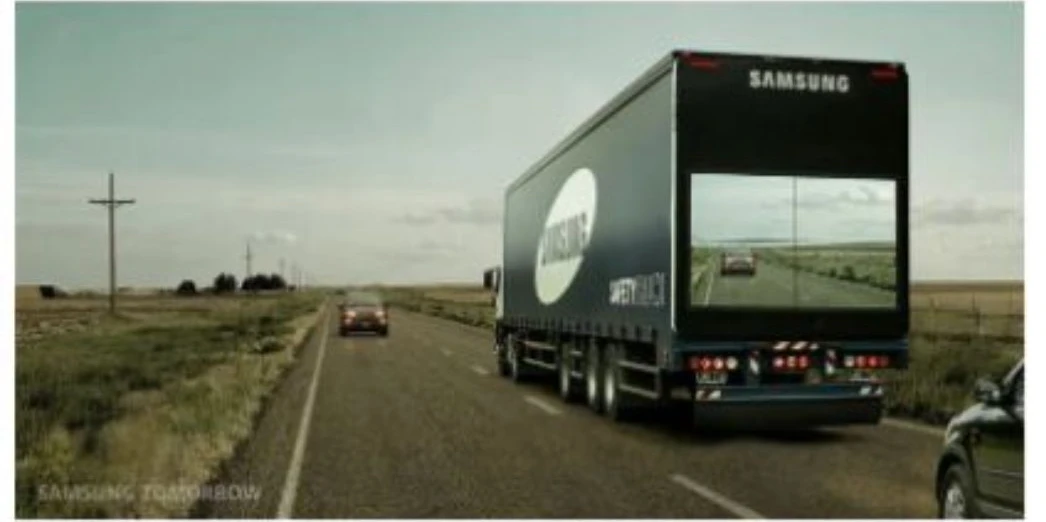
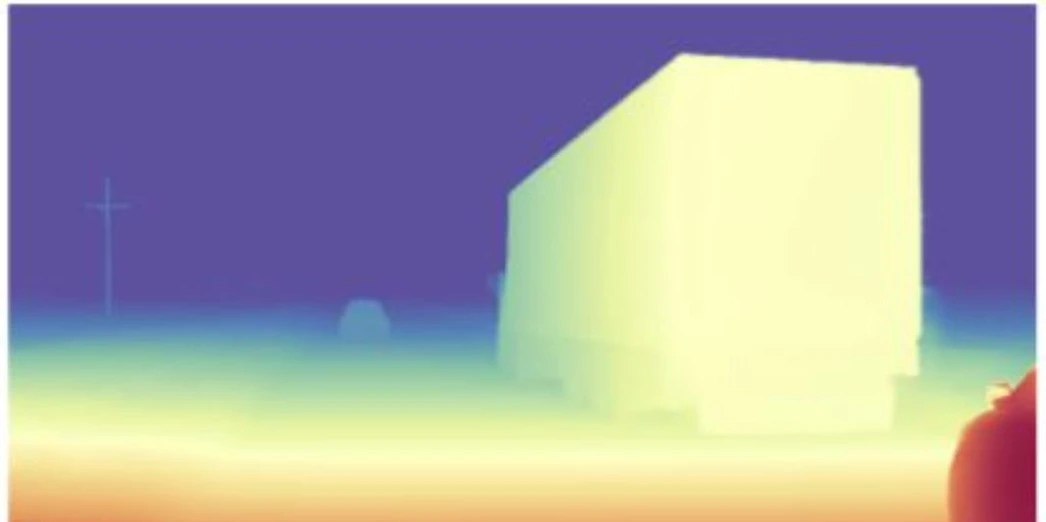
Genera un mapa de profundidad (heatmap) donde el color indica la distancia relativa, revelando la estructura 3D subyacente.
Robustez
Funciona en una gran variedad de escenarios: interiores complejos, exteriores dinámicos, y con elementos desafiantes como objetos transparentes o superficies reflejantes.
Aplicaciones depth
Efecto retrato (bokeh)
Desenfocar el fondo sintéticamente, creando imágenes con una profundidad de campo profesional y destacando el sujeto principal.
Robótica y navegación
Permitir que robots y vehículos autónomos detecten obstáculos y comprendan su entorno 3D, utilizando solo una cámara de bajo coste.
Generación de nubes de puntos
Convertir una foto plana en una estructura 3D navegable (malla o nube de puntos) al combinar la imagen RGB con su mapa de profundidad.
Filtro de imagen
Podemos eliminar partes de la imagen que no están en la escena que nos interesa aplicando un threshold.
Relativa no es métrica
Un mapa normalizado ordena distancias, pero no las mide.
Respuesta C. Exacto: necesitas un modelo métrico, calibración u otra referencia de escala.
Un mapa relativo dice qué está más cerca que qué. Para responder «a cuántos metros» hacen falta calibración de cámara, una referencia conocida o un modelo entrenado para profundidad métrica.
Las seis tareas, seis recetas
Lo mínimo para arrancar cada una. Todas siguen el mismo patrón de Transformers.
from transformers import pipeline
from PIL import Image

image = Image.open("mi_imagen.jpg").convert("RGB")

# 1. Pose: puntos clave del cuerpo
pose = pipeline("keypoint-detection", model="usyd-community/vitpose-base-simple")
print(pose(image))

# 2. OCR: texto de la imagen
ocr = pipeline("image-to-text", model="microsoft/trocr-base-printed")
print(ocr(image))

# 3. Superresolución: más detalle
sr = pipeline("image-to-image", model="caidas/swin2SR-classical-sr-x2-64")
sr(image).save("ampliada.png")

# 4. Fondo: recorte con canal alfa
fondo = pipeline("image-segmentation", model="briaai/RMBG-1.4")
fondo(image).save("sin_fondo.png")

# 5. Profundidad: distancia relativa
depth = pipeline("depth-estimation", model="depth-anything/Depth-Anything-V2-Small-hf")
depth(image)["depth"].save("profundidad.png")

# 6. Matching: correspondencias entre dos fotos
match = pipeline("keypoint-matching", model="ETH-CVG/lightglue_superpoint")
print(match([[Image.open("vista_1.jpg"), Image.open("vista_2.jpg")]]))Los identificadores corresponden a modelos publicados en Hugging Face a fecha de septiembre de 2026. La API de pipeline puede cambiar el nombre de alguna tarea entre versiones de transformers; si una falla, busca la tarea en la ficha del modelo. El cuaderno del tema ejecuta estas seis con imágenes de ejemplo y deja el encadenado como ejercicio.
Antes de usar cualquiera de estas seis
Seis comprobaciones comunes a tareas muy distintas.
- Sabes qué es medida y qué es generaciónPose y profundidad estiman; superresolución sintetiza. No se usan igual como evidencia.
- La licencia permite tu usoVarias de estas familias tienen restricciones comerciales. Compruébalo por modelo.
- La escala está resueltaSi necesitas metros, un mapa relativo no sirve: hace falta calibración o un modelo métrico.
- Probado con tus imágenesResolución, encuadre y calidad reales, no las fotos de la demo.
- Sin diagnóstico automáticoEn medicina o seguridad, revisión humana sobre la imagen original.
- Coste por imagen calculadoSi vas a procesar miles, mide tiempo y memoria antes de comprometerte.
Cinco tareas, un cuaderno
Pose, OCR, superresolución, fondo y profundidad sobre tus propias imágenes.
- Guarda una copia en Drive.
- Ejecuta cada tarea por separado.
- Combina dos pipelines y comenta el resultado.
Cada tarea es independiente: puedes ejecutar solo la que te interese. La ampliación consiste en encadenar dos pipelines, por ejemplo estimar profundidad y usar un umbral para recortar el fondo, o pasar un recorte con superresolución al OCR. Anota qué modelo, qué versión y qué error observas en cada paso.