Seis tareas más, cada una con su modelo fundacional. Es el tema extra: si no da tiempo a terminarlo en clase, queda para casa.
Identificar y localizar puntos clave del cuerpo humano o de objetos en imágenes y vídeos.
Extraer texto de imágenes y documentos, transformándolo en datos editables y buscables.
Mejorar la calidad y resolución de imágenes o vídeos, a menudo a partir de datos de baja resolución.
Segmentar y eliminar automáticamente el fondo de una imagen, aislando el objeto principal.
Calcular la distancia de los objetos en una escena respecto a la cámara, creando mapas de profundidad.
Encontrar correspondencias o similitudes entre dos o más imágenes para tareas como la localización o el reconocimiento.
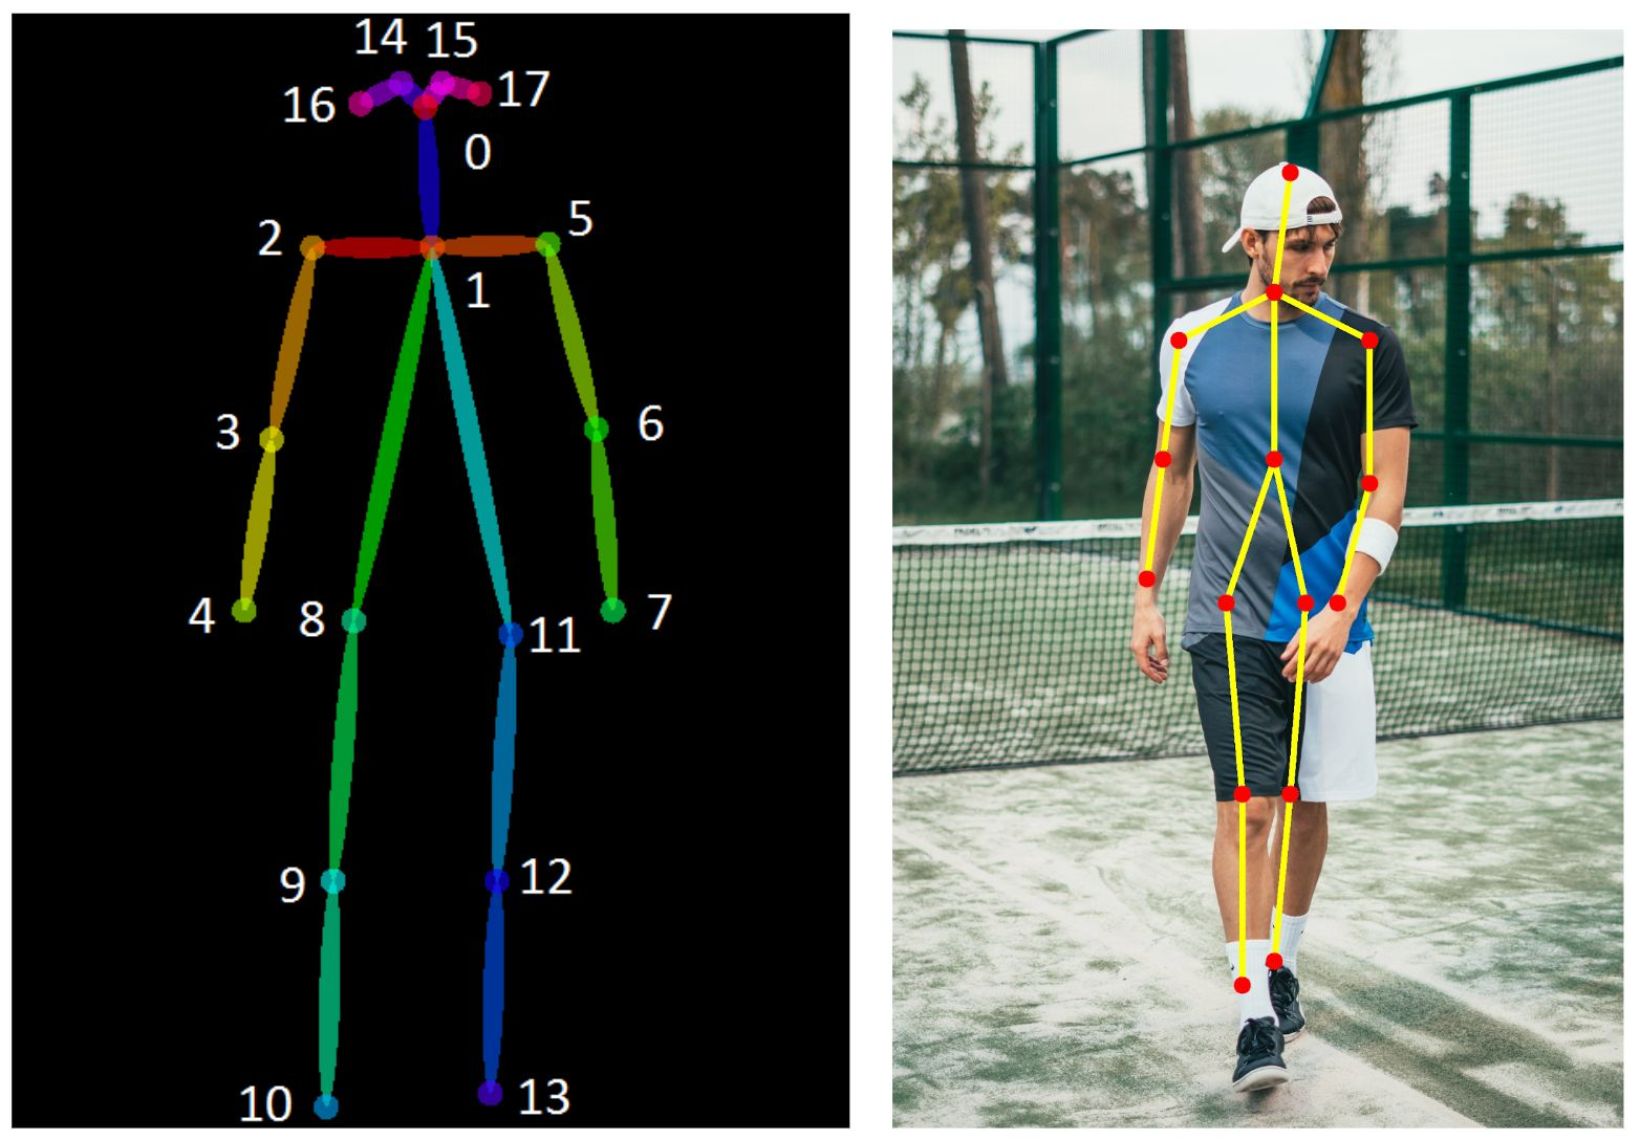
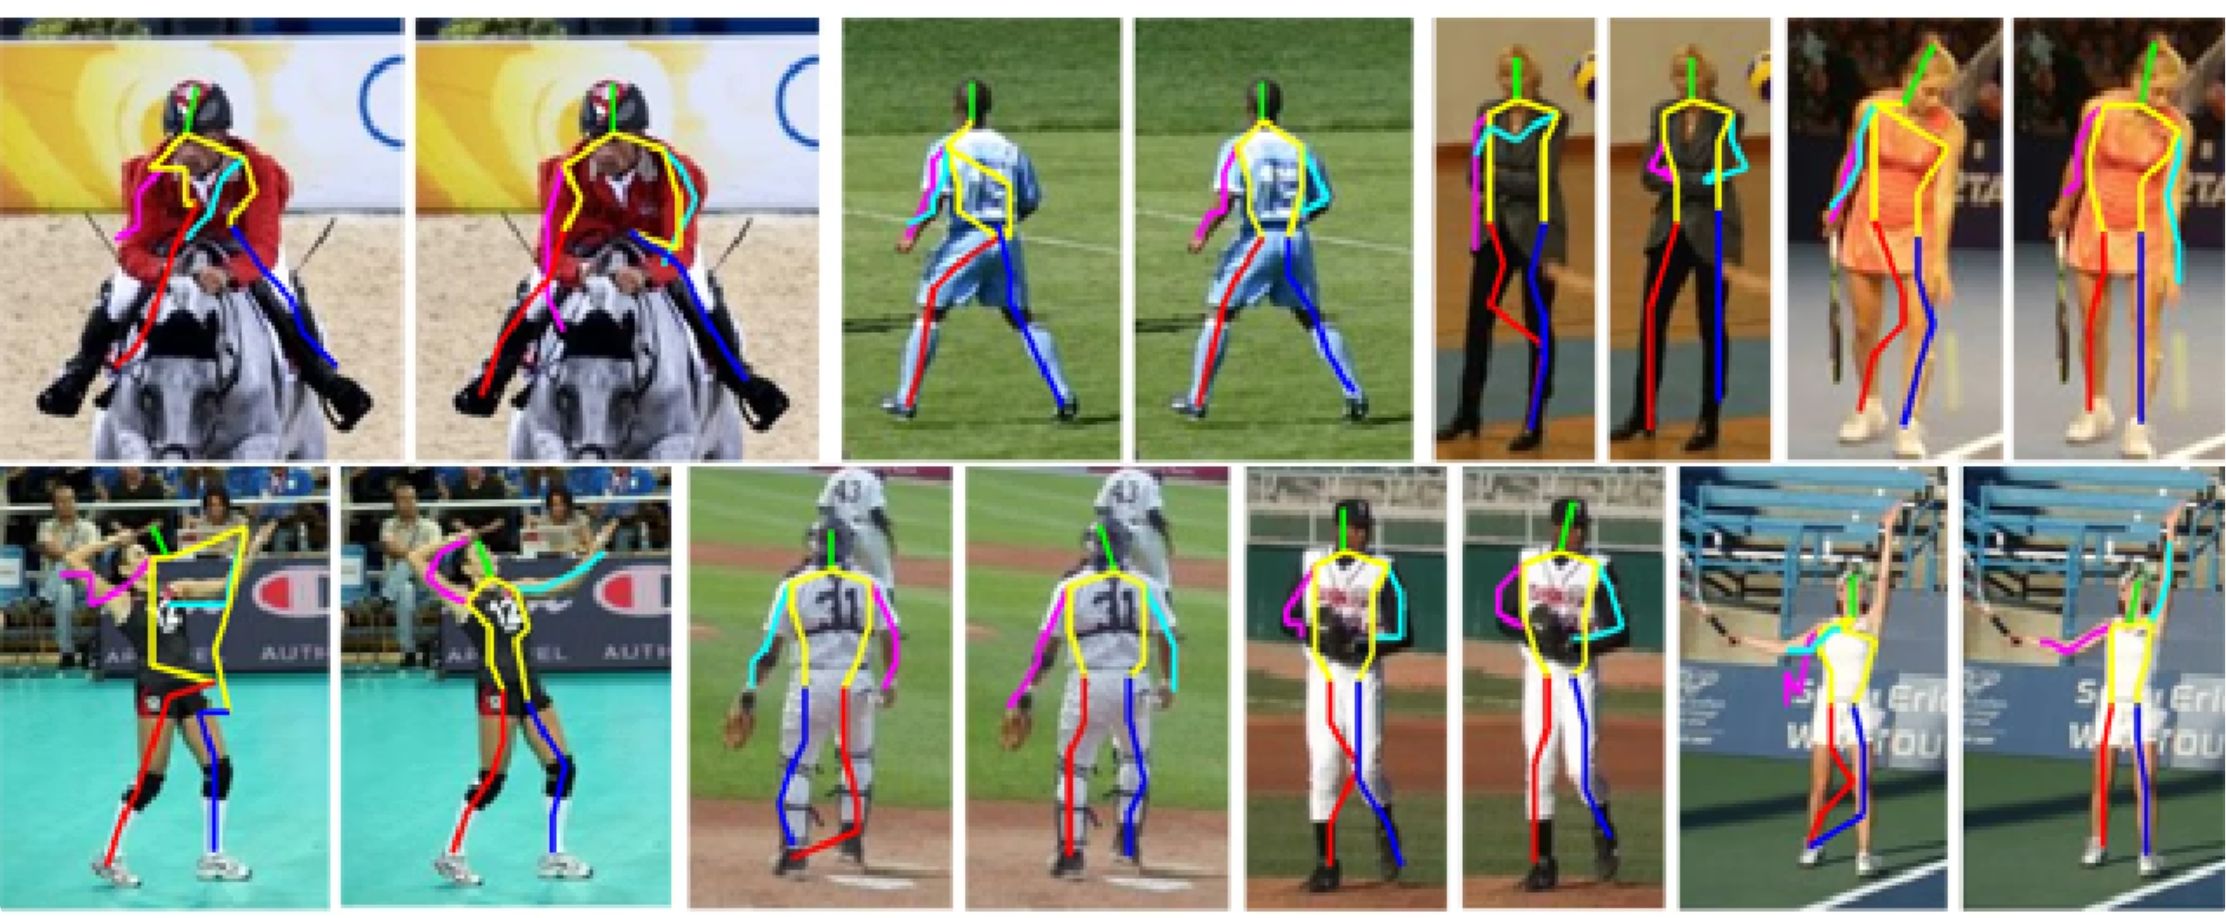
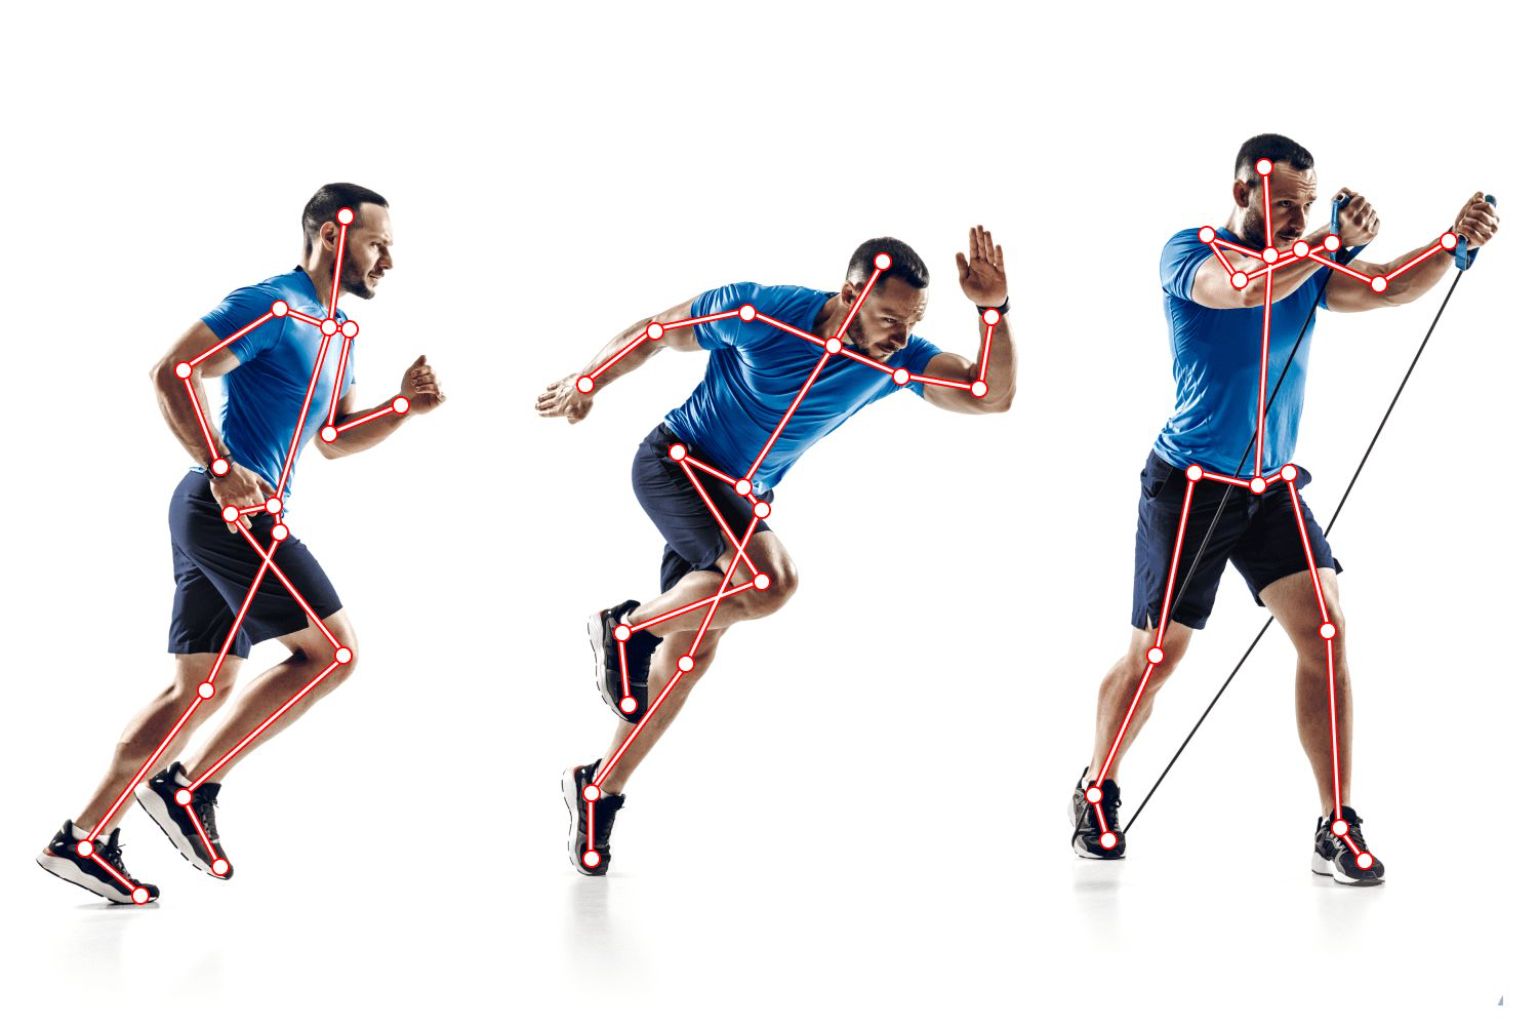
Localizar los puntos del cuerpo de cada persona: hombros, codos, rodillas…
¿Qué es? Tarea de visión que localiza articulaciones clave (keypoints) para modelar la postura y el movimiento.
El estándar (COCO-17): se buscan típicamente 17 puntos.
El output: una lista de coordenadas (x, y) más un score de confianza por punto.
Con esos puntos ya se pueden medir ángulos, contar repeticiones o detectar que alguien se ha caído.
Cuál conviene según cuánta gente haya en la imagen.
Proceso: primero detecta personas (cajas), luego estima la pose dentro de cada una.
Ejemplos: HRNet, ViTPose.
Proceso: detecta todos los puntos clave de la imagen a la vez, luego los agrupa en personas.
Ejemplo: OpenPose.
Proceso: redes como YOLO-Pose o RF-DETR Keypoint predicen cajas y puntos simultáneamente en una sola pasada (end-to-end).
Los que más vais a encontrar.
Funciona bien en CPU y en el móvil. Pensado para fitness, filtros AR y escenas con una o pocas personas cerca de la cámara. Tiene también modelos para manos y cara.
YOLOv8, YOLO11 y YOLO26 en versión pose: varias personas en una pasada, buen equilibrio entre velocidad y precisión y fáciles de reentrenar. Licencia AGPL-3.0, como el resto de Ultralytics (tema 1).
El pionero académico que estableció las bases. Aunque influyente, hoy en día es computacionalmente pesado en comparación con opciones más modernas.
Prioridad en precisión extrema. Cuando la exactitud es crítica (análisis médico, biomecánico) y la velocidad de inferencia es secundaria.
RF-DETR Keypoint (Roboflow, junio de 2026, Apache 2.0) es el detector del tema 1 con una salida más: cajas y 17 puntos en una pasada. Roboflow da 71,8 AP en COCO a 9,8 ms en una T4. Todavía es una versión preliminar y hay que instalarlo aparte, así que en el cuaderno va en el Extra. El principal es ViTPose, top-down: RT-DETR encuentra a las personas y ViTPose les pone los puntos.
OKS (Object Keypoint Similarity) hace con los esqueletos lo que IoU hace con las cajas: convierte la distancia entre cada punto predicho y el real en una puntuación de 0 a 1, corregida por el tamaño de la persona y por lo difícil que es marcar esa articulación.
Por eso el mismo error no penaliza igual: 5 píxeles de error en el ojo, que los anotadores marcan con mucha precisión, cuestan bastante más que 5 píxeles en la cadera, cuya posición exacta es más difícil de fijar.
La tolerancia de cada articulación sale de cómo de acuerdo se ponen los anotadores humanos.
Respuesta A. Exacto: cinco píxeles pesan más en una persona pequeña y en un punto fácil de marcar, como el ojo.
Las constantes por articulación se estimaron midiendo la dispersión entre anotadores. Donde las personas coinciden mucho, como los ojos, el modelo tiene menos margen.
Ejemplos en deporte, industria y salud.
El problema: la estimación de pose se complica cuando partes del cuerpo se ocultan entre sí o tras otros objetos, y se pierde información.
La solución: modelos avanzados emplean memoria temporal para rastrear y predecir oclusiones, o realizan inferencia 3D para "imaginar" las partes ocultas basándose en la anatomía y el contexto.
De Tesseract a TrOCR y los VLM.
Metodología: hasta la versión 3 segmentaba caracteres con reglas y contornos; desde la 4 (2018) reconoce líneas con una red LSTM, pero sigue necesitando texto limpio y horizontal.
Limitaciones comunes:
Arquitectura end-to-end: utiliza Vision Transformers (ViT) para codificar la imagen de forma global y un decoder de texto (en TrOCR, inicializado desde RoBERTa) genera la secuencia de caracteres.
Lo que cambia: lee la línea entera de una vez, con el contexto de las letras vecinas, en lugar de reconocer caracteres sueltos.
Estado del arte (SOTA):
EasyOCR, TrOCR y VLM.
Es ligera, soporta más de 80 idiomas y funciona eficientemente en CPU. Ideal para prototipos rápidos y escenarios donde no se dispone de GPU.
Muy preciso en texto impreso y en manuscrito, según la variante. Lee una sola línea ya recortada, así que necesita un detector de texto delante. Va mucho mejor con GPU.
Para facturas, tablas y formularios. Devuelven los datos ya ordenados, por ejemplo en JSON, en lugar de texto suelto, y pueden razonar sobre lo que leen.
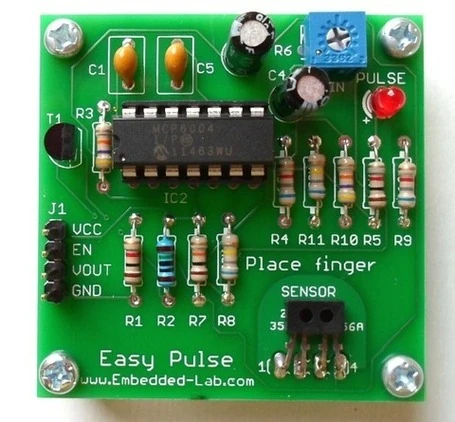
La misma foto de una placa, leída de tres formas. Cambia la herramienta y mira qué recibe tu programa.
Qué herramienta usas
C1 C5 R6 C4 PULSE
T1 R3 MCP6004
IC2 R4 R11 R10 R5 R9
J1 VCC EN VOUT GND
R1 R2 R7 R8
Place finger SENSOR
Easy Pulse
www.Embedded-Lab.com
texto posición tamaño
PULSE (357, 70) 44 x 13
MCP6004 (163, 122) 47 x 16
IC2 (161, 189) 36 x 18
VCC ( 71, 221) 36 x 19
GND ( 71, 283) 38 x 19
R1 (126, 317) 25 x 16
Place finger (250, 252) 120 x 26
SENSOR (282, 281) 55 x 19
Easy Pulse (103, 344) 135 x 34
www.Embedded-Lab.com ( 82, 378) 175 x 23
{
"placa": "Easy Pulse",
"fabricante": "www.Embedded-Lab.com",
"integrado": "MCP6004",
"conector": {
"referencia": "J1",
"pines": ["VCC", "EN", "VOUT", "GND"]
},
"sensor": {
"etiqueta": "SENSOR",
"instruccion": "Place finger"
},
"resistencias": ["R1", "R2", "R3", "R4", "R5", "R6",
"R7", "R8", "R9", "R10", "R11"]
}
Sale una tira de texto sin posiciones: ves "R1 R2 R7 R8", pero no sabes qué resistencia es cada una ni dónde está en la placa.
La pregunta útil es qué necesita tu programa, más que qué herramienta lee mejor. Para contar si la serigrafía está impresa basta la primera; para comprobar que cada referencia está junto a su componente hacen falta coordenadas; para rellenar un parte de recepción con el modelo y el fabricante, el VLM devuelve directamente los campos que necesitas.
Las cajas de esta pantalla están medidas a mano sobre la foto para ilustrar el formato de salida, no las ha producido un OCR. Tres cosas que se ven en esta imagen y que aparecen en cualquier planta: el texto de la serigrafía es de bajo contraste sobre verde y el brillo del cobre lo rompe, hay texto a distintas escalas en la misma foto, y varias referencias quedan parcialmente tapadas por los componentes. Por eso la resolución de captura manda más que el modelo: con menos de veinte píxeles de altura por carácter, ningún OCR actual lee de forma fiable. Sobre latencia y coste, Tesseract corre en CPU en decenas de milisegundos, un modelo de detección más reconocimiento ronda las décimas de segundo en GPU, y un VLM se va a varios segundos por imagen, así que en línea suele combinarse: detección rápida siempre y VLM solo sobre las piezas dudosas.
Ampliar una imagen generando el detalle que falta, con mejor resultado que la interpolación bicúbica.
El modelo del cuaderno: Swin2SR (2022).
Ojo: el modelo "imagina" detalles a partir de los patrones que vio al entrenar; no reconstruye información que nunca existió.
Dónde se usa.
Riesgo: el modelo puede inventar una mancha que no existe. En diagnóstico, siempre con revisión humana.
Lo que aparece al ampliar puede venir del modelo, no del sensor.
Respuesta B. Exacto: la mejora visual no convierte el detalle generado en evidencia.
La superresolución sintetiza textura plausible a partir de patrones aprendidos. En un contexto diagnóstico, cualquier estructura nueva debe comprobarse sobre la imagen original.
Lo difícil son los bordes: pelo, pelaje y cristal.
Segmentar objetos sólidos es fácil. Pero elementos como el pelo, el pelaje o el vidrio transparente son extremadamente difíciles de separar debido a sus bordes difusos y semitransparentes.
Segmenta el objeto principal y devuelve una máscara con valores graduales en los bordes, que se usa como canal alfa en lugar de una máscara binaria, así que el recorte encaja en cualquier fondo sin efecto "pegatina". Su licencia no permite uso comercial sin acuerdo con BRIA.
Métodos para encontrar el mismo punto en dos imágenes.
¿Qué es? Encontrar puntos idénticos en dos fotos de la misma escena tomadas desde ángulos diferentes, a pesar de cambios en la perspectiva o la iluminación. Es la base de la reconstrucción 3D, la realidad aumentada y la localización de robots.
Una red que localiza los puntos más distintivos de la imagen (esquinas, texturas) y describe cada uno con un vector. Aguanta mejor que SIFT los cambios fuertes de luz y de punto de vista.
Un Transformer que compara los puntos de las dos imágenes, decide cuáles se corresponden y descarta los que no tienen pareja. Los errores geométricos que se le escapan se filtran después comprobando la geometría (RANSAC).
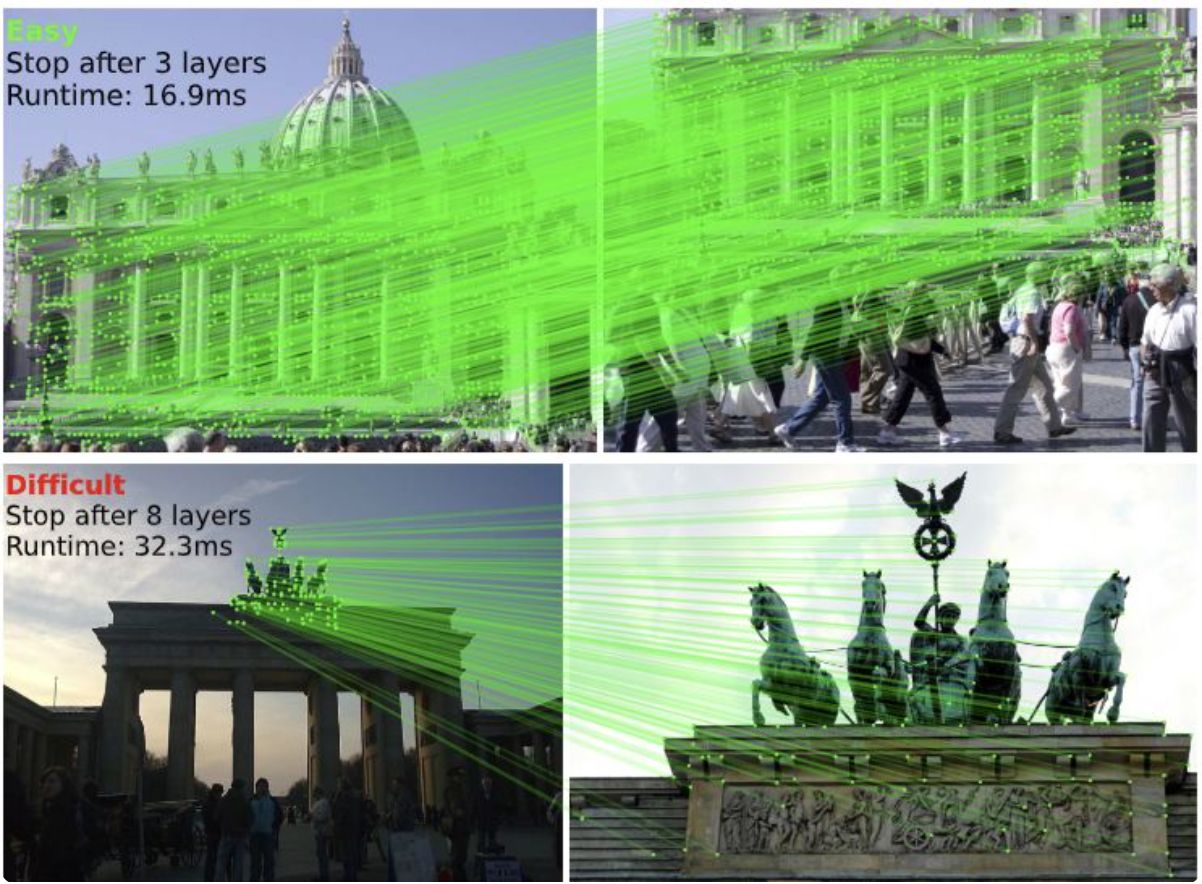
Dónde se nota: con cambios de luz (de día a noche), grandes variaciones de perspectiva y oclusiones, justo donde los métodos clásicos fallan más.
Gira y mueve la segunda foto. Las líneas unen los puntos que el matching empareja, y con esas parejas se calcula el giro.
Parejas encontradas10
Giro calculado20,0°
El modelo de matching solo da parejas de puntos. El giro y el desplazamiento salen de una cuenta sobre esas parejas: se busca el giro que mejor lleva los puntos de la primera foto a los de la segunda. Con dos parejas buenas ya se puede calcular, y con más el resultado es más estable aunque cada punto tenga un poco de error. Esta pantalla simula las parejas sobre la misma foto; un modelo como LightGlue las encuentra en fotos distintas de verdad.
Tres usos habituales.
Al identificar y conectar puntos coincidentes en múltiples fotos de una escena, se puede reconstruir la geometría 3D del objeto y la posición de la cámara en cada toma.
Un robot utiliza el matching de características para comprender su posición dentro de un entorno y construir un mapa del mismo, incluso mientras se mueve y explora.
Permite fusionar sin problemas varias imágenes superpuestas en una única foto de gran formato o una vista de 360 grados, eliminando duplicados y alineando las perspectivas.
Qué está cerca y qué está lejos, con una cámara normal.
Un modelo fundacional con encoder DINOv2. La V2 se entrenó con 595.000 imágenes sintéticas etiquetadas y 62 millones de imágenes reales con pseudoetiquetas.
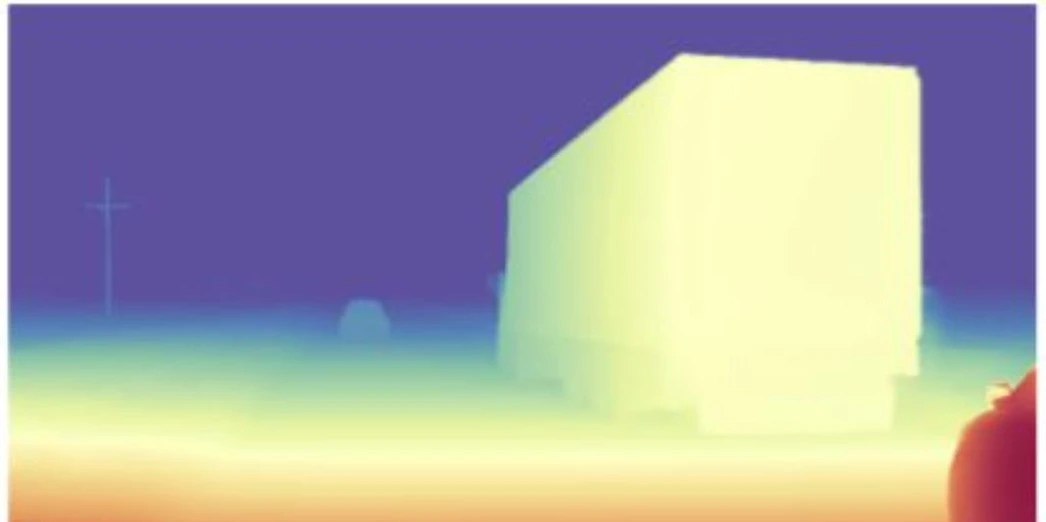
Genera un mapa de profundidad (heatmap) donde el color indica la distancia relativa, revelando la estructura 3D subyacente.
Aguanta interiores, exteriores y escenas con mucho detalle. Cristales y espejos, que hacían fallar a la V1, los maneja mucho mejor gracias a los datos sintéticos; aun así, compruébalo con tus imágenes.
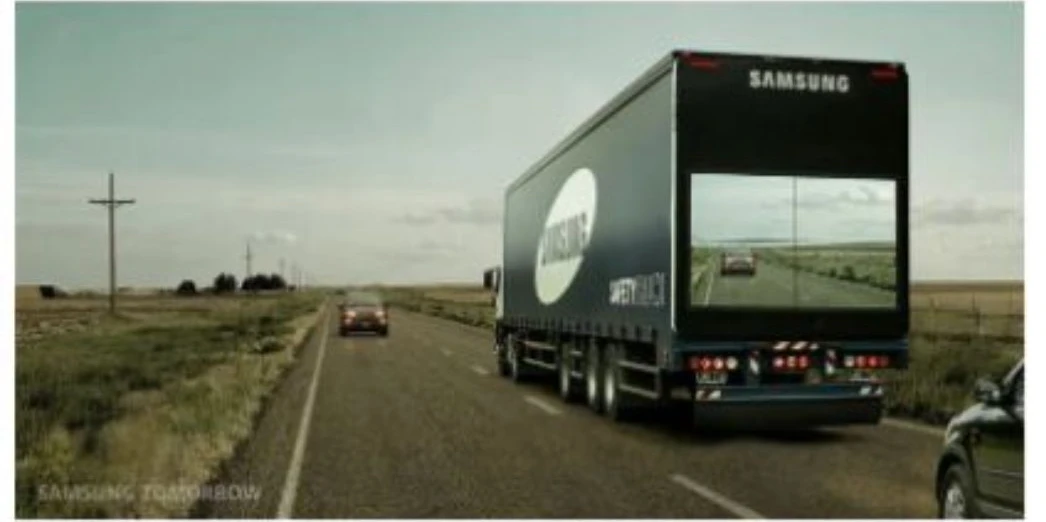
El mapa de profundidad de la pantalla anterior, usado como filtro: todo lo que queda más lejos que el corte se aclara. No hacen falta clases ni etiquetas: basta un umbral sobre la cercanía.
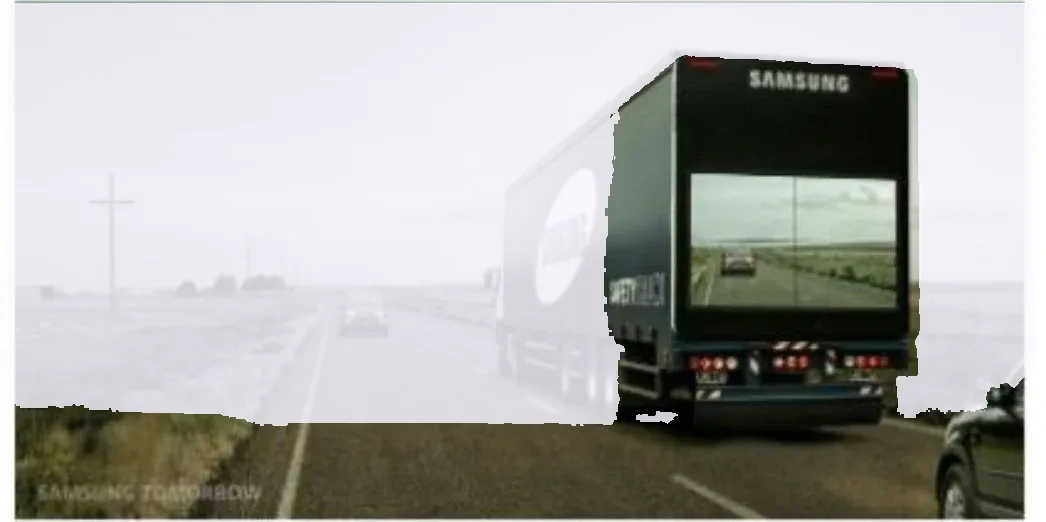
Imagen que se conserva42 %
Queda la trasera del camión, y la pantalla que muestra otra carretera sigue entera: el modelo le da la distancia del camión aunque enseñe una carretera lejana.
Mapa precalculado, el de la pantalla anterior; el corte se aplica en tu navegador. La escala es relativa: 100 no equivale a ninguna distancia en metros.
Esta página recoge el corte en 100 de 255, que conserva el 42 % de la imagen: la trasera del camión, el asfalto cercano y el coche de la derecha. El costado del camión se aleja de la cámara y queda fuera. La pantalla trasera, que muestra la carretera de delante, se conserva entera porque el modelo mide a qué distancia está la superficie de la pantalla; la carretera que aparece en ella no cuenta. Con el corte en 30 solo desaparece el cielo; desde 130 el camión entero queda al otro lado.
¿Para qué sirve un mapa de profundidad?
Desenfocar el fondo sintéticamente, creando imágenes con una profundidad de campo profesional y destacando el sujeto principal.
Permitir que robots y vehículos autónomos detecten obstáculos y comprendan su entorno 3D, utilizando solo una cámara de bajo coste.
Convertir una foto plana en una estructura 3D navegable (malla o nube de puntos) al combinar la imagen RGB con su mapa de profundidad.
Un umbral sobre el mapa elimina lo que queda más lejos (o más cerca) de lo que interesa, sin clases ni etiquetas.
Profundidad relativa vs. métrica. Estos modelos suelen estimar profundidad relativa (mapas de calor). Para obtener metros reales se necesita calibración de cámara o un modelo de profundidad métrica; Depth Anything V2 tiene variantes métricas para interior y exterior.
Un mapa normalizado ordena distancias, pero no las mide.
Respuesta C. Exacto: un mapa relativo ordena distancias, pero no las mide.
Un mapa relativo dice qué está más cerca que qué. Para responder "a cuántos metros" hacen falta calibración de cámara, una referencia conocida o un modelo entrenado para profundidad métrica.
Los mismos modelos, combinados de otra manera, resuelven problemas muy distintos. Lo que cambia de un sector a otro es qué hay que vigilar.
Detectar y seguir personas y vehículos, contar los que entran en una zona, avisar de una caída con la pose. RF-DETR con un seguidor (tema 1) y ViTPose o RF-DETR Keypoint (este tema).
Ojo: el Reglamento europeo de IA prohíbe desde febrero de 2025, salvo excepciones tasadas, la identificación biométrica remota en tiempo real en espacios públicos con fines policiales y el reconocimiento de emociones en el trabajo.
Defectos sin ejemplos de defecto, conteo de piezas, lectura de lotes y etiquetas, medidas con máscaras. DINOv3 con banco de normalidad (tema 4), SAM (tema 5) y OCR (este tema).
Ojo: luz y encuadre estables, y un umbral fijado con piezas buenas.
Saber qué está cerca con una sola cámara, recortar el objeto que hay que coger, encontrar objetos nuevos por su nombre. Depth Anything (este tema), SAM 2 (tema 5) y Grounding DINO (tema 3).
Ojo: esta profundidad es relativa; para coger un objeto hacen falta metros.
Vehículos, peatones y señales, la calzada separada del resto, distancias y matrículas. Detectores en tiempo real (tema 1), segmentación (tema 5), profundidad y OCR (este tema).
Ojo: tiempo real en el hardware del coche, y noche, lluvia y contraluz en los datos de validación.
Las prohibiciones del artículo 5 del Reglamento (UE) 2024/1689 se aplican desde el 2 de febrero de 2025. Entre ellas están la identificación biométrica remota en tiempo real en espacios de acceso público con fines policiales, salvo excepciones tasadas, y el reconocimiento de emociones en el lugar de trabajo y en centros educativos, salvo por motivos médicos o de seguridad. Contar personas sin identificarlas no entra en esas prohibiciones, pero sigue sujeto al RGPD. Para la profundidad métrica hace falta un modelo entrenado para ello, una cámara estéreo o calibración.
Seis comprobaciones comunes a tareas muy distintas.
Seis tareas, cada una por separado. Si no da tiempo a todas, el resto queda para casa.
En Colab: Archivo, Guardar una copia en Drive, y Entorno de ejecución, GPU T4.